Zookeeper学习笔记(二) 架构解析

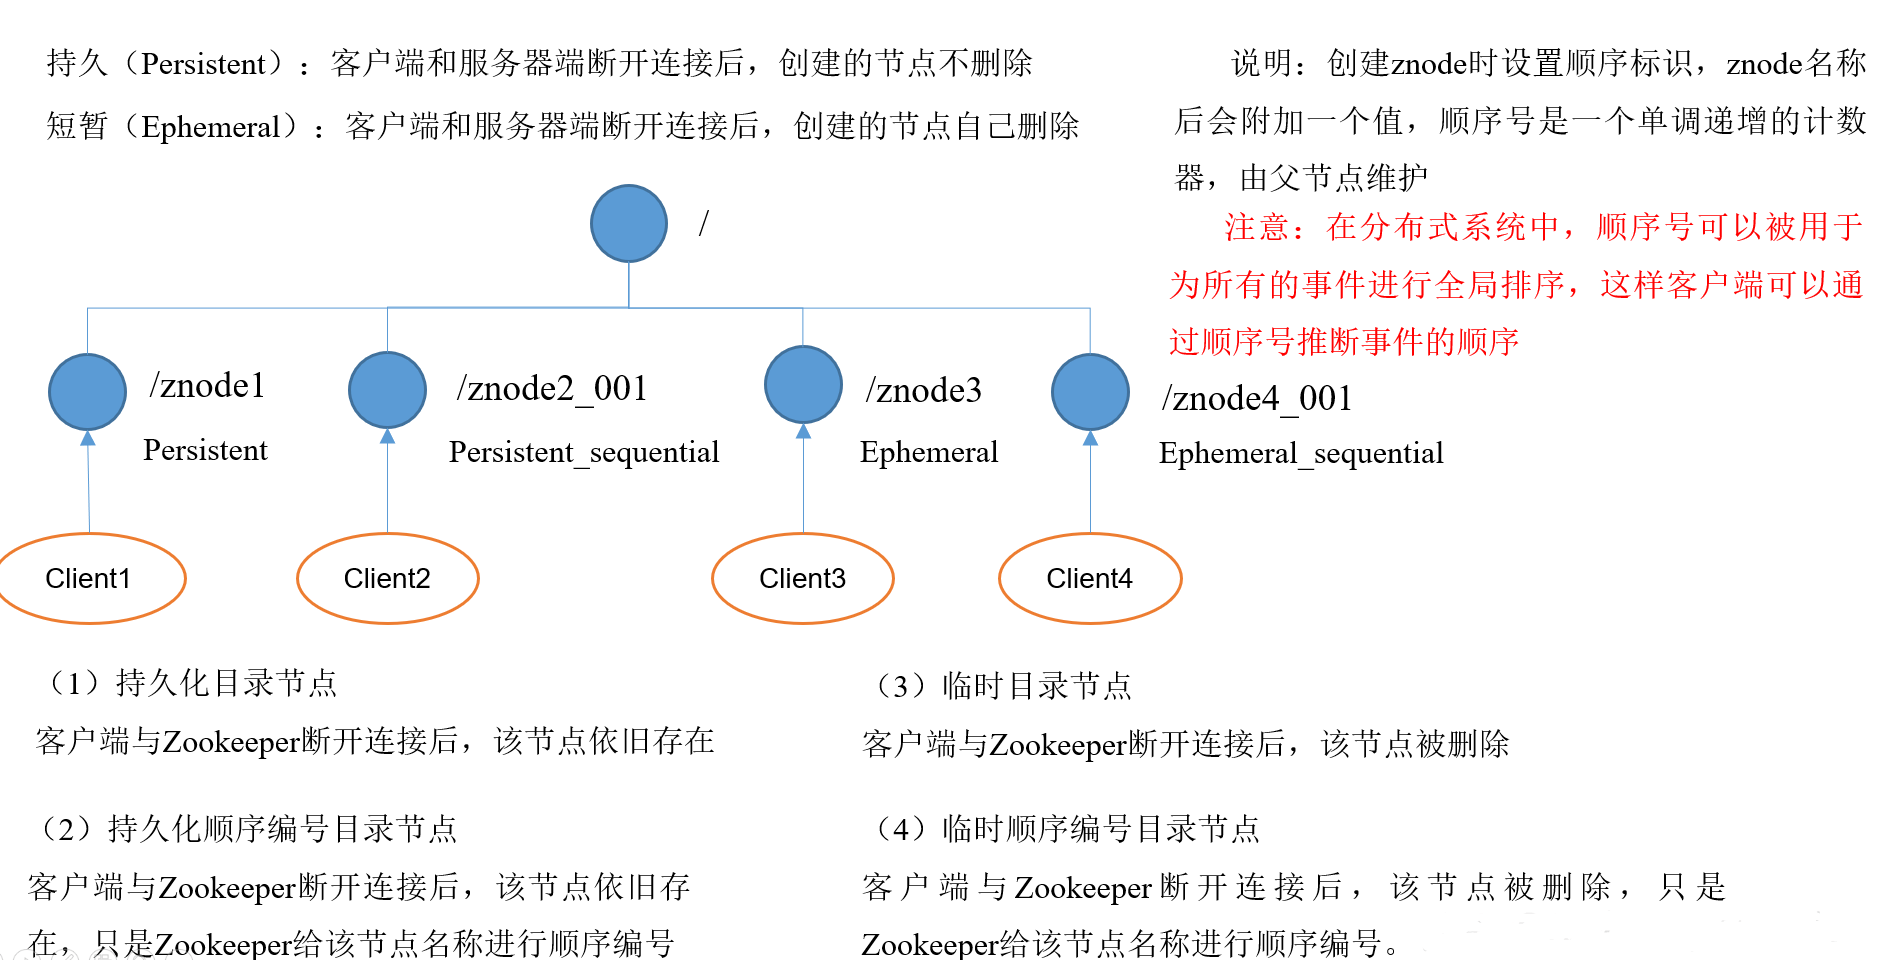
1 节点类型

​ 1638340173624

2 Stat结构体

(1)czxid-创建节点的事务zxid

每次修改ZooKeeper状态都会收到一个zxid形式的时间戳,也就是ZooKeeper事务ID。

事务ID是ZooKeeper中所有修改总的次序。每个修改都有唯一的zxid,如果zxid1小于zxid2,那么zxid1在zxid2之前发生。

(2)ctime - znode被创建的毫秒数(从1970年开始)

(3)mzxid - znode最后更新的事务zxid

(4)mtime - znode最后修改的毫秒数(从1970年开始)

(5)pZxid-znode最后更新的子节点zxid

(6)cversion - znode子节点变化号,znode子节点修改次数

(7)dataversion - znode数据变化号

(8)aclVersion - znode访问控制列表的变化号

(9)ephemeralOwner- 如果是临时节点,这个是znode拥有者的session id。如果不是临时节点则是0。

(10)dataLength- znode的数据长度

(11)numChildren - znode子节点数量

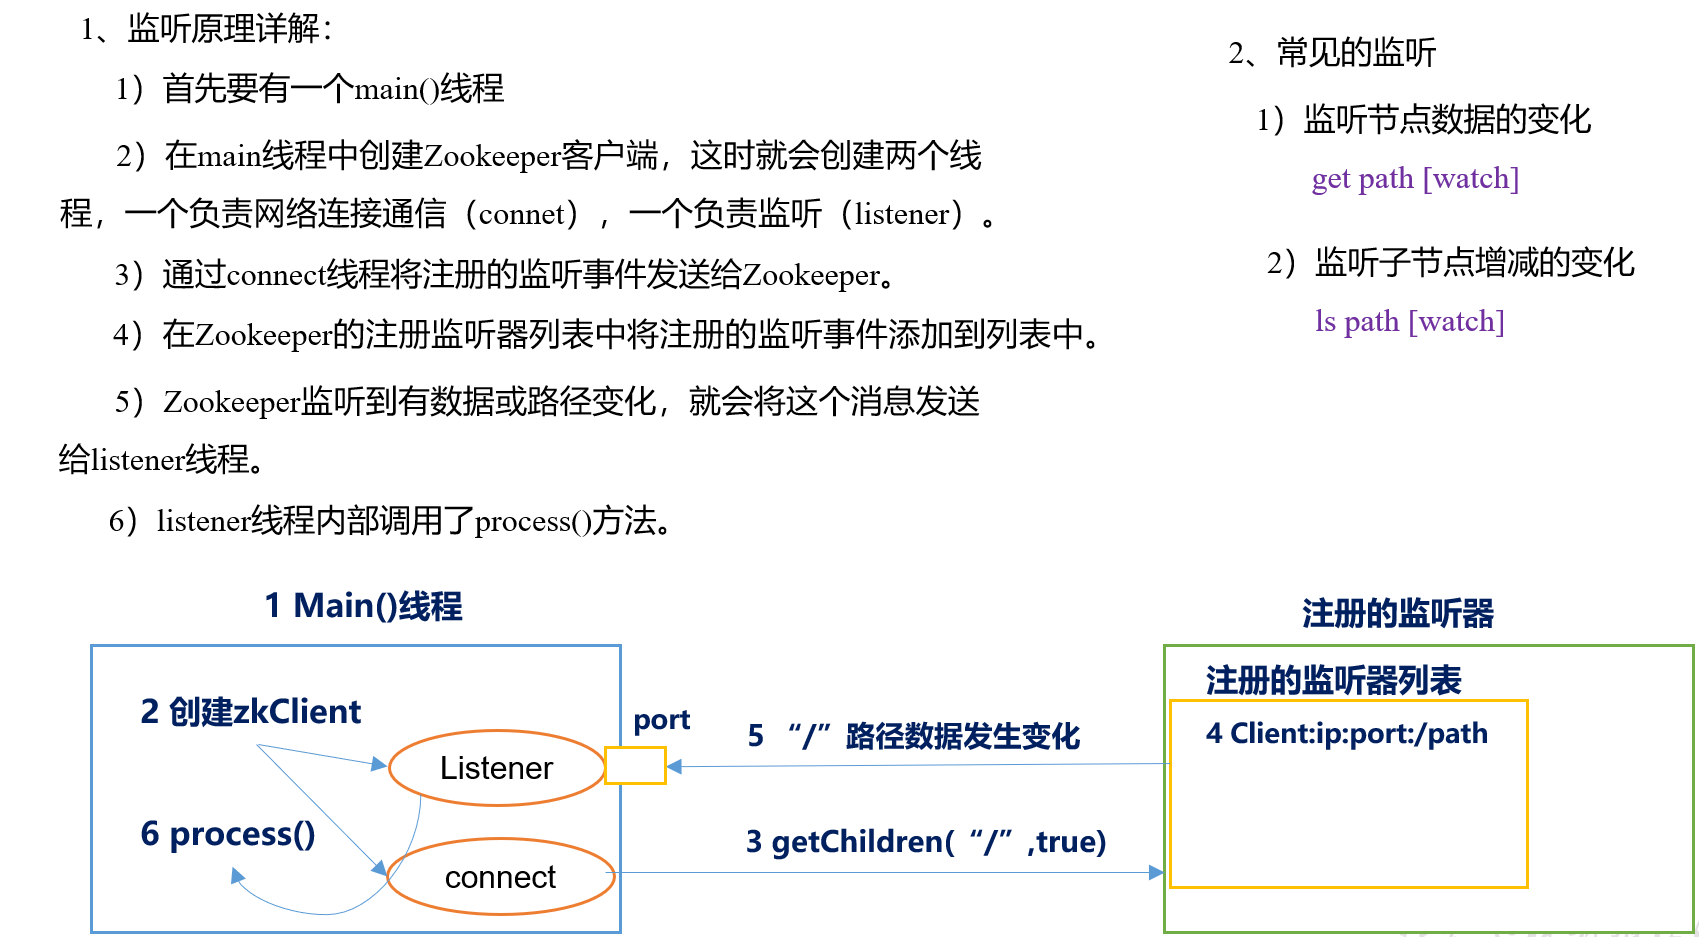
3 监听器原理(面试重点)

1638340203888

4 选举机制(面试重点)

(1)半数机制:集群中半数以上机器存活,集群可用。所以Zookeeper适合安装奇数台服务器。

(2)Zookeeper虽然在配置文件中并没有指定Master和Slave。但是,Zookeeper工作时,是有一个节点为Leader,其他则为Follower,Leader是通过内部的选举机制临时产生的。

(3)以一个简单的例子来说明整个选举的过程。

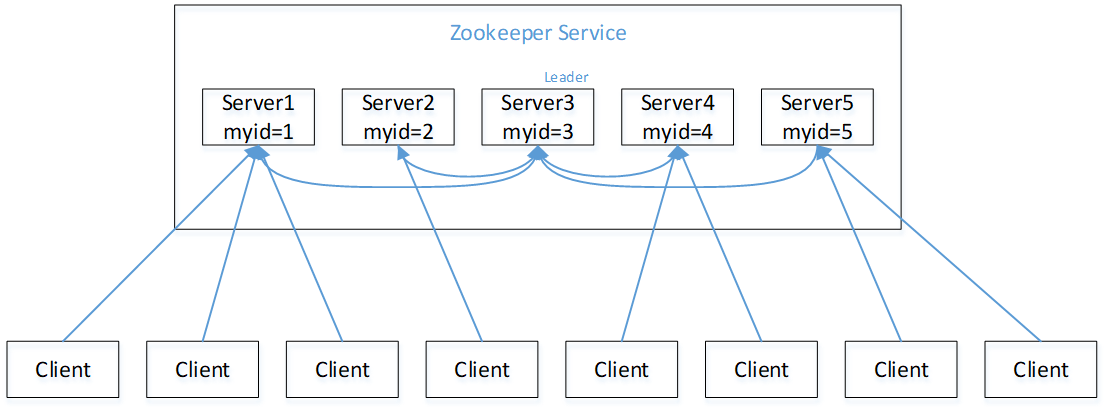
假设有五台服务器组成的Zookeeper集群,它们的id从1-5,同时它们都是最新启动的,也就是没有历史数据,在存放数据量这一点上,都是一样的。假设这些服务器依序启动,来看看会发生什么。

1638340230133

Zookeeper的选举机制

(1)服务器1启动,发起一次选举。服务器1投自己一票。此时服务器1票数一票,不够半数以上(3票),选举无法完成,服务器1状态保持为LOOKING;

(2)服务器2启动,再发起一次选举。服务器1和2分别投自己一票并交换选票信息:此时服务器1发现服务器2的ID比自己目前投票推举的(服务器1)大,更改选票为推举服务器2。此时服务器1票数0票,服务器2票数2票,没有半数以上结果,选举无法完成,服务器1,2状态保持LOOKING

(3)服务器3启动,发起一次选举。此时服务器1和2都会更改选票为服务器3。此次投票结果:服务器1为0票,服务器2为0票,服务器3为3票。此时服务器3的票数已经超过半数,服务器3当选Leader。服务器1,2更改状态为FOLLOWING,服务器3更改状态为LEADING;

(4)服务器4启动,发起一次选举。此时服务器1,2,3已经不是LOOKING状态,不会更改选票信息。交换选票信息结果:服务器3为3票,服务器4为1票。此时服务器4服从多数,更改选票信息为服务器3,并更改状态为FOLLOWING;

(5)服务器5启动,同4一样当小弟。

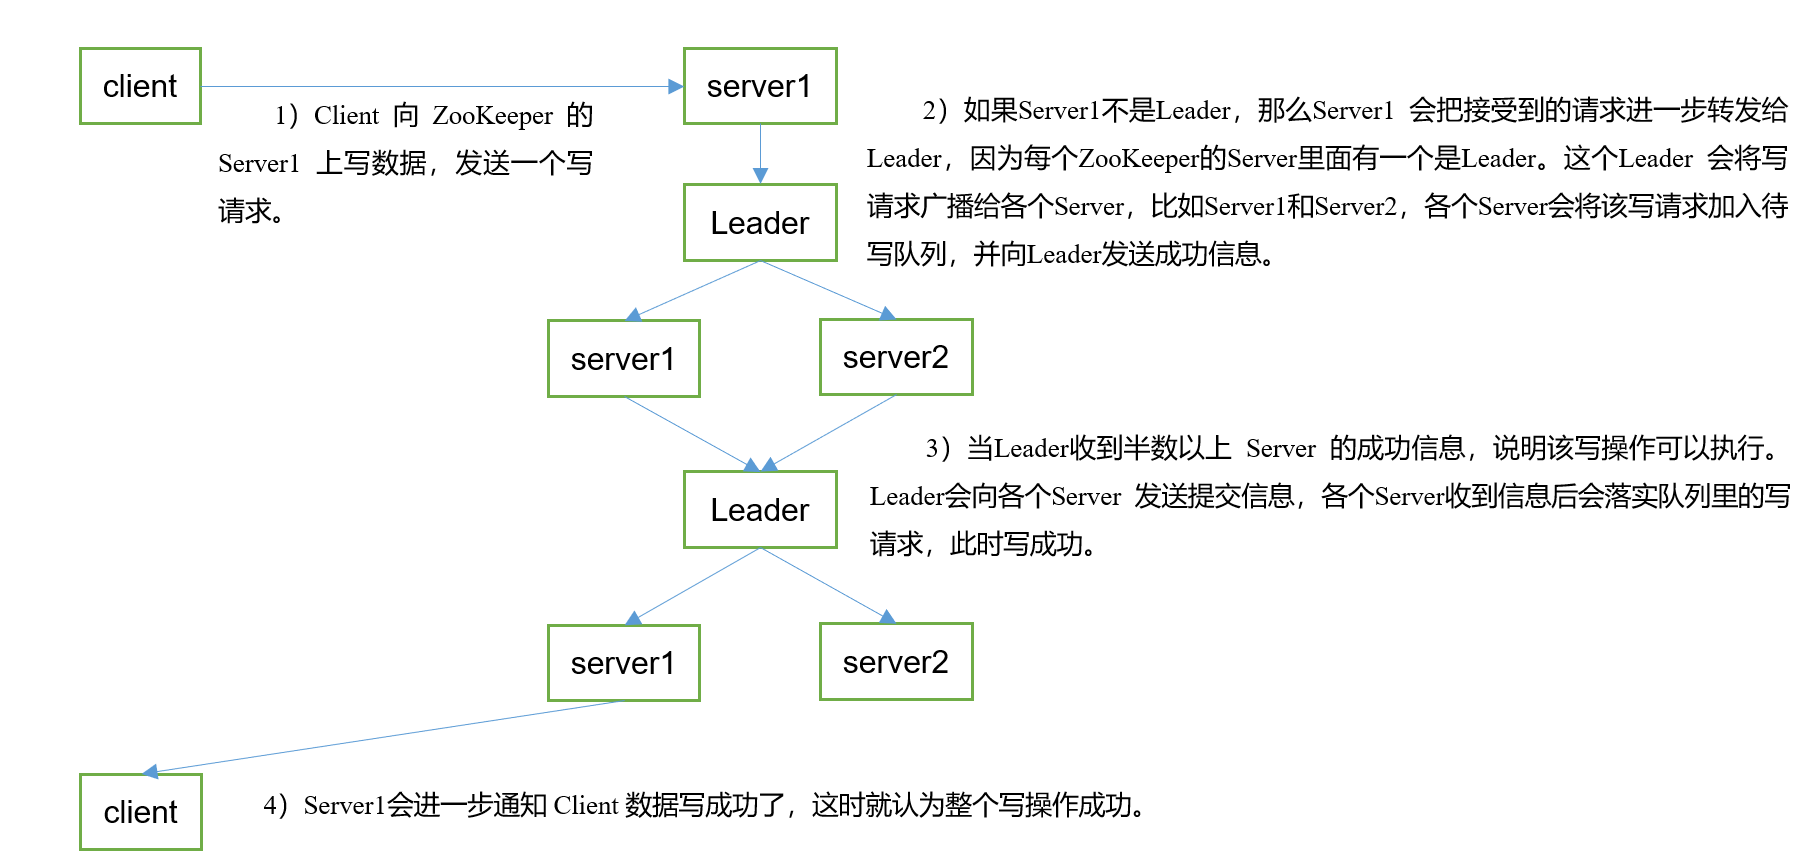
5 写数据流程

1638340252879

Zookeeper学习笔记(一) 搭建教程

1 Zookeeper入门

1.1 概述

Zookeeper是一个开源的分布式的,为分布式应用提供协调服务的Apache项目。

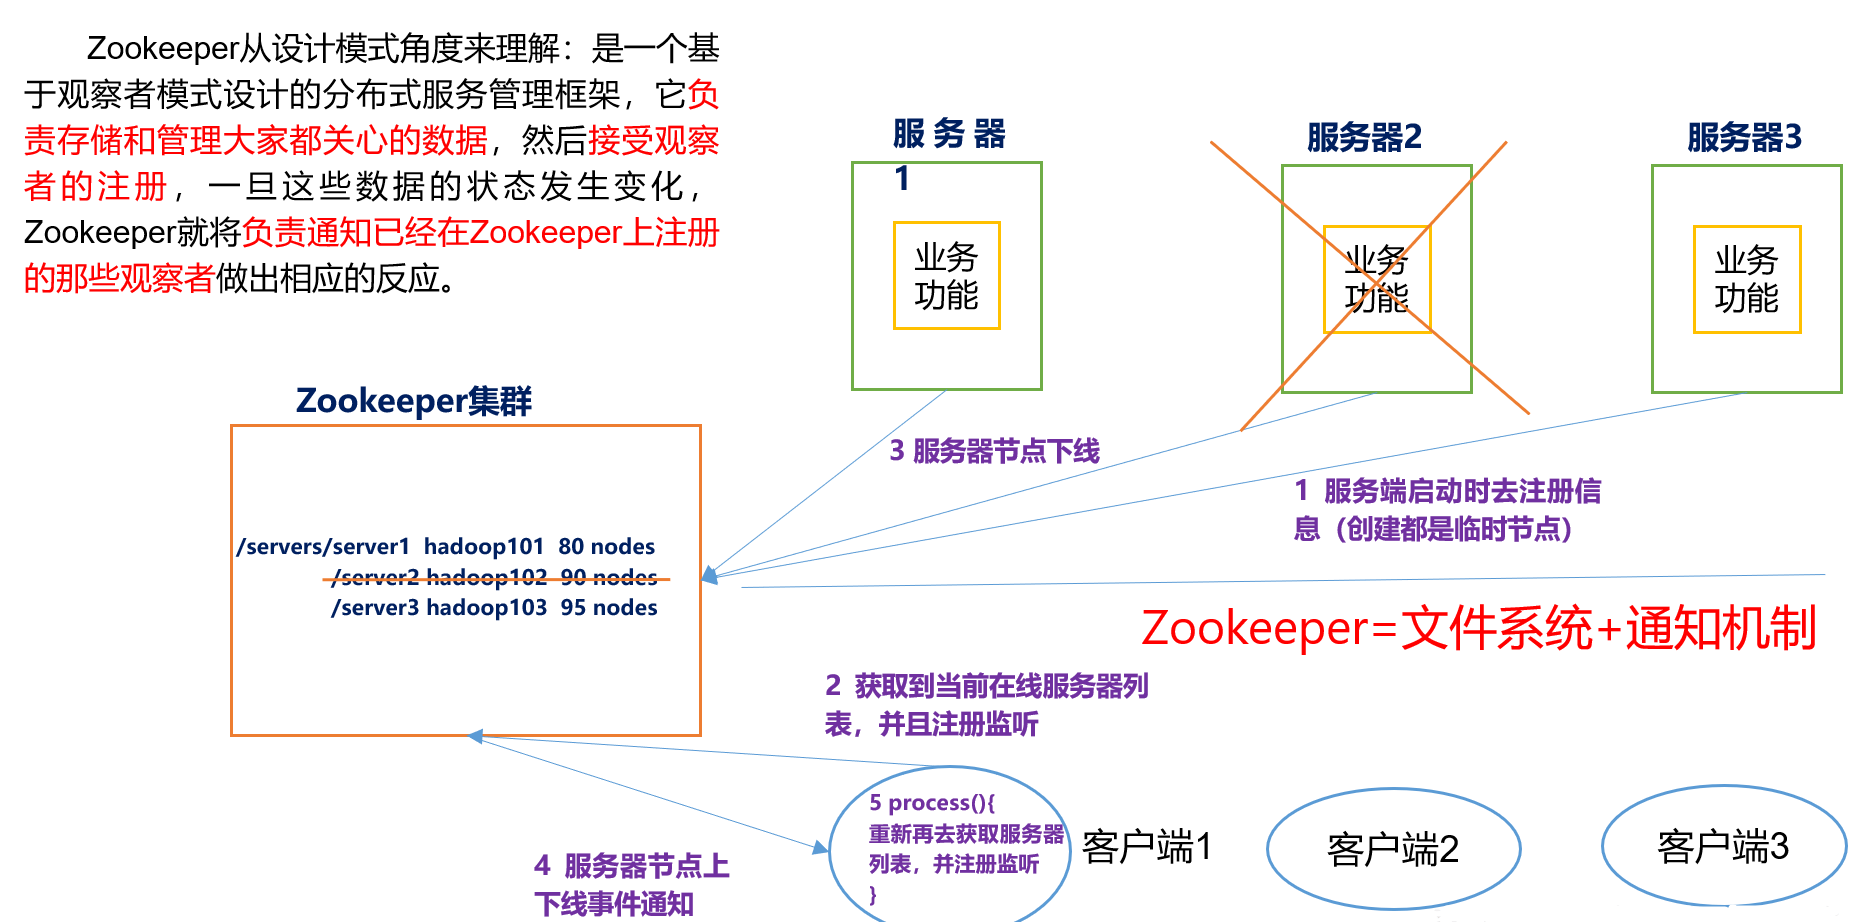
Zookeeper从设计模式角度来理解,是一个基于观察者模式设计的分布式服务管理框架,它负责存储和管理大家都关心的数据,然后接受观察者的注册,一旦这些数据的状态发生了变化,Zookeeper就负责通知已经在Zookeeper上注册的那些观察者做出相应的反应.

Zookeeper = 文件系统 + 通知机制

​ 1638329279116

1.2 特点

1638329307358

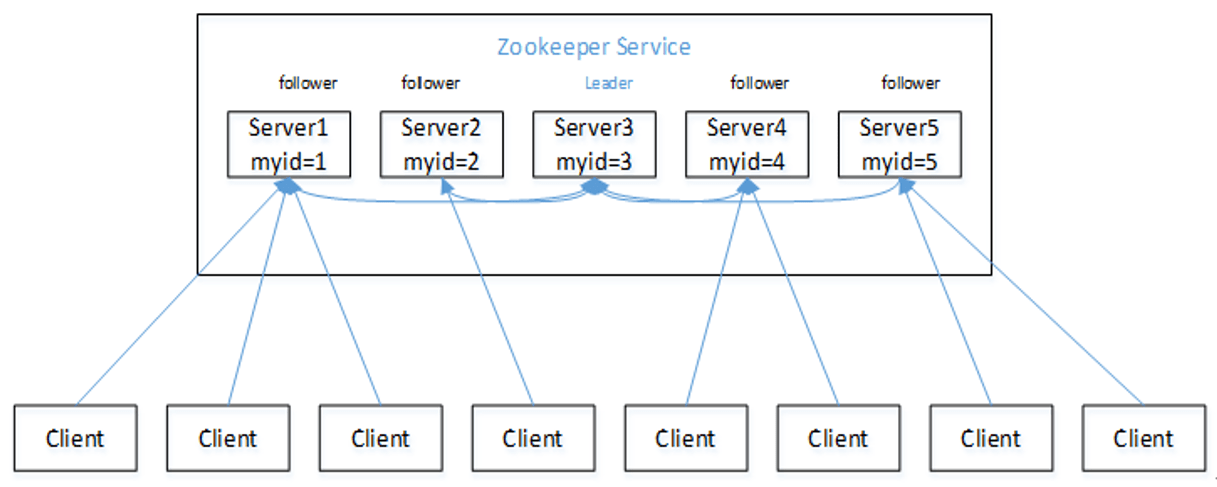
(1)zookeeper:一个领导者(leader),多个跟随者(Followers)组成的集群。

(2)集群中只要又半数以上节点存货,zookeeper集群就能正常服务。

(3)全局数据一致性,每个server保存一份相同的数据副本,client无论连接到哪里,数据都是一致的。

(4)更新请求顺序进行,来自同一个client的更新请求按其发送顺序依次执行。

(5)数据更新原子性,一次数据更新要么成功,要么失败。

(6)实时性:在一定时间范围内,client能读到最新数据

1.3 数据结构

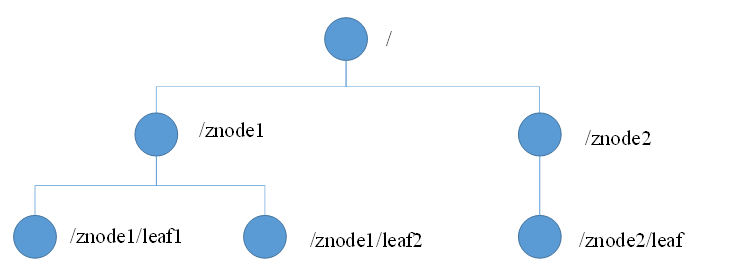
ZooKeeper数据模型与Unix文件系统很类似,整体上可以看作是一棵树,每个节点称作一个ZNode。每个ZNode默认能够存储1MB的数据,每个ZNode都可以通过其路径唯一标识。

1638329609040

1.4 应用场景

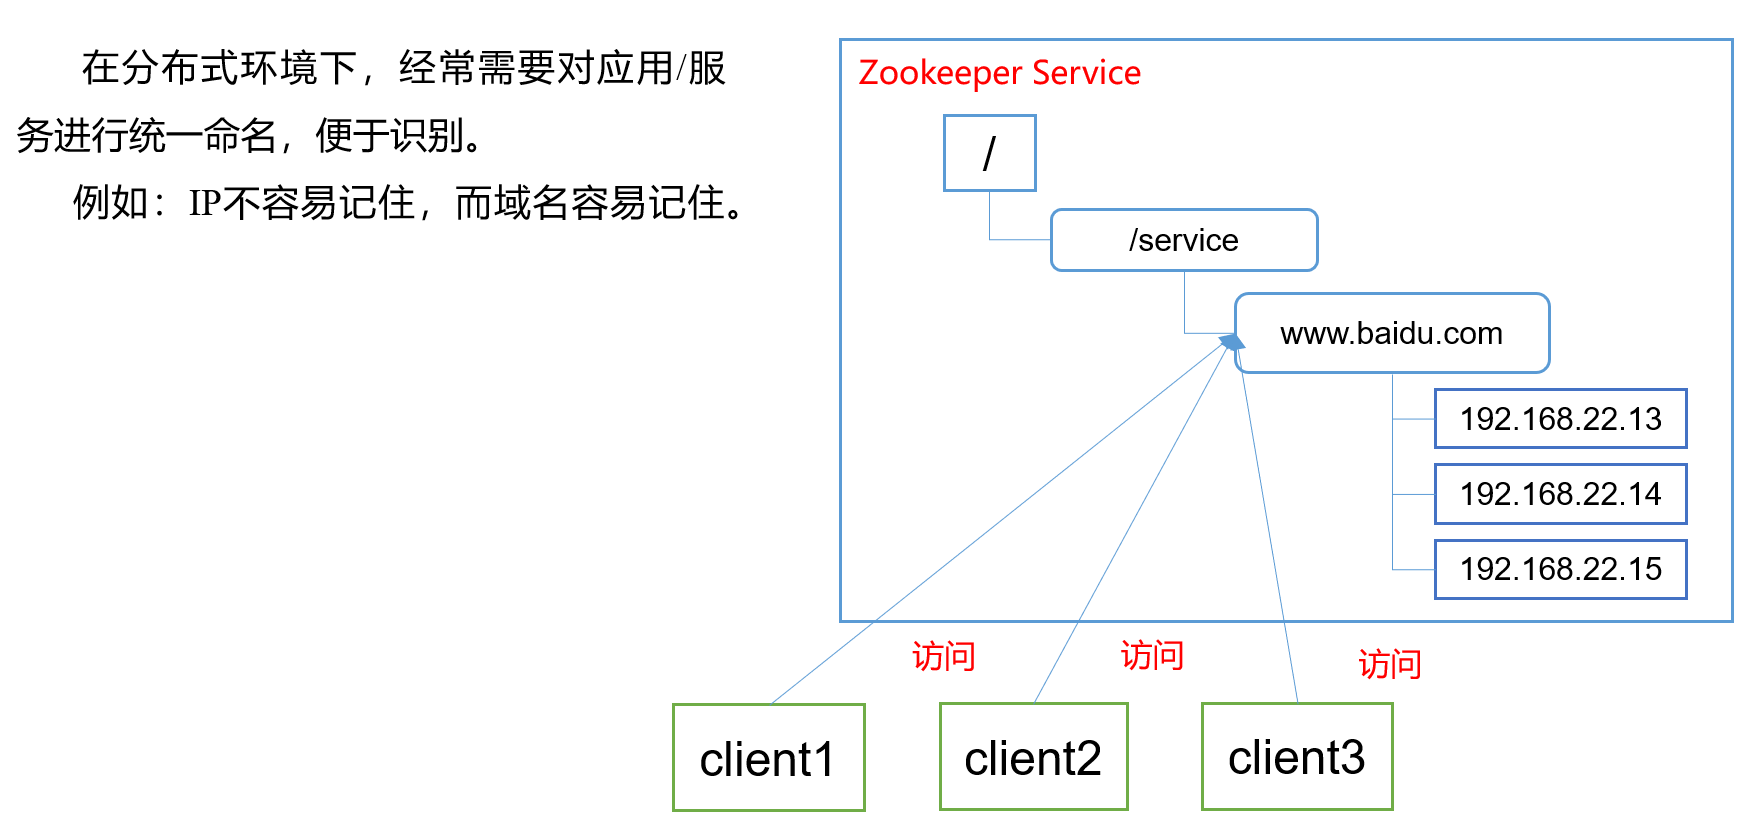
提供的服务包括:统一命名服务、统一配置管理、统一集群管理、服务器节点动态上下线、软负载均衡等。

1.4.1 统一服务命名服务

1638329641759

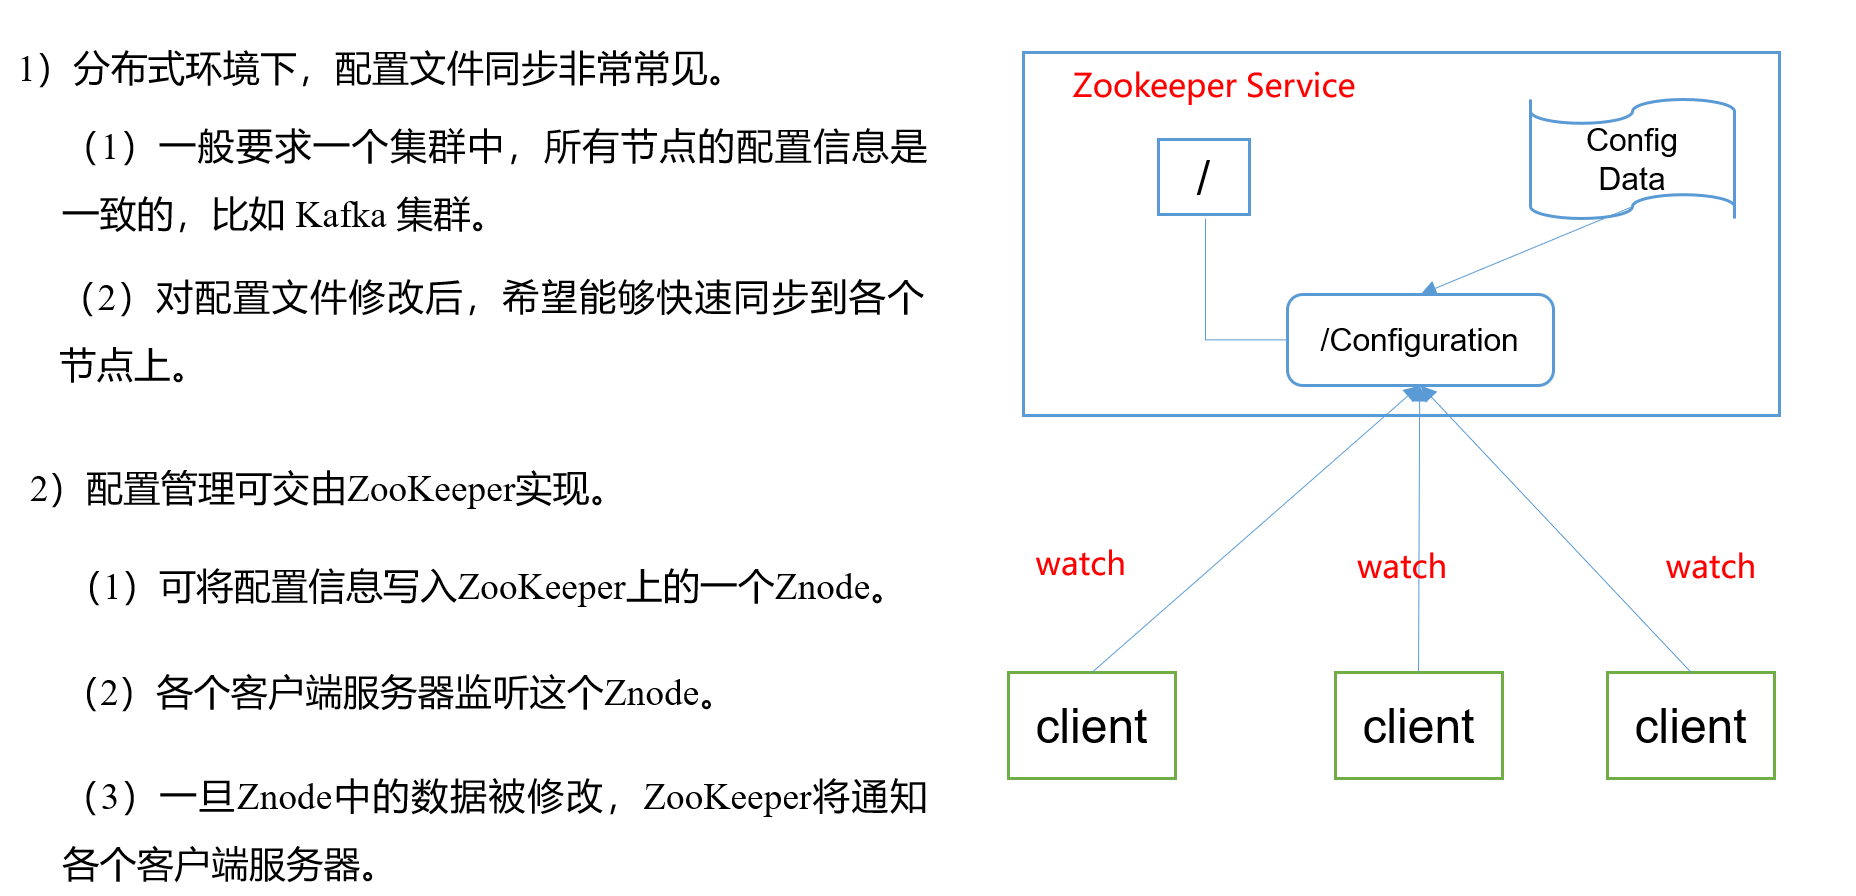
1.4.2 统一配置管理

1638329675526

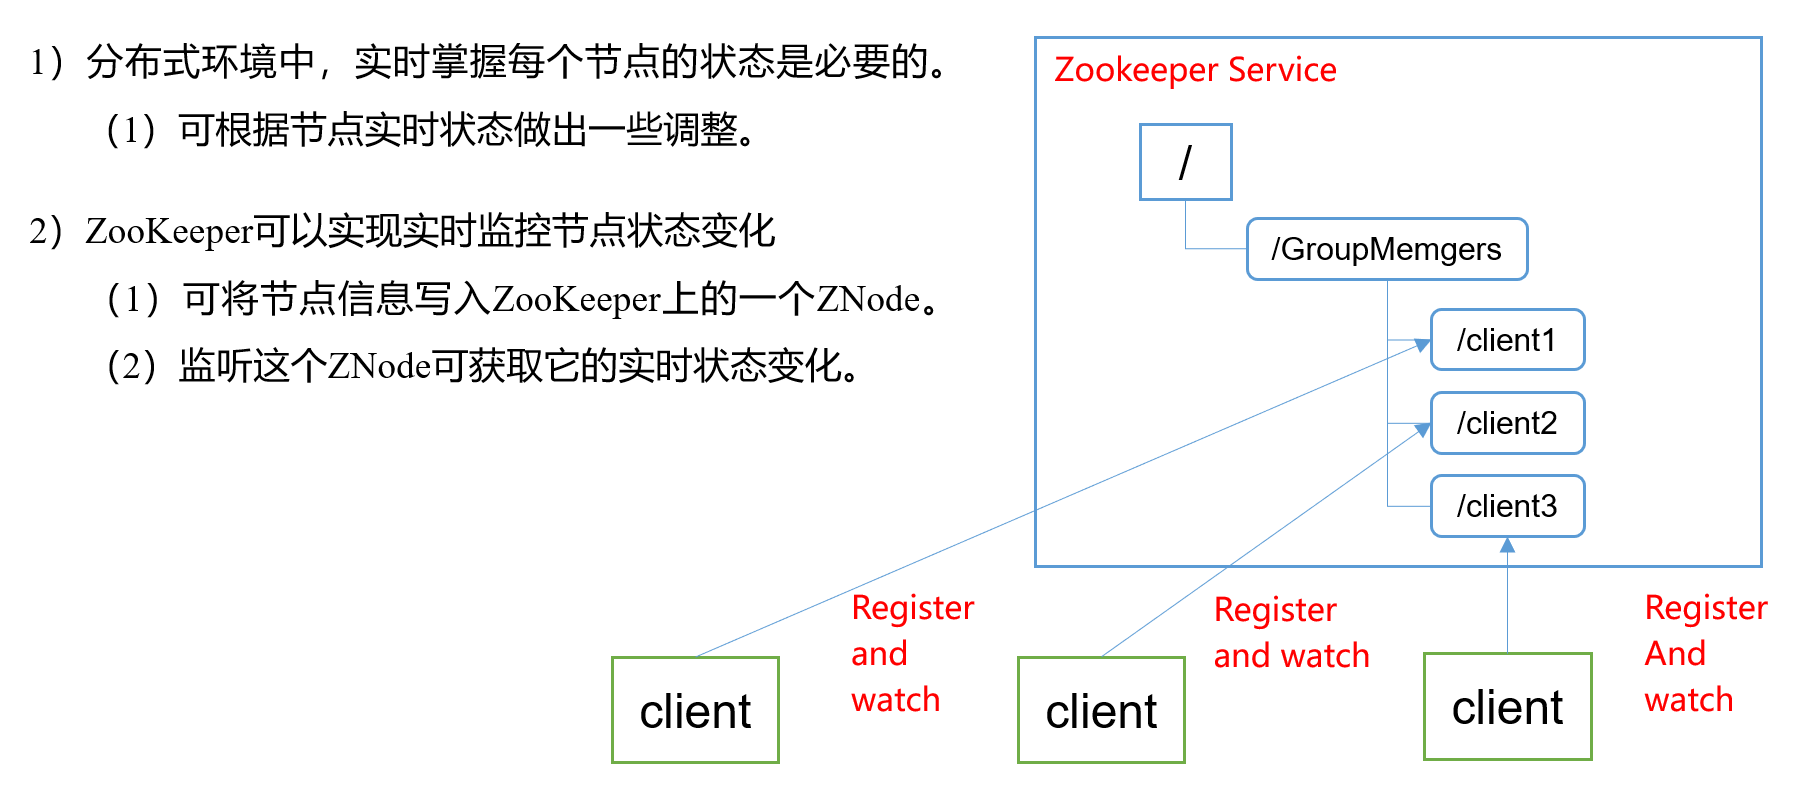
1.4.3 统一集群管理

1638329704193

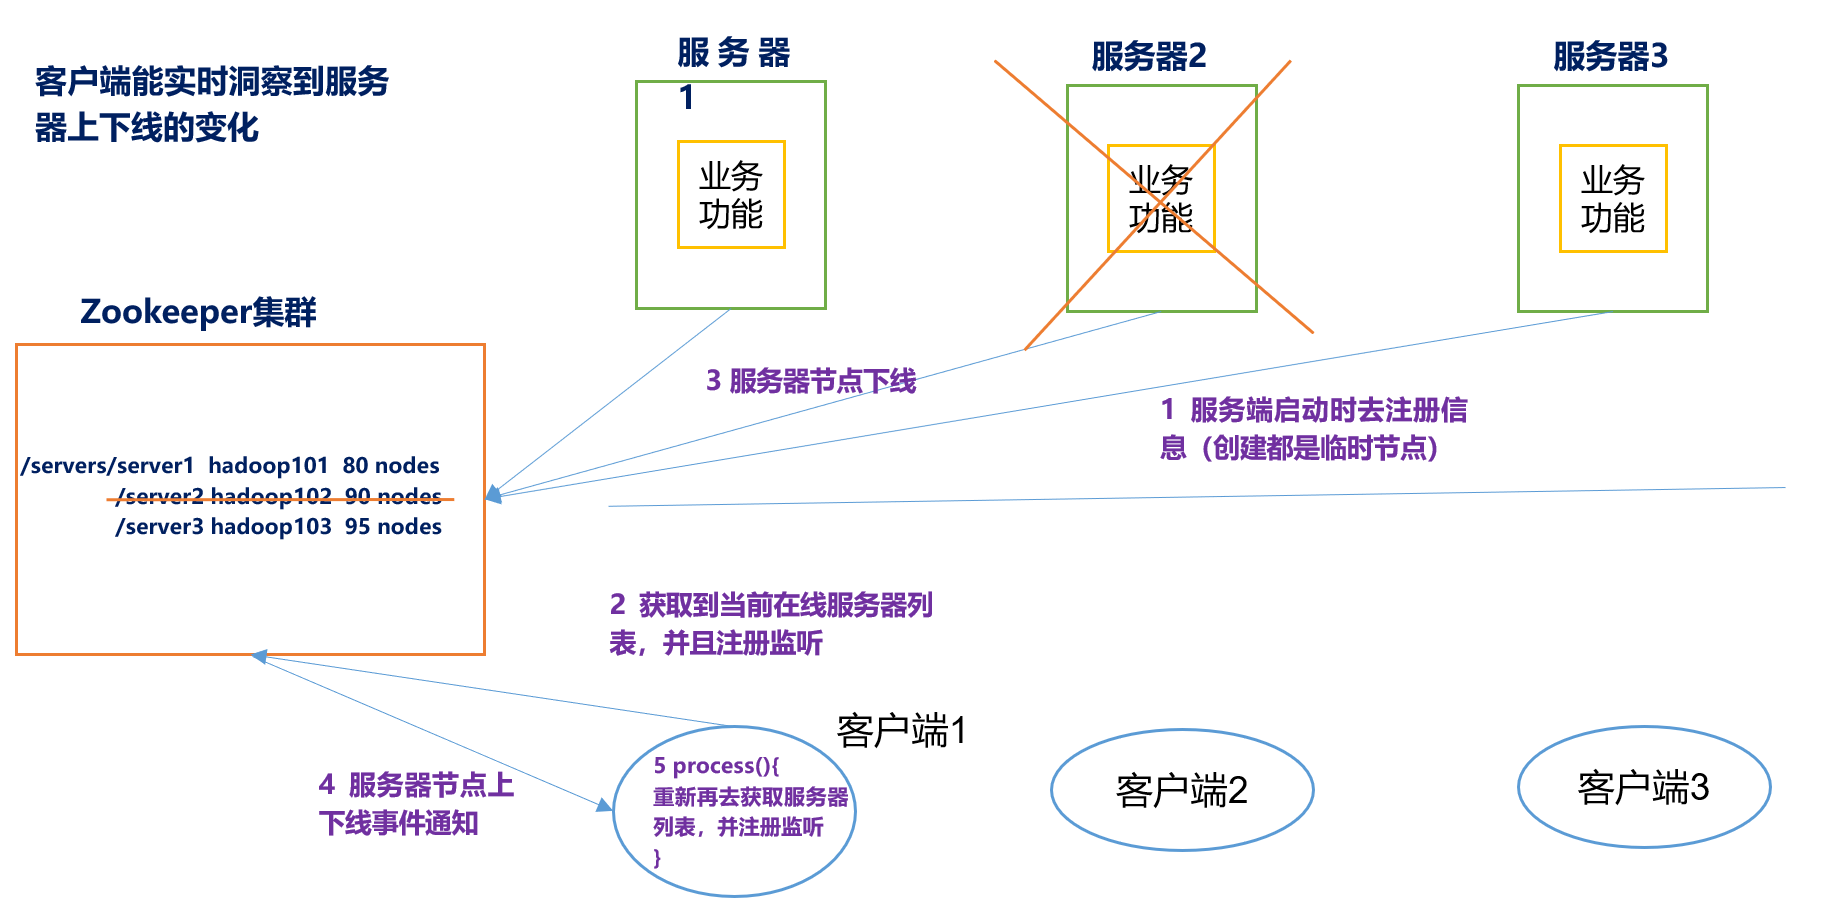
1.4.4 服务器节点动态上下线

1638329743811

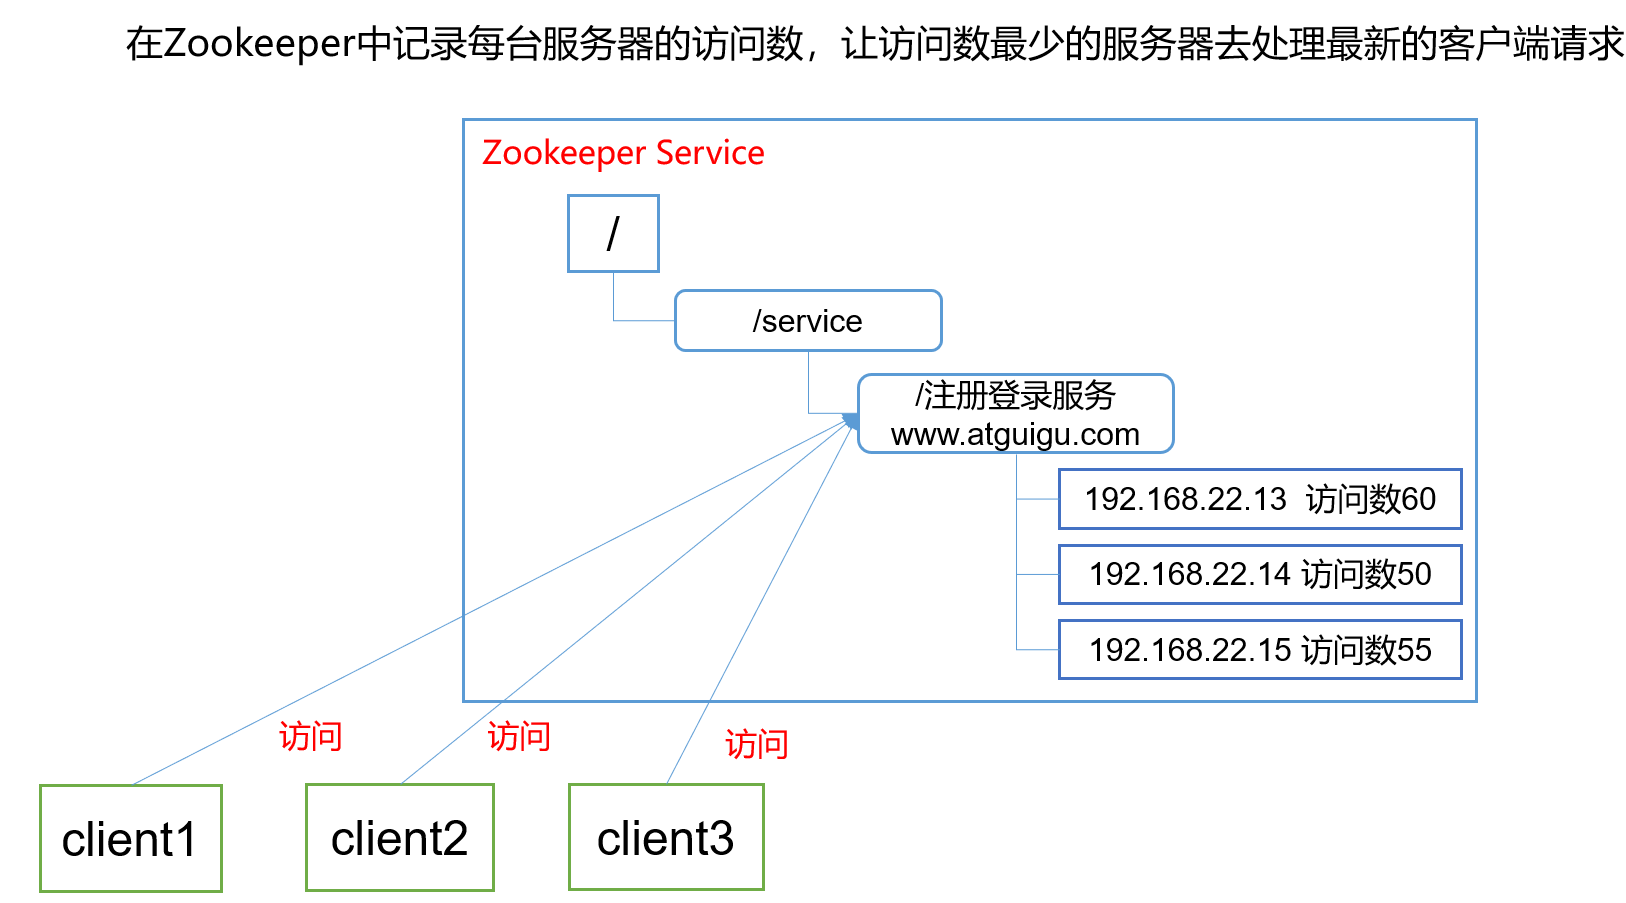
1.4.5 软负载均衡

1638329814579

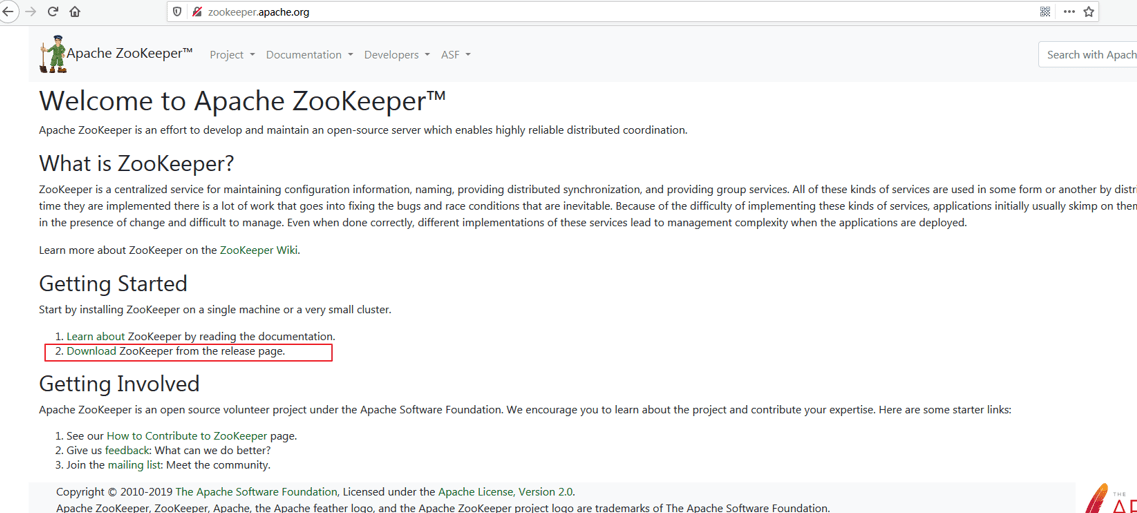
1.5 下载地址

1)官网首页:

https://zookeeper.apache.org/

2)下载截图

1638339458131

2 Zookeeper安装

2.1 本地模式安装部署

1)安装前准备

(1)安装Jdk

(2)拷贝Zookeeper安装包到Linux系统下

(3)解压到指定目录

[molly@hadoop102 software]$ tar -zxvf zookeeper-3.5.7.tar.gz -C /opt/module/

2)配置修改

(1)将/opt/module/zookeeper-3.5.7/conf这个路径下的zoo_sample.cfg修改为zoo.cfg;

[molly@hadoop102 conf]$ mv zoo_sample.cfg zoo.cfg

(2)打开zoo.cfg文件,修改dataDir路径:

[molly@hadoop102 zookeeper-3.5.7]$ vim zoo.cfg

修改如下内容:

dataDir=/opt/module/zookeeper-3.5.7/zkData

(3)在/opt/module/zookeeper-3.5.7/这个目录上创建zkData文件夹

[molly@hadoop102 zookeeper-3.5.7]$ mkdir zkData

3)操作Zookeeper

(1)启动Zookeeper

[molly@hadoop102 zookeeper-3.5.7]$ bin/zkServer.sh start

(2)查看进程是否启动

[molly@hadoop102 zookeeper-3.5.7]$ jps
4020 Jps
4001 QuorumPeerMain

(3)查看状态:

[molly@hadoop102 zookeeper-3.5.7]$ bin/zkServer.sh status
ZooKeeper JMX enabled by default
Using config: /opt/module/zookeeper-3.5.7/bin/../conf/zoo.cfg
Mode: standalone

(4)启动客户端:

[molly@hadoop102 zookeeper-3.5.7]$ bin/zkCli.sh

(5)退出客户端:

[zk: localhost:2181(CONNECTED) 0] quit

(6)停止Zookeeper

[molly@hadoop102 zookeeper-3.5.7]$ bin/zkServer.sh stop

2.2 配置参数解读

Zookeeper中的配置文件zoo.cfg中参数含义解读如下:

1)tickTime =2000:通信心跳数,Zookeeper服务器与客户端心跳时间,单位毫秒

Zookeeper使用的基本时间,服务器之间或客户端与服务器之间维持心跳的时间间隔,也就是每个tickTime时间就会发送一个心跳,时间单位为毫秒。

它用于心跳机制,并且设置最小的session超时时间为两倍心跳时间。(session的最小超时时间是2*tickTime)

2)initLimit =10:LF初始通信时限

集群中的Follower跟随者服务器与Leader领导者服务器之间初始连接时能容忍的最多心跳数(tickTime的数量),用它来限定集群中的Zookeeper服务器连接到Leader的时限。

3)syncLimit =5:LF同步通信时限

集群中Leader与Follower之间的最大响应时间单位,假如响应超过syncLimit * tickTime,Leader认为Follwer死掉,从服务器列表中删除Follwer。

4)dataDir:数据文件目录+数据持久化路径

主要用于保存Zookeeper中的数据。

5)clientPort =2181:客户端连接端口

监听客户端连接的端口。

2.3 分布式安装部署

1)集群规划

在hadoop102、hadoop103和hadoop104三个节点上部署Zookeeper。

2)解压安装

(1)解压Zookeeper安装包到/opt/module/目录下

[molly@hadoop102 software]$ tar -zxvf zookeeper-3.5.7.tar.gz -C /opt/module/

(2)同步/opt/module/zookeeper-3.5.7目录内容到hadoop103、hadoop104

[molly@hadoop102 module]$ xsync zookeeper-3.5.7/

3)配置服务器编号

(1)在/opt/module/zookeeper-3.5.7/这个目录下创建zkData

[molly@hadoop102 zookeeper-3.5.7]$ mkdir -p zkData

(2)在/opt/module/zookeeper-3.5.7/zkData目录下创建一个myid的文件

[molly@hadoop102 zkData]$ touch myid

添加myid文件,注意一定要在linux里面创建,在notepad++里面很可能乱码

(3)编辑myid文件

[molly@hadoop102 zkData]$ vi myid

在文件中添加与server对应的编号:

2

(4)拷贝配置好的zookeeper到其他机器上

[molly@hadoop102 zkData]$ xsync myid

并分别在hadoop103、hadoop104上修改myid文件中内容为3、4

4)配置zoo.cfg文件

(1)重命名/opt/module/zookeeper-3.5.7/conf这个目录下的zoo_sample.cfg为zoo.cfg

[molly@hadoop102 conf]$ mv zoo_sample.cfg zoo.cfg

(2)打开zoo.cfg文件

[molly@hadoop102 conf]$ vim zoo.cfg
#修改数据存储路径配置
dataDir=/opt/module/zookeeper-3.5.7/zkData
#增加如下配置
#######################cluster##########################
server.2=hadoop102:2888:3888
server.3=hadoop103:2888:3888
server.4=hadoop104:2888:3888

(3)同步zoo.cfg配置文件

[molly@hadoop102 conf]$ xsync zoo.cfg

(4)配置参数解读

server.A=B:C:D。

A是一个数字,表示这个是第几号服务器;

集群模式下配置一个文件myid,这个文件在dataDir目录下,这个文件里面有一个数据就是A的值,Zookeeper启动时读取此文件,拿到里面的数据与zoo.cfg里面的配置信息比较从而判断到底是哪个server。

B是这个服务器的地址;

C是这个服务器Follower与集群中的Leader服务器交换信息的端口;

D是万一集群中的Leader服务器挂了,需要一个端口来重新进行选举,选出一个新的Leader,而这个端口就是用来执行选举时服务器相互通信的端口。

5)集群操作

(1)分别启动Zookeeper

[molly@hadoop102 zookeeper-3.5.7]$ bin/zkServer.sh start
[molly@hadoop103 zookeeper-3.5.7]$ bin/zkServer.sh start
[molly@hadoop104 zookeeper-3.5.7]$ bin/zkServer.sh start

(2)查看状态

[molly@hadoop102 zookeeper-3.5.7]# bin/zkServer.sh status
JMX enabled by default
Using config: /opt/module/zookeeper-3.5.7/bin/../conf/zoo.cfg
Mode: follower

[molly@hadoop103 zookeeper-3.5.7]# bin/zkServer.sh status
JMX enabled by default
Using config: /opt/module/zookeeper-3.5.7/bin/../conf/zoo.cfg
Mode: leader

[molly@hadoop104 zookeeper-3.5.7]# bin/zkServer.sh status
JMX enabled by default
Using config: /opt/module/zookeeper-3.5.7/bin/../conf/zoo.cfg
Mode: follower

3 客户端命令行操作

命令基本语法功能描述
help显示所有操作命令
ls path使用 ls 命令来查看当前znode的子节点 -w 监听子节点变化 -s 附加次级信息
create普通创建 -s 含有序列 -e 临时(重启或者超时消失)
get path获得节点的值 -w 监听节点内容变化 -s 附加次级信息
set设置节点的具体值
stat查看节点状态
delete删除节点
deleteall递归删除节点

1)启动客户端

[molly@hadoop103 zookeeper-3.5.7]$ bin/zkCli.sh

2)显示所有操作命令

[zk: localhost:2181(CONNECTED) 1] help

3)查看当前znode中所包含的内容

[zk: localhost:2181(CONNECTED) 0] ls /

[zookeeper]

4)查看当前节点详细数据

[zk: localhost:2181(CONNECTED) 1] ls -s /
[zookeeper]
cZxid = 0x0
ctime = Thu Jan 01 08:00:00 CST 1970
mZxid = 0x0
mtime = Thu Jan 01 08:00:00 CST 1970
pZxid = 0x0
cversion = -1
dataVersion = 0
aclVersion = 0
ephemeralOwner = 0x0
dataLength = 0
numChildren = 1

5)分别创建2个普通节点

[zk: localhost:2181(CONNECTED) 3] create /sanguo "diaochan"
Created /sanguo
[zk: localhost:2181(CONNECTED) 4] create /sanguo/shuguo "liubei"
Created /sanguo/shuguo

6)获得节点的值

[zk: localhost:2181(CONNECTED) 5] get /sanguo
diaochan
[zk: localhost:2181(CONNECTED) 6] get -s /sanguo
diaochan
cZxid = 0x100000003
ctime = Wed Aug 29 00:03:23 CST 2018
mZxid = 0x100000003
mtime = Wed Aug 29 00:03:23 CST 2018
pZxid = 0x100000004
cversion = 1
dataVersion = 0
aclVersion = 0
ephemeralOwner = 0x0
dataLength = 7
numChildren = 1
[zk: localhost:2181(CONNECTED) 7]
[zk: localhost:2181(CONNECTED) 7] get -s /sanguo/shuguo
liubei
cZxid = 0x100000004
ctime = Wed Aug 29 00:04:35 CST 2018
mZxid = 0x100000004
mtime = Wed Aug 29 00:04:35 CST 2018
pZxid = 0x100000004
cversion = 0
dataVersion = 0
aclVersion = 0
ephemeralOwner = 0x0
dataLength = 6
numChildren = 0

7)创建临时节点

[zk: localhost:2181(CONNECTED) 7] create -e /sanguo/wuguo "zhouyu"
Created /sanguo/wuguo

(1)在当前客户端是能查看到的

[zk: localhost:2181(CONNECTED) 3] ls /sanguo 
[wuguo, shuguo]

(2)退出当前客户端然后再重启客户端

[zk: localhost:2181(CONNECTED) 12] quit
[molly@hadoop104 zookeeper-3.5.7]$ bin/zkCli.sh

(3)再次查看根目录下短暂节点已经删除

[zk: localhost:2181(CONNECTED) 0] ls /sanguo
[shuguo]

8)创建带序号的节点

​ (1)先创建一个普通的根节点/sanguo/weiguo

[zk: localhost:2181(CONNECTED) 1] create /sanguo/weiguo "caocao"
Created /sanguo/weiguo

​ (2)创建带序号的节点

[zk: localhost:2181(CONNECTED) 2] create /sanguo/weiguo "caocao"
Node already exists: /sanguo/weiguo
[zk: localhost:2181(CONNECTED) 3] create -s /sanguo/weiguo "caocao"
Created /sanguo/weiguo0000000000
[zk: localhost:2181(CONNECTED) 4] create -s /sanguo/weiguo "caocao"
Created /sanguo/weiguo0000000001
[zk: localhost:2181(CONNECTED) 5] create -s /sanguo/weiguo "caocao"
Created /sanguo/weiguo0000000002
[zk: localhost:2181(CONNECTED) 6] ls /sanguo
[shuguo, weiguo, weiguo0000000000, weiguo0000000001, weiguo0000000002, wuguo]
[zk: localhost:2181(CONNECTED) 6]

如果节点下原来没有子节点,序号从0开始依次递增。如果原节点下已有2个节点,则再排序时从2开始,以此类推。

9)修改节点数据值

[zk: localhost:2181(CONNECTED) 6] set /sanguo/weiguo "caopi"

10)节点的值变化监听

​ (1)在hadoop104主机上注册监听/sanguo节点数据变化

[zk: localhost:2181(CONNECTED) 26] [zk: localhost:2181(CONNECTED) 8] get -w /sanguo

​ (2)在hadoop103主机上修改/sanguo节点的数据

[zk: localhost:2181(CONNECTED) 1] set /sanguo "xishi"

​ (3)观察hadoop104主机收到数据变化的监听

WATCHER::

WatchedEvent state:SyncConnected type:NodeDataChanged path:/sanguo

11)节点的子节点变化监听(路径变化)

​ (1)在hadoop104主机上注册监听/sanguo节点的子节点变化

[zk: localhost:2181(CONNECTED) 1] ls -w /sanguo
[aa0000000001, server101]

​ (2)在hadoop103主机/sanguo节点上创建子节点

[zk: localhost:2181(CONNECTED) 2] create /sanguo/jin "simayi"
Created /sanguo/jin

​ (3)观察hadoop104主机收到子节点变化的监听

WATCHER::
WatchedEvent state:SyncConnected type:NodeChildrenChanged path:/sanguo

12)删除节点

[zk: localhost:2181(CONNECTED) 4] delete /sanguo/jin

13)递归删除节点

[zk: localhost:2181(CONNECTED) 15] deleteall /sanguo/shuguo

14)查看节点状态

[zk: localhost:2181(CONNECTED) 17] stat /sanguo
cZxid = 0x100000003
ctime = Wed Aug 29 00:03:23 CST 2018
mZxid = 0x100000011
mtime = Wed Aug 29 00:21:23 CST 2018
pZxid = 0x100000014
cversion = 9
dataVersion = 1
aclVersion = 0
ephemeralOwner = 0x0
dataLength = 4
numChildren = 1

Spark学习笔记(二) 架构解析和RDD编程

1 Spark运行架构

1.1 运行架构

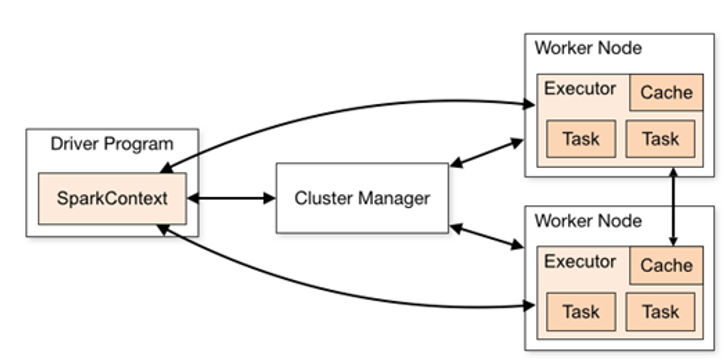
Spark框架的核心是一个计算引擎,整体来说,它采用了标准 master-slave 的结构。

如下图所示,它展示了一个 Spark执行时的基本结构。图形中的Driver表示master,负责管理整个集群中的作业任务调度。图形中的Executor 则是 slave,负责实际执行任务。

1638183145356

1.2 核心组件

由上图可以看出,对于Spark框架有两个核心组件:

1.2.1 Driver

Spark驱动器节点,用于执行Spark任务中的main方法,负责实际代码的执行工作。Driver在Spark作业执行时主要负责:

Ø 将用户程序转化为作业(job)

Ø 在Executor之间调度任务(task)

Ø 跟踪Executor的执行情况

Ø 通过UI展示查询运行情况

实际上,我们无法准确地描述Driver的定义,因为在整个的编程过程中没有看到任何有关Driver的字眼。所以简单理解,所谓的Driver就是驱使整个应用运行起来的程序,也称之为Driver类。

1.2.2 Executor

Spark Executor是集群中工作节点(Worker)中的一个JVM进程,负责在 Spark 作业中运行具体任务(Task),任务彼此之间相互独立。Spark 应用启动时,Executor节点被同时启动,并且始终伴随着整个 Spark 应用的生命周期而存在。如果有Executor节点发生了故障或崩溃,Spark 应用也可以继续执行,会将出错节点上的任务调度到其他Executor节点上继续运行。

Executor有两个核心功能:

Ø 负责运行组成Spark应用的任务,并将结果返回给驱动器进程

Ø 它们通过自身的块管理器(Block Manager)为用户程序中要求缓存的 RDD 提供内存式存储。RDD 是直接缓存在Executor进程内的,因此任务可以在运行时充分利用缓存数据加速运算。

1.2.3 Master & Worker

Spark集群的独立部署环境中,不需要依赖其他的资源调度框架,自身就实现了资源调度的功能,所以环境中还有其他两个核心组件:Master和Worker,这里的Master是一个进程,主要负责资源的调度和分配,并进行集群的监控等职责,类似于Yarn环境中的RM, 而Worker呢,也是进程,一个Worker运行在集群中的一台服务器上,由Master分配资源对数据进行并行的处理和计算,类似于Yarn环境中NM。

1.2.4 ApplicationMaster

Hadoop用户向YARN集群提交应用程序时,提交程序中应该包含ApplicationMaster,用于向资源调度器申请执行任务的资源容器Container,运行用户自己的程序任务job,监控整个任务的执行,跟踪整个任务的状态,处理任务失败等异常情况。

说的简单点就是,ResourceManager(资源)和Driver(计算)之间的解耦合靠的就是ApplicationMaster。

1.3 核心概念

1.3.1 Executor与Core(核)

Spark Executor是集群中运行在工作节点(Worker)中的一个JVM进程,是整个集群中的专门用于计算的节点。在提交应用中,可以提供参数指定计算节点的个数,以及对应的资源。这里的资源一般指的是工作节点Executor的内存大小和使用的虚拟CPU核(Core)数量。

应用程序相关启动参数如下:

名称说明
–num-executors配置Executor的数量
–executor-memory配置每个Executor的内存大小
–executor-cores配置每个Executor的虚拟CPU core数量

1.3.2 并行度(Parallelism)

在分布式计算框架中一般都是多个任务同时执行,由于任务分布在不同的计算节点进行计算,所以能够真正地实现多任务并行执行,记住,这里是并行,而不是并发。这里我们将整个集群并行执行任务的数量称之为并行度。那么一个作业到底并行度是多少呢?这个取决于框架的默认配置。应用程序也可以在运行过程中动态修改。

1.3.3 有向无环图(DAG)

1638183179425

大数据计算引擎框架我们根据使用方式的不同一般会分为四类,其中第一类就是Hadoop所承载的MapReduce,它将计算分为两个阶段,分别为 Map阶段 和 Reduce阶段。对于上层应用来说,就不得不想方设法去拆分算法,甚至于不得不在上层应用实现多个 Job 的串联,以完成一个完整的算法,例如迭代计算。 由于这样的弊端,催生了支持 DAG 框架的产生。因此,支持 DAG 的框架被划分为第二代计算引擎。如 Tez 以及更上层的 Oozie。这里我们不去细究各种 DAG 实现之间的区别,不过对于当时的 Tez 和 Oozie 来说,大多还是批处理的任务。接下来就是以 Spark 为代表的第三代的计算引擎。第三代计算引擎的特点主要是 Job 内部的 DAG 支持(不跨越 Job),以及实时计算。

这里所谓的有向无环图,并不是真正意义的图形,而是由Spark程序直接映射成的数据流的高级抽象模型。简单理解就是将整个程序计算的执行过程用图形表示出来,这样更直观,更便于理解,可以用于表示程序的拓扑结构。

DAG(Directed Acyclic Graph)有向无环图是由点和线组成的拓扑图形,该图形具有方向,不会闭环。

1.4 提交流程

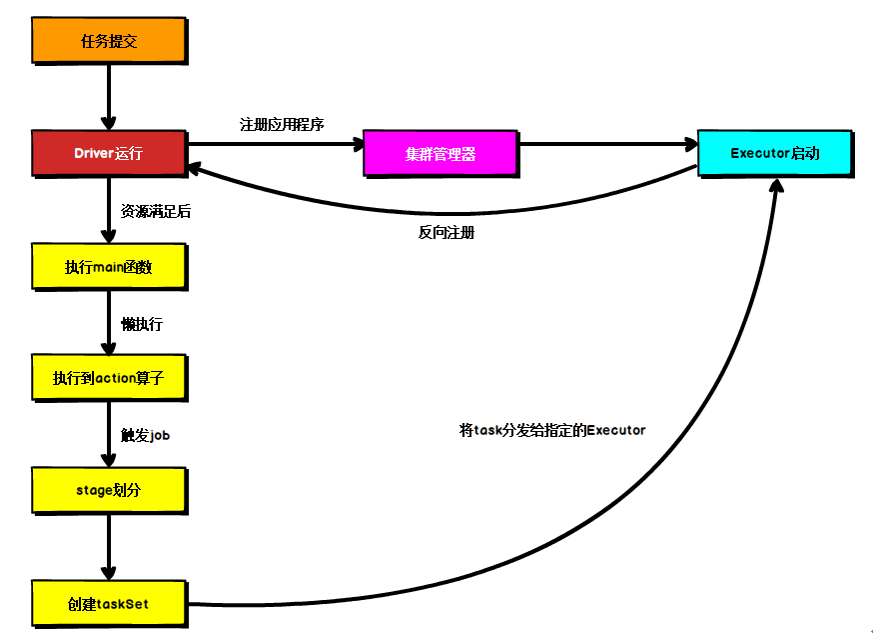
所谓的提交流程,其实就是我们开发人员根据需求写的应用程序通过Spark客户端提交给Spark运行环境执行计算的流程。在不同的部署环境中,这个提交过程基本相同,但是又有细微的区别,我们这里不进行详细的比较,但是因为国内工作中,将Spark引用部署到Yarn环境中会更多一些,所以本课程中的提交流程是基于Yarn环境的。

1638183211849

Spark应用程序提交到Yarn环境中执行的时候,一般会有两种部署执行的方式:Client和Cluster。两种模式主要区别在于:Driver程序的运行节点位置。

1.2.1 Yarn Client模式

Client模式将用于监控和调度的Driver模块在客户端执行,而不是在Yarn中,所以一般用于测试。

Ø Driver在任务提交的本地机器上运行

Ø Driver启动后会和ResourceManager通讯申请启动ApplicationMaster

Ø ResourceManager分配container,在合适的NodeManager上启动ApplicationMaster,负责向ResourceManager申请Executor内存

Ø ResourceManager接到ApplicationMaster的资源申请后会分配container,然后ApplicationMaster在资源分配指定的NodeManager上启动Executor进程

Ø Executor进程启动后会向Driver反向注册,Executor全部注册完成后Driver开始执行main函数

Ø 之后执行到Action算子时,触发一个Job,并根据宽依赖开始划分stage,每个stage生成对应的TaskSet,之后将task分发到各个Executor上执行。

1.2.2 Yarn Cluster模式

Cluster模式将用于监控和调度的Driver模块启动在Yarn集群资源中执行。一般应用于实际生产环境。

Ø 在YARN Cluster模式下,任务提交后会和ResourceManager通讯申请启动ApplicationMaster,

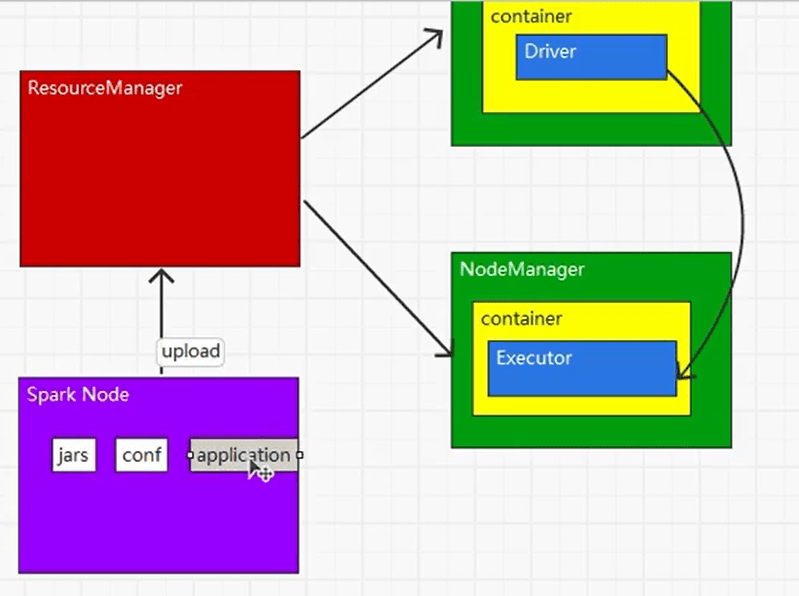
Ø 随后ResourceManager分配container,在合适的NodeManager上启动ApplicationMaster,此时的ApplicationMaster就是Driver。

Ø Driver启动后向ResourceManager申请Executor内存,ResourceManager接到ApplicationMaster的资源申请后会分配container,然后在合适的NodeManager上启动Executor进程

Ø Executor进程启动后会向Driver反向注册,Executor全部注册完成后Driver开始执行main函数,

Ø 之后执行到Action算子时,触发一个Job,并根据宽依赖开始划分stage,每个stage生成对应的TaskSet,之后将task分发到各个Executor上执行。

2 Spark核心编程

Spark计算框架为了能够进行高并发和高吞吐的数据处理,封装了三大数据结构,用于处理不同的应用场景。三大数据结构分别是:

Ø RDD : 弹性分布式数据集

Ø 累加器:分布式共享只写变量

Ø 广播变量:分布式共享只读变量

接下来我们一起看看这三大数据结构是如何在数据处理中使用的。

2.1 RDD

2.1.1 什么是RDD

RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是Spark中最基本的数据处理模型。代码中是一个抽象类,它代表一个弹性的、不可变、可分区、里面的元素可并行计算的集合。(所谓的RDD,其实就是要给数据结构,类似于链表中的Node,RDD中有适合并行计算的分区操作;RDD中封装了最小的计算单元,目的是更适合重复使用;Spark主要就是通过组合RDD的操作完成业务需求。)

那Spark 怎么组合RDD?

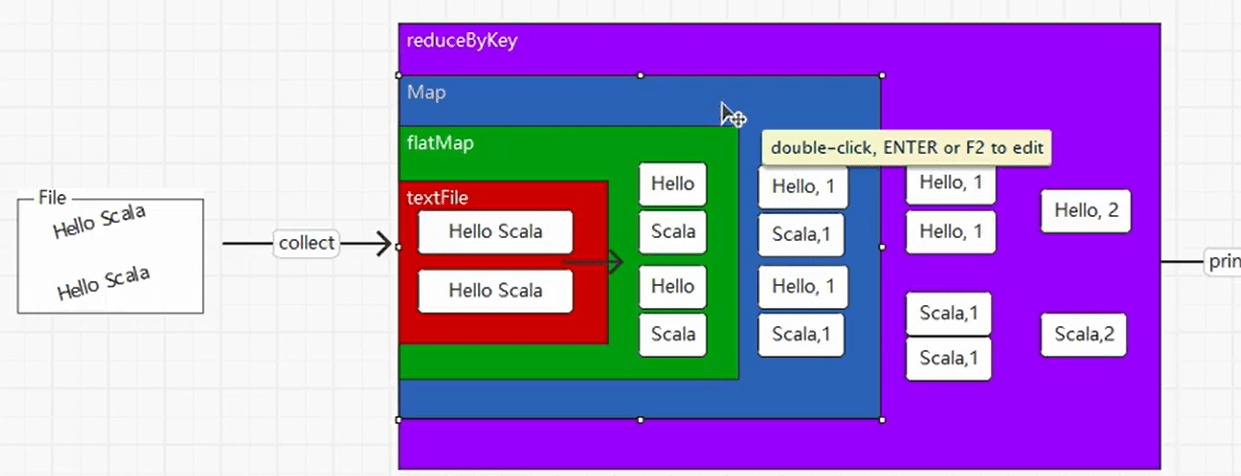
RDD的扩展功能采用的也是装饰者设计模式;RDD中的collect方法类似于IO中的read方法。RDD不存储任何数据,只封装逻辑。

1638181914698

Ø 弹性

l 存储的弹性:内存与磁盘的自动切换;

l 容错的弹性:数据丢失可以自动恢复;

l 计算的弹性:计算出错重试机制;

l 分片的弹性:可根据需要重新分片。

Ø 分布式:数据存储在大数据集群不同节点上

Ø 数据集:RDD封装了计算逻辑,并不保存数据

Ø 数据抽象:RDD是一个抽象类,需要子类具体实现

Ø 不可变:RDD封装了计算逻辑,是不可以改变的,想要改变,只能产生新的RDD,在新的RDD里面封装计算逻辑

Ø 可分区、并行计算

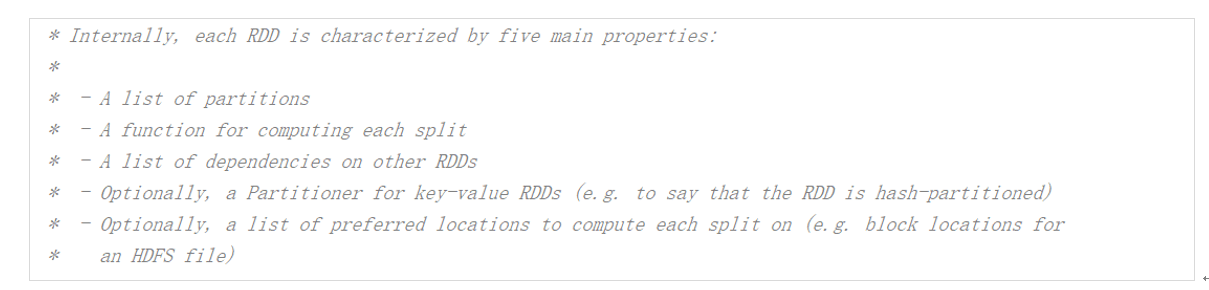
2.1.2 核心属性

img

1638182223714

1)分区列表

RDD数据结构中存在分区列表,用于执行任务时并行计算,是实现分布式计算的重要属性。

2) 分区计算函数

Spark在计算时,是使用分区函数对每一个分区进行计算

3)RDD之间的依赖关系

RDD是计算模型的封装,当需求中需要将多个计算模型进行组合时,就需要将多个RDD建立依赖关系

4) 分区器(可选)

当数据为KV类型数据时,可以通过设定分区器自定义数据的分区

5)首选位置(可选)

计算数据时,可以根据计算节点的状态选择不同的节点位置进行计算

2.1.3 执行原理

从计算的角度来讲,数据处理过程中需要计算资源(内存 & CPU)和计算模型(逻辑)。执行时,需要将计算资源和计算模型进行协调和整合。

Spark框架在执行时,先申请资源,然后将应用程序的数据处理逻辑分解成一个一个的计算任务。然后将任务发到已经分配资源的计算节点上, 按照指定的计算模型进行数据计算。最后得到计算结果。

RDD是Spark框架中用于数据处理的核心模型,接下来我们看看,在Yarn环境中,RDD的工作原理:

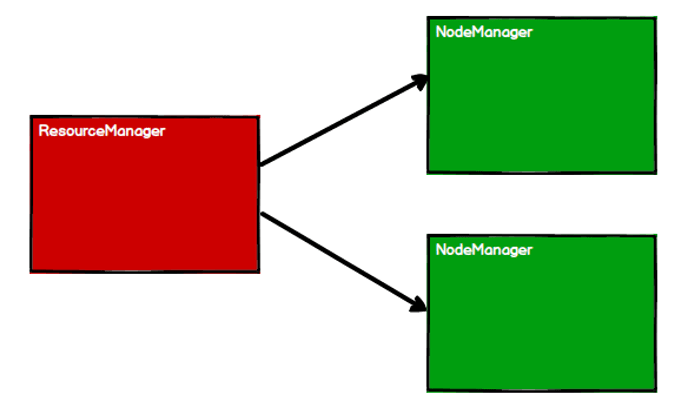
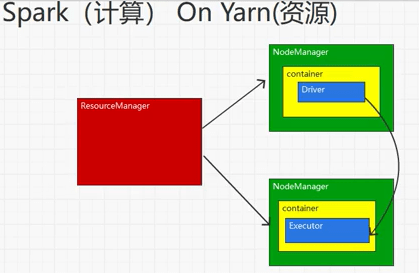
  1. 启动Yarn集群环境

1638182323787

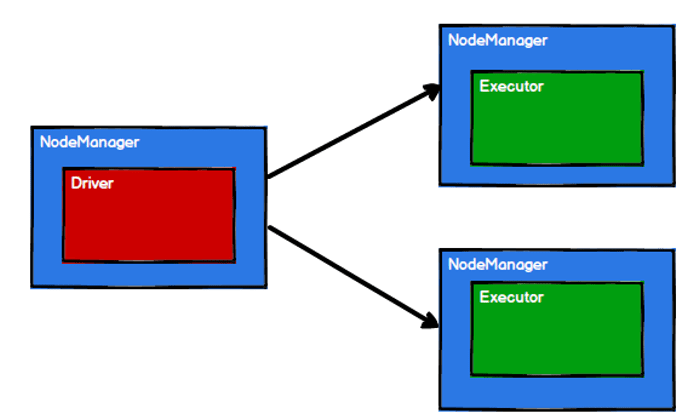
  1. Spark通过申请资源创建调度节点和计算节点

1638182335328

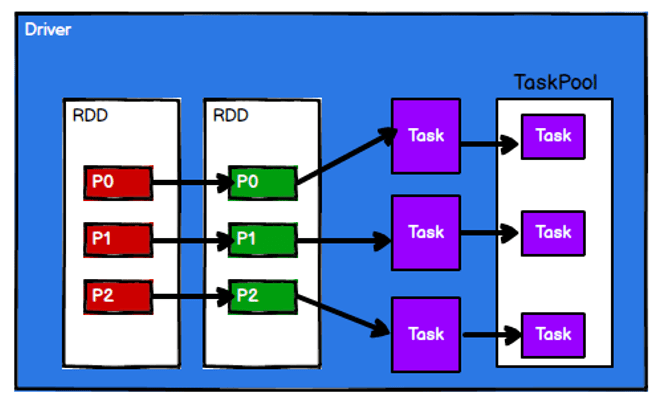
  1. Spark框架根据需求将计算逻辑根据分区划分成不同的任务

1638182347091

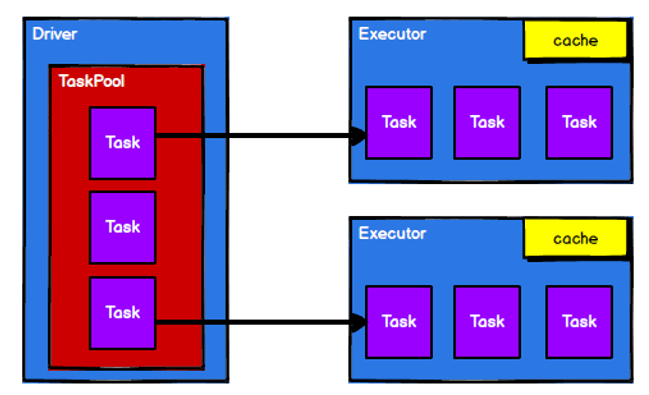
  1. 调度节点将任务根据计算节点状态发送到对应的计算节点进行计算

1638182359929

从以上流程可以看出RDD在整个流程中主要用于将逻辑进行封装,并生成Task发送给Executor节点执行计算,接下来我们就一起看看Spark框架中RDD是具体是如何进行数据处理的。

2.1.4 基础编程

2.1.4.1 RDD创建

在Spark中创建RDD的创建方式可以分为四种:

1) 从集合(内存)中创建RDD

从集合中创建RDD,Spark主要提供了两个方法:parallelize和makeRDD(推荐使用)

val sparkConf =
    new SparkConf().setMaster("local[*]").setAppName("spark")
val sparkContext = new SparkContext(sparkConf)
val rdd1 = sparkContext.parallelize(
    List(1,2,3,4)
)
val rdd2 = sparkContext.makeRDD(
    List(1,2,3,4)
)
rdd1.collect().foreach(println)
rdd2.collect().foreach(println)
sparkContext.stop()
  1. 从外部存储(文件)创建RDD

由外部存储系统的数据集创建RDD(textFile函数)包括:本地的文件系统,所有Hadoop支持的数据集,比如HDFS、HBase等。。

val sparkConf =
    new SparkConf().setMaster("local[*]").setAppName("spark")
val sparkContext = new SparkContext(sparkConf)
val fileRDD: RDD[String] = sparkContext.textFile("data/input.txt")
fileRDD.collect().foreach(println)
sparkContext.stop()

3) 从其他RDD创建

主要是通过一个RDD运算完后,再产生新的RDD。详情请参考后续章节

4) 直接创建RDD(new)

使用new的方式直接构造RDD,一般由Spark框架自身使用。

2.1.4.2 RDD并行度与分区

默认情况下,Spark可以将一个作业切分多个任务后,发送给Executor节点并行计算,而能够并行计算的任务数量我们称之为并行度。这个数量可以在构建RDD时指定。记住,这里的并行执行的任务数量,并不是指的切分任务的数量,不要混淆了。

val sparkConf =
    new SparkConf().setMaster("local[*]").setAppName("spark")
val sparkContext = new SparkContext(sparkConf)
val dataRDD: RDD[Int] =
    sparkContext.makeRDD(
        List(1,2,3,4),
        4)
val fileRDD: RDD[String] =
    sparkContext.textFile(
        "input",
        2)
fileRDD.collect().foreach(println)
sparkContext.stop()

l 读取内存数据时,数据可以按照并行度的设定进行数据的分区操作,数据分区规则的Spark核心源码如下:

def positions(length: Long, numSlices: Int): Iterator[(Int, Int)] = {
  (0 until numSlices).iterator.map { i =>
    val start = ((i * length) / numSlices).toInt
    val end = (((i + 1) * length) / numSlices).toInt
    (start, end)
  }
}

l 读取文件数据时,数据是按照Hadoop文件读取的规则进行切片分区,而切片规则和数据读取的规则有些差异,具体Spark核心源码如下

public InputSplit[] getSplits(JobConf job, int numSplits)
    throws IOException {

    long totalSize = 0;                           // compute total size
    for (FileStatus file: files) {                // check we have valid files
      if (file.isDirectory()) {
        throw new IOException("Not a file: "+ file.getPath());
      }
      totalSize += file.getLen();
    }

    long goalSize = totalSize / (numSplits == 0 ? 1 : numSplits);
    long minSize = Math.max(job.getLong(org.apache.hadoop.mapreduce.lib.input.
      FileInputFormat.SPLIT_MINSIZE, 1), minSplitSize);

    ...

    for (FileStatus file: files) {

        ...

    if (isSplitable(fs, path)) {
          long blockSize = file.getBlockSize();
          long splitSize = computeSplitSize(goalSize, minSize, blockSize);

          ...

  }
  protected long computeSplitSize(long goalSize, long minSize,
                                       long blockSize) {
    return Math.max(minSize, Math.min(goalSize, blockSize));
  }

2.1.4.3 RDD转换算子

RDD根据数据处理方式的不同将算子整体上分为Value类型、双Value类型和Key-Value类型

l Value类型

1) map

Ø 函数签名

def map[U: ClassTag](f: T => U): RDD[U]

Ø 函数说明

将处理的数据逐条进行映射转换,这里的转换可以是类型的转换,也可以是值的转换。

val dataRDD: RDD[Int] = sparkContext.makeRDD(List(1,2,3,4))

val dataRDD1: RDD[Int] = dataRDD.map(

num => {

​ num * 2

}

)

val dataRDD2: RDD[String] = dataRDD1.map(

num => {

​ “” + num

}

)

v 小功能:从服务器日志数据apache.log中获取用户请求URL资源路径

2) mapPartitions

Ø 函数签名

def mapPartitions[U: ClassTag](

f: Iterator[T] => Iterator[U],

preservesPartitioning: Boolean = false): RDD[U]

Ø 函数说明

将待处理的数据以分区为单位发送到计算节点进行处理,这里的处理是指可以进行任意的处理,哪怕是过滤数据。

val dataRDD1: RDD[Int] = dataRDD.mapPartitions(

datas => {

​ datas.filter(_==2)

}

)

v 小功能:获取每个数据分区的最大值

img 思考一个问题:map和mapPartitions的区别?

Ø 数据处理角度

Map算子是分区内一个数据一个数据的执行,类似于串行操作。而mapPartitions算子是以分区为单位进行批处理操作。

Ø 功能的角度

Map算子主要目的将数据源中的数据进行转换和改变。但是不会减少或增多数据。MapPartitions算子需要传递一个迭代器,返回一个迭代器,没有要求的元素的个数保持不变,所以可以增加或减少数据

Ø 性能的角度

Map算子因为类似于串行操作,所以性能比较低,而是mapPartitions算子类似于批处理,所以性能较高。但是mapPartitions算子会长时间占用内存,那么这样会导致内存可能不够用,出现内存溢出的错误。所以在内存有限的情况下,不推荐使用。使用map操作。

完成比完美更重要

3) mapPartitionsWithIndex

Ø 函数签名

def mapPartitionsWithIndex[U: ClassTag](

f: (Int, Iterator[T]) => Iterator[U],

preservesPartitioning: Boolean = false): RDD[U]

Ø 函数说明

将待处理的数据以分区为单位发送到计算节点进行处理,这里的处理是指可以进行任意的处理,哪怕是过滤数据,在处理时同时可以获取当前分区索引。

val dataRDD1 = dataRDD.mapPartitionsWithIndex(

(index, datas) => {

​ datas.map(index, _)

}

)

v 小功能:获取第二个数据分区的数据

4) flatMap

Ø 函数签名

def flatMap[U: ClassTag](f: T => TraversableOnce[U]): RDD[U]

Ø 函数说明

将处理的数据进行扁平化后再进行映射处理,所以算子也称之为扁平映射

val dataRDD = sparkContext.makeRDD(List(

List(1,2),List(3,4)

),1)

val dataRDD1 = dataRDD.flatMap(

list => list

)

v 小功能:将List(List(1,2),3,List(4,5))进行扁平化操作

5) glom

Ø 函数签名

def glom(): RDD[Array[T]]

Ø 函数说明

将同一个分区的数据直接转换为相同类型的内存数组进行处理,分区不变

val dataRDD = sparkContext.makeRDD(List(

1,2,3,4

),1)

val dataRDD1:RDD[Array[Int]] = dataRDD.glom()

v 小功能:计算所有分区最大值求和(分区内取最大值,分区间最大值求和)

6) groupBy

Ø 函数签名

def groupBy[K](f: T => K)(implicit kt: ClassTag[K]): RDD[(K, Iterable[T])]

Ø 函数说明

将数据根据指定的规则进行分组, 分区默认不变,但是数据会被打乱重新组合,我们将这样的操作称之为shuffle。极限情况下,数据可能被分在同一个分区中

一个组的数据在一个分区中,但是并不是说一个分区中只有一个组

val dataRDD = sparkContext.makeRDD(List(1,2,3,4),1)

val dataRDD1 = dataRDD.groupBy(

_%2

)

v 小功能:将List(“Hello”, “hive”, “hbase”, “Hadoop”)根据单词首写字母进行分组。

v 小功能:从服务器日志数据apache.log中获取每个时间段访问量。

v 小功能:WordCount。

7) filter

Ø 函数签名

def filter(f: T => Boolean): RDD[T]

Ø 函数说明

将数据根据指定的规则进行筛选过滤,符合规则的数据保留,不符合规则的数据丢弃。

当数据进行筛选过滤后,分区不变,但是分区内的数据可能不均衡,生产环境下,可能会出现数据倾斜。

val dataRDD = sparkContext.makeRDD(List(

1,2,3,4

),1)

val dataRDD1 = dataRDD.filter(_%2 == 0)

v 小功能:从服务器日志数据apache.log中获取2015年5月17日的请求路径

8) sample

Ø 函数签名

def sample(

withReplacement: Boolean,

fraction: Double,

seed: Long = Utils.random.nextLong): RDD[T]

Ø 函数说明

根据指定的规则从数据集中抽取数据

val dataRDD = sparkContext.makeRDD(List(

1,2,3,4

),1)

// 抽取数据不放回(伯努利算法)

// 伯努利算法:又叫0、1分布。例如扔硬币,要么正面,要么反面。

// 具体实现:根据种子和随机算法算出一个数和第二个参数设置几率比较,小于第二个参数要,大于不要

// 第一个参数:抽取的数据是否放回,false:不放回

// 第二个参数:抽取的几率,范围在[0,1]之间,0:全不取;1:全取;

// 第三个参数:随机数种子

val dataRDD1 = dataRDD.sample(false, 0.5)

// 抽取数据放回(泊松算法)

// 第一个参数:抽取的数据是否放回,true:放回;false:不放回

// 第二个参数:重复数据的几率,范围大于等于0.表示每一个元素被期望抽取到的次数

// 第三个参数:随机数种子

val dataRDD2 = dataRDD.sample(true, 2)

img思考一个问题:有啥用,抽奖吗?

9) distinct

Ø 函数签名

def distinct()(implicit ord: Ordering[T] = null): RDD[T]

def distinct(numPartitions: Int)(implicit ord: Ordering[T] = null): RDD[T]

Ø 函数说明

将数据集中重复的数据去重

val dataRDD = sparkContext.makeRDD(List(

1,2,3,4,1,2

),1)

val dataRDD1 = dataRDD.distinct()

val dataRDD2 = dataRDD.distinct(2)

img思考一个问题:如果不用该算子,你有什么办法实现数据去重?

10) coalesce

Ø 函数签名

def coalesce(numPartitions: Int, shuffle: Boolean = false,

​ partitionCoalescer: Option[PartitionCoalescer] = Option.empty)

​ (implicit ord: Ordering[T] = null)

: RDD[T]

Ø 函数说明

根据数据量缩减分区,用于大数据集过滤后,提高小数据集的执行效率

当spark程序中,存在过多的小任务的时候,可以通过coalesce方法,收缩合并分区,减少分区的个数,减小任务调度成本

val dataRDD = sparkContext.makeRDD(List(

1,2,3,4,1,2

),6)

val dataRDD1 = dataRDD.coalesce(2)

img思考一个问题:我想要扩大分区,怎么办?

11) repartition

Ø 函数签名

def repartition(numPartitions: Int)(implicit ord: Ordering[T] = null): RDD[T]

Ø 函数说明

该操作内部其实执行的是coalesce操作,参数shuffle的默认值为true。无论是将分区数多的RDD转换为分区数少的RDD,还是将分区数少的RDD转换为分区数多的RDD,repartition操作都可以完成,因为无论如何都会经shuffle过程。

val dataRDD = sparkContext.makeRDD(List(

1,2,3,4,1,2

),2)

val dataRDD1 = dataRDD.repartition(4)

思考一个问题:coalesce和repartition区别?

12) sortBy

Ø 函数签名

def sortBy[K](

f: (T) => K,

ascending: Boolean = true,

numPartitions: Int = this.partitions.length)

(implicit ord: Ordering[K], ctag: ClassTag[K]): RDD[T]

Ø 函数说明

该操作用于排序数据。在排序之前,可以将数据通过f函数进行处理,之后按照f函数处理的结果进行排序,默认为升序排列。排序后新产生的RDD的分区数与原RDD的分区数一致。中间存在shuffle的过程

val dataRDD = sparkContext.makeRDD(List(

1,2,3,4,1,2

),2)

val dataRDD1 = dataRDD.sortBy(num=>num, false, 4)

l 双Value类型

13) intersection

Ø 函数签名

def intersection(other: RDD[T]): RDD[T]

Ø 函数说明

对源RDD和参数RDD求交集后返回一个新的RDD

val dataRDD1 = sparkContext.makeRDD(List(1,2,3,4))

val dataRDD2 = sparkContext.makeRDD(List(3,4,5,6))

val dataRDD = dataRDD1.intersection(dataRDD2)

img思考一个问题:如果两个RDD数据类型不一致怎么办?

14) union

Ø 函数签名

def union(other: RDD[T]): RDD[T]

Ø 函数说明

对源RDD和参数RDD求并集后返回一个新的RDD

val dataRDD1 = sparkContext.makeRDD(List(1,2,3,4))

val dataRDD2 = sparkContext.makeRDD(List(3,4,5,6))

val dataRDD = dataRDD1.union(dataRDD2)

img思考一个问题:如果两个RDD数据类型不一致怎么办?

15) subtract

Ø 函数签名

def subtract(other: RDD[T]): RDD[T]

Ø 函数说明

以一个RDD元素为主,去除两个RDD中重复元素,将其他元素保留下来。求差集

val dataRDD1 = sparkContext.makeRDD(List(1,2,3,4))

val dataRDD2 = sparkContext.makeRDD(List(3,4,5,6))

val dataRDD = dataRDD1.subtract(dataRDD2)

思考一个问题:如果两个RDD数据类型不一致怎么办?

16) zip

Ø 函数签名

def zip[U: ClassTag](other: RDD[U]): RDD[(T, U)]

Ø 函数说明

将两个RDD中的元素,以键值对的形式进行合并。其中,键值对中的Key为第1个RDD中的元素,Value为第2个RDD中的相同位置的元素。

val dataRDD1 = sparkContext.makeRDD(List(1,2,3,4))

val dataRDD2 = sparkContext.makeRDD(List(3,4,5,6))

val dataRDD = dataRDD1.zip(dataRDD2)

img思考一个问题:如果两个RDD数据类型不一致怎么办?

img思考一个问题:如果两个RDD数据分区不一致怎么办?

img思考一个问题:如果两个RDD分区数据数量不一致怎么办?

l Key - Value类型

17) partitionBy

Ø 函数签名

def partitionBy(partitioner: Partitioner): RDD[(K, V)]

Ø 函数说明

将数据按照指定Partitioner重新进行分区。Spark默认的分区器是HashPartitioner

val rdd: RDD[(Int, String)] =

sc.makeRDD(Array((1,”aaa”),(2,”bbb”),(3,”ccc”)),3)

import org.apache.spark.HashPartitioner

val rdd2: RDD[(Int, String)] =

rdd.partitionBy(new HashPartitioner(2))

img思考一个问题:如果重分区的分区器和当前RDD的分区器一样怎么办?

img思考一个问题:Spark还有其他分区器吗?

img思考一个问题:如果想按照自己的方法进行数据分区怎么办?

img思考一个问题:哪那么多问题?

18) reduceByKey

Ø 函数签名

def reduceByKey(func: (V, V) => V): RDD[(K, V)]

def reduceByKey(func: (V, V) => V, numPartitions: Int): RDD[(K, V)]

Ø 函数说明

可以将数据按照相同的Key对Value进行聚合

val dataRDD1 = sparkContext.makeRDD(List((“a”,1),(“b”,2),(“c”,3)))

val dataRDD2 = dataRDD1.reduceByKey(+)

val dataRDD3 = dataRDD1.reduceByKey(+, 2)

v 小功能:WordCount

19) groupByKey

Ø 函数签名

def groupByKey(): RDD[(K, Iterable[V])]

def groupByKey(numPartitions: Int): RDD[(K, Iterable[V])]

def groupByKey(partitioner: Partitioner): RDD[(K, Iterable[V])]

Ø 函数说明

将数据源的数据根据key对value进行分组

val dataRDD1 =

sparkContext.makeRDD(List((“a”,1),(“b”,2),(“c”,3)))

val dataRDD2 = dataRDD1.groupByKey()

val dataRDD3 = dataRDD1.groupByKey(2)

val dataRDD4 = dataRDD1.groupByKey(new HashPartitioner(2))

考一个问题:reduceByKey和groupByKey的区别?

从shuffle的角度:reduceByKey和groupByKey都存在shuffle的操作,但是reduceByKey可以在shuffle前对分区内相同key的数据进行预聚合(combine)功能,这样会减少落盘的数据量,而groupByKey只是进行分组,不存在数据量减少的问题,reduceByKey性能比较高。

从功能的角度:reduceByKey其实包含分组和聚合的功能。groupByKey只能分组,不能聚合,所以在分组聚合的场合下,推荐使用reduceByKey,如果仅仅是分组而不需要聚合。那么还是只能使用groupByKey

v 小功能:WordCount

20) aggregateByKey

Ø 函数签名

def aggregateByKey[U: ClassTag](zeroValue: U)(seqOp: (U, V) => U,

combOp: (U, U) => U): RDD[(K, U)]

Ø 函数说明

将数据根据不同的规则进行分区内计算和分区间计算

val dataRDD1 =

sparkContext.makeRDD(List((“a”,1),(“b”,2),(“c”,3)))

val dataRDD2 =

dataRDD1.aggregateByKey(0)(+,+)

v 取出每个分区内相同key的最大值然后分区间相加

// TODO : 取出每个分区内相同key的最大值然后分区间相加

// aggregateByKey算子是函数柯里化,存在两个参数列表

// 1. 第一个参数列表中的参数表示初始值

// 2. 第二个参数列表中含有两个参数

// 2.1 第一个参数表示分区内的计算规则

// 2.2 第二个参数表示分区间的计算规则

val rdd =

sc.makeRDD(List(

​ (“a”,1),(“a”,2),(“c”,3),

​ (“b”,4),(“c”,5),(“c”,6)

),2)

// 0:(“a”,1),(“a”,2),(“c”,3) => (a,10)(c,10)

// => (a,10)(b,10)(c,20)

// 1:(“b”,4),(“c”,5),(“c”,6) => (b,10)(c,10)

val resultRDD =

rdd.aggregateByKey(10)(

​ (x, y) => math.max(x,y),

​ (x, y) => x + y

)

resultRDD.collect().foreach(println)

img思考一个问题:分区内计算规则和分区间计算规则相同怎么办?(WordCount)

21) foldByKey

Ø 函数签名

def foldByKey(zeroValue: V)(func: (V, V) => V): RDD[(K, V)]

Ø 函数说明

当分区内计算规则和分区间计算规则相同时,aggregateByKey就可以简化为foldByKey

val dataRDD1 = sparkContext.makeRDD(List((“a”,1),(“b”,2),(“c”,3)))

val dataRDD2 = dataRDD1.foldByKey(0)(+)

22) combineByKey

Ø 函数签名

def combineByKey[C](

createCombiner: V => C,

mergeValue: (C, V) => C,

mergeCombiners: (C, C) => C): RDD[(K, C)]

Ø 函数说明

最通用的对key-value型rdd进行聚集操作的聚集函数(aggregation function)。类似于aggregate(),combineByKey()允许用户返回值的类型与输入不一致。

小练习:将数据List((“a”, 88), (“b”, 95), (“a”, 91), (“b”, 93), (“a”, 95), (“b”, 98))求每个key的平均值

val list: List[(String, Int)] = List((“a”, 88), (“b”, 95), (“a”, 91), (“b”, 93), (“a”, 95), (“b”, 98))

val input: RDD[(String, Int)] = sc.makeRDD(list, 2)

val combineRdd: RDD[(String, (Int, Int))] = input.combineByKey(

(_, 1),

(acc: (Int, Int), v) => (acc._1 + v, acc._2 + 1),

(acc1: (Int, Int), acc2: (Int, Int)) => (acc1._1 + acc2._1, acc1._2 + acc2._2)

)

img思考一个问题:reduceByKey、foldByKey、aggregateByKey、combineByKey的区别?

reduceByKey: 相同key的第一个数据不进行任何计算,分区内和分区间计算规则相同

foldByKey: 相同key的第一个数据和初始值进行分区内计算,分区内和分区间计算规则相同

aggregateByKey:相同key的第一个数据和初始值进行分区内计算,分区内和分区间计算规则可以不相同

combineByKey:当计算时,发现数据结构不满足要求时,可以让第一个数据转换结构。分区内和分区间计算规则不相同。

23) sortByKey

Ø 函数签名

def sortByKey(ascending: Boolean = true, numPartitions: Int = self.partitions.length)

: RDD[(K, V)]

Ø 函数说明

在一个(K,V)的RDD上调用,K必须实现Ordered接口(特质),返回一个按照key进行排序的

val dataRDD1 = sparkContext.makeRDD(List((“a”,1),(“b”,2),(“c”,3)))

val sortRDD1: RDD[(String, Int)] = dataRDD1.sortByKey(true)

val sortRDD1: RDD[(String, Int)] = dataRDD1.sortByKey(false)

v 小功能:设置key为自定义类User

24) join

Ø 函数签名

def join[W](other: RDD[(K, W)]): RDD[(K, (V, W))]

Ø 函数说明

在类型为(K,V)和(K,W)的RDD上调用,返回一个相同key对应的所有元素连接在一起的(K,(V,W))的RDD

val rdd: RDD[(Int, String)] = sc.makeRDD(Array((1, “a”), (2, “b”), (3, “c”)))

val rdd1: RDD[(Int, Int)] = sc.makeRDD(Array((1, 4), (2, 5), (3, 6)))

rdd.join(rdd1).collect().foreach(println)

img思考一个问题:如果key存在不相等呢?
25) leftOuterJoin

Ø 函数签名

def leftOuterJoin[W](other: RDD[(K, W)]): RDD[(K, (V, Option[W]))]

Ø 函数说明

类似于SQL语句的左外连接

val dataRDD1 = sparkContext.makeRDD(List((“a”,1),(“b”,2),(“c”,3)))

val dataRDD2 = sparkContext.makeRDD(List((“a”,1),(“b”,2),(“c”,3)))

val rdd: RDD[(String, (Int, Option[Int]))] = dataRDD1.leftOuterJoin(dataRDD2)

26) cogroup

Ø 函数签名

def cogroup[W](other: RDD[(K, W)]): RDD[(K, (Iterable[V], Iterable[W]))]

Ø 函数说明

在类型为(K,V)和(K,W)的RDD上调用,返回一个(K,(Iterable,Iterable))类型的RDD

val dataRDD1 = sparkContext.makeRDD(List((“a”,1),(“a”,2),(“c”,3)))

val dataRDD2 = sparkContext.makeRDD(List((“a”,1),(“c”,2),(“c”,3)))

val value: RDD[(String, (Iterable[Int], Iterable[Int]))] =

dataRDD1.cogroup(dataRDD2)

2.1.4.4 案例实操

  1. 数据准备

agent.log:时间戳,省份,城市,用户,广告,中间字段使用空格分隔。

  1. 需求描述

统计出每一个省份每个广告被点击数量排行的Top3

  1. 需求分析

  2. 功能实现

2.1.4.5 RDD行动算子

1) reduce

Ø 函数签名

def reduce(f: (T, T) => T): T

Ø 函数说明

聚集RDD中的所有元素,先聚合分区内数据,再聚合分区间数据

val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4))

// 聚合数据

val reduceResult: Int = rdd.reduce(+)

2) collect

Ø 函数签名

def collect(): Array[T]

Ø 函数说明

在驱动程序(Driver)中,以数组Array的形式返回数据集的所有元素

val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4))

// 收集数据到Driver

rdd.collect().foreach(println)

3) count

Ø 函数签名

def count(): Long

Ø 函数说明

返回RDD中元素的个数

val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4))

// 返回RDD中元素的个数

val countResult: Long = rdd.count()

4) first

Ø 函数签名

def first(): T

Ø 函数说明

返回RDD中的第一个元素

val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4))

// 返回RDD中元素的个数

val firstResult: Int = rdd.first()

println(firstResult)

5) take

Ø 函数签名

def take(num: Int): Array[T]

Ø 函数说明

返回一个由RDD的前n个元素组成的数组

vval rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4))

// 返回RDD中元素的个数

val takeResult: Array[Int] = rdd.take(2)

println(takeResult.mkString(“,”))

6) takeOrdered

Ø 函数签名

def takeOrdered(num: Int)(implicit ord: Ordering[T]): Array[T]

Ø 函数说明

返回该RDD排序后的前n个元素组成的数组

val rdd: RDD[Int] = sc.makeRDD(List(1,3,2,4))

// 返回RDD中元素的个数

val result: Array[Int] = rdd.takeOrdered(2)

7) aggregate

Ø 函数签名

def aggregate[U: ClassTag](zeroValue: U)(seqOp: (U, T) => U, combOp: (U, U) => U): U

Ø 函数说明

分区的数据通过初始值和分区内的数据进行聚合,然后再和初始值进行分区间的数据聚合

val rdd: RDD[Int] = sc.makeRDD(List(1, 2, 3, 4), 8)

// 将该RDD所有元素相加得到结果

//val result: Int = rdd.aggregate(0)(_ + _, _ + _)

val result: Int = rdd.aggregate(10)(_ + _, _ + _)

8) fold

Ø 函数签名

def fold(zeroValue: T)(op: (T, T) => T): T

Ø 函数说明

折叠操作,aggregate的简化版操作

val rdd: RDD[Int] = sc.makeRDD(List(1, 2, 3, 4))

val foldResult: Int = rdd.fold(0)(+)

9) countByKey

Ø 函数签名

def countByKey(): Map[K, Long]

Ø 函数说明

统计每种key的个数

val rdd: RDD[(Int, String)] = sc.makeRDD(List((1, “a”), (1, “a”), (1, “a”), (2, “b”), (3, “c”), (3, “c”)))

// 统计每种key的个数

val result: collection.Map[Int, Long] = rdd.countByKey()

10) save相关算子

Ø 函数签名

def saveAsTextFile(path: String): Unit

def saveAsObjectFile(path: String): Unit

def saveAsSequenceFile(

path: String,

codec: Option[Class[_ <: CompressionCodec]] = None): Unit

Ø 函数说明

将数据保存到不同格式的文件中

// 保存成Text文件

rdd.saveAsTextFile(“output”)

// 序列化成对象保存到文件

rdd.saveAsObjectFile(“output1”)

// 保存成Sequencefile文件

rdd.map((_,1)).saveAsSequenceFile(“output2”)

11) foreach

Ø 函数签名

def foreach(f: T => Unit): Unit = withScope {

val cleanF = sc.clean(f)

sc.runJob(this, (iter: Iterator[T]) => iter.foreach(cleanF))

}

Ø 函数说明

分布式遍历RDD中的每一个元素,调用指定函数

val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4))

// 收集后打印

rdd.map(num=>num).collect().foreach(println)

println(“****“)

// 分布式打印

rdd.foreach(println)

2.1.4.6 RDD序列化

  1. 闭包检查

从计算的角度, 算子以外的代码都是在Driver端执行, 算子里面的代码都是在Executor端执行。那么在scala的函数式编程中,就会导致算子内经常会用到算子外的数据,这样就形成了闭包的效果,如果使用的算子外的数据无法序列化,就意味着无法传值给Executor端执行,就会发生错误,所以需要在执行任务计算前,检测闭包内的对象是否可以进行序列化,这个操作我们称之为闭包检测。Scala2.12版本后闭包编译方式发生了改变

  1. 序列化方法和属性

从计算的角度, 算子以外的代码都是在Driver端执行, 算子里面的代码都是在Executor端执行,看如下代码:

object serializable02_function {

def main(args: Array[String]): Unit = {

​ //1.创建SparkConf并设置App名称

​ val conf: SparkConf = new SparkConf().setAppName(“SparkCoreTest”).setMaster(“local[*]”)

​ //2.创建SparkContext,该对象是提交Spark App的入口

​ val sc: SparkContext = new SparkContext(conf)

​ //3.创建一个RDD

​ val rdd: RDD[String] = sc.makeRDD(Array(“hello world”, “hello spark”, “hive”, “atguigu”))

​ //3.1创建一个Search对象

​ val search = new Search(“hello”)

​ //3.2 函数传递,打印:ERROR Task not serializable

​ search.getMatch1(rdd).collect().foreach(println)

​ //3.3 属性传递,打印:ERROR Task not serializable

​ search.getMatch2(rdd).collect().foreach(println)

​ //4.关闭连接

​ sc.stop()

}

}

class Search(query:String) extends Serializable {

def isMatch(s: String): Boolean = {

​ s.contains(query)

}

// 函数序列化案例

def getMatch1 (rdd: RDD[String]): RDD[String] = {

​ //rdd.filter(this.isMatch)

​ rdd.filter(isMatch)

}

// 属性序列化案例

def getMatch2(rdd: RDD[String]): RDD[String] = {

​ //rdd.filter(x => x.contains(this.query))

​ rdd.filter(x => x.contains(query))

​ //val q = query

​ //rdd.filter(x => x.contains(q))

}

}

  1. Kryo序列化框架

参考地址: https://github.com/EsotericSoftware/kryo

Java的序列化能够序列化任何的类。但是比较重(字节多),序列化后,对象的提交也比较大。Spark出于性能的考虑,Spark2.0开始支持另外一种Kryo序列化机制。Kryo速度是Serializable的10倍。当RDD在Shuffle数据的时候,简单数据类型、数组和字符串类型已经在Spark内部使用Kryo来序列化。

注意:即使使用Kryo序列化,也要继承Serializable接口。

object serializable_Kryo {

def main(args: Array[String]): Unit = {

​ val conf: SparkConf = new SparkConf()

​ .setAppName(“SerDemo”)

​ .setMaster(“local[*]”)

​ // 替换默认的序列化机制

​ .set(“spark.serializer”, “org.apache.spark.serializer.KryoSerializer”)

​ // 注册需要使用 kryo 序列化的自定义类

​ .registerKryoClasses(Array(classOf[Searcher]))

​ val sc = new SparkContext(conf)

​ val rdd: RDD[String] = sc.makeRDD(Array(“hello world”, “hello atguigu”, “atguigu”, “hahah”), 2)

​ val searcher = new Searcher(“hello”)

​ val result: RDD[String] = searcher.getMatchedRDD1(rdd)

​ result.collect.foreach(println)

}

}

case class Searcher(val query: String) {

def isMatch(s: String) = {

​ s.contains(query)

}

def getMatchedRDD1(rdd: RDD[String]) = {

​ rdd.filter(isMatch)

}

def getMatchedRDD2(rdd: RDD[String]) = {

​ val q = query

​ rdd.filter(_.contains(q))

}

}

2.1.4.7 RDD依赖关系

  1. RDD 血缘关系

RDD只支持粗粒度转换,即在大量记录上执行的单个操作。将创建RDD的一系列Lineage(血统)记录下来,以便恢复丢失的分区。RDD的Lineage会记录RDD的元数据信息和转换行为,当该RDD的部分分区数据丢失时,它可以根据这些信息来重新运算和恢复丢失的数据分区。

val fileRDD: RDD[String] = sc.textFile(“input/1.txt”)

println(fileRDD.toDebugString)

println(“———————-“)

val wordRDD: RDD[String] = fileRDD.flatMap(_.split(“ “))

println(wordRDD.toDebugString)

println(“———————-“)

val mapRDD: RDD[(String, Int)] = wordRDD.map((_,1))

println(mapRDD.toDebugString)

println(“———————-“)

val resultRDD: RDD[(String, Int)] = mapRDD.reduceByKey(+)

println(resultRDD.toDebugString)

resultRDD.collect()

  1. RDD 依赖关系

这里所谓的依赖关系,其实就是两个相邻RDD之间的关系

val sc: SparkContext = new SparkContext(conf)

val fileRDD: RDD[String] = sc.textFile(“input/1.txt”)

println(fileRDD.dependencies)

println(“———————-“)

val wordRDD: RDD[String] = fileRDD.flatMap(_.split(“ “))

println(wordRDD.dependencies)

println(“———————-“)

val mapRDD: RDD[(String, Int)] = wordRDD.map((_,1))

println(mapRDD.dependencies)

println(“———————-“)

val resultRDD: RDD[(String, Int)] = mapRDD.reduceByKey(+)

println(resultRDD.dependencies)

resultRDD.collect()

  1. RDD 窄依赖

窄依赖表示每一个父(上游)RDD的Partition最多被子(下游)RDD的一个Partition使用,窄依赖我们形象的比喻为独生子女。

class OneToOneDependency[T](rdd: RDD[T]) extends NarrowDependencyT

  1. RDD 宽依赖

宽依赖表示同一个父(上游)RDD的Partition被多个子(下游)RDD的Partition依赖,会引起Shuffle,总结:宽依赖我们形象的比喻为多生。

class ShuffleDependency[K: ClassTag, V: ClassTag, C: ClassTag](

@transient private val rdd: RDD[ <: Product2[K, V]],

val partitioner: Partitioner,

val serializer: Serializer = SparkEnv.get.serializer,

val keyOrdering: Option[Ordering[K]] = None,

val aggregator: Option[Aggregator[K, V, C]] = None,

val mapSideCombine: Boolean = false)

extends Dependency[Product2[K, V]]

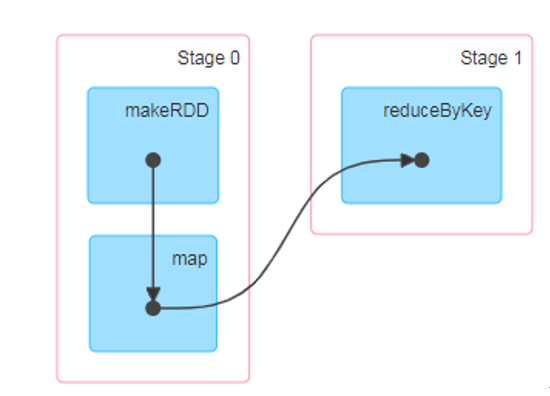
  1. RDD 阶段划分

DAG(Directed Acyclic Graph)有向无环图是由点和线组成的拓扑图形,该图形具有方向,不会闭环。例如,DAG记录了RDD的转换过程和任务的阶段。

img img img

  1. RDD 阶段划分源码

try {

// New stage creation may throw an exception if, for example, jobs are run on a

// HadoopRDD whose underlying HDFS files have been deleted.

finalStage = createResultStage(finalRDD, func, partitions, jobId, callSite)

} catch {

case e: Exception =>

logWarning(“Creating new stage failed due to exception - job: “ + jobId, e)

listener.jobFailed(e)

return

}

……

private def createResultStage(

rdd: RDD[_],

func: (TaskContext, Iterator[_]) => _,

partitions: Array[Int],

jobId: Int,

callSite: CallSite): ResultStage = {

val parents = getOrCreateParentStages(rdd, jobId)

val id = nextStageId.getAndIncrement()

val stage = new ResultStage(id, rdd, func, partitions, parents, jobId, callSite)

stageIdToStage(id) = stage

updateJobIdStageIdMaps(jobId, stage)

stage

}

……

private def getOrCreateParentStages(rdd: RDD[_], firstJobId: Int): List[Stage] = {

getShuffleDependencies(rdd).map { shuffleDep =>

getOrCreateShuffleMapStage(shuffleDep, firstJobId)

}.toList

}

……

private[scheduler] def getShuffleDependencies(

rdd: RDD[]): HashSet[ShuffleDependency[, _, _]] = {

val parents = new HashSet[ShuffleDependency[_, _, _]]

val visited = new HashSet[RDD[_]]

val waitingForVisit = new Stack[RDD[_]]

waitingForVisit.push(rdd)

while (waitingForVisit.nonEmpty) {

val toVisit = waitingForVisit.pop()

if (!visited(toVisit)) {

visited += toVisit

toVisit.dependencies.foreach {

case shuffleDep: ShuffleDependency[_, _, _] =>

​ parents += shuffleDep

case dependency =>

​ waitingForVisit.push(dependency.rdd)

}

}

}

parents

}

  1. RDD 任务划分

RDD任务切分中间分为:Application、Job、Stage和Task

l Application:初始化一个SparkContext即生成一个Application;

l Job:一个Action算子就会生成一个Job;

l Stage:Stage等于宽依赖(ShuffleDependency)的个数加1;

l Task:一个Stage阶段中,最后一个RDD的分区个数就是Task的个数。

注意:Application->Job->Stage->Task每一层都是1对n的关系。

img

  1. RDD 任务划分源码

val tasks: Seq[Task[_]] = try {

stage match {

case stage: ShuffleMapStage =>

partitionsToCompute.map { id =>

​ val locs = taskIdToLocations(id)

​ val part = stage.rdd.partitions(id)

​ new ShuffleMapTask(stage.id, stage.latestInfo.attemptId,

​ taskBinary, part, locs, stage.latestInfo.taskMetrics, properties, Option(jobId),

​ Option(sc.applicationId), sc.applicationAttemptId)

}

case stage: ResultStage =>

partitionsToCompute.map { id =>

​ val p: Int = stage.partitions(id)

​ val part = stage.rdd.partitions(p)

​ val locs = taskIdToLocations(id)

​ new ResultTask(stage.id, stage.latestInfo.attemptId,

​ taskBinary, part, locs, id, properties, stage.latestInfo.taskMetrics,

​ Option(jobId), Option(sc.applicationId), sc.applicationAttemptId)

}

}

……

val partitionsToCompute: Seq[Int] = stage.findMissingPartitions()

……

override def findMissingPartitions(): Seq[Int] = {

mapOutputTrackerMaster

.findMissingPartitions(shuffleDep.shuffleId)

.getOrElse(0 until numPartitions)

}

2.1.4.8 RDD持久化

  1. RDD Cache缓存

RDD通过Cache或者Persist方法将前面的计算结果缓存,默认情况下会把数据以缓存在JVM的堆内存中。但是并不是这两个方法被调用时立即缓存,而是触发后面的action算子时,该RDD将会被缓存在计算节点的内存中,并供后面重用。

// cache操作会增加血缘关系,不改变原有的血缘关系

println(wordToOneRdd.toDebugString)

// 数据缓存。

wordToOneRdd.cache()

// 可以更改存储级别

//mapRdd.persist(StorageLevel.MEMORY_AND_DISK_2)

存储级别

object StorageLevel {

val NONE = new StorageLevel(false, false, false, false)

val DISK_ONLY = new StorageLevel(true, false, false, false)

val DISK_ONLY_2 = new StorageLevel(true, false, false, false, 2)

val MEMORY_ONLY = new StorageLevel(false, true, false, true)

val MEMORY_ONLY_2 = new StorageLevel(false, true, false, true, 2)

val MEMORY_ONLY_SER = new StorageLevel(false, true, false, false)

val MEMORY_ONLY_SER_2 = new StorageLevel(false, true, false, false, 2)

val MEMORY_AND_DISK = new StorageLevel(true, true, false, true)

val MEMORY_AND_DISK_2 = new StorageLevel(true, true, false, true, 2)

val MEMORY_AND_DISK_SER = new StorageLevel(true, true, false, false)

val MEMORY_AND_DISK_SER_2 = new StorageLevel(true, true, false, false, 2)

val OFF_HEAP = new StorageLevel(true, true, true, false, 1)

img

缓存有可能丢失,或者存储于内存的数据由于内存不足而被删除,RDD的缓存容错机制保证了即使缓存丢失也能保证计算的正确执行。通过基于RDD的一系列转换,丢失的数据会被重算,由于RDD的各个Partition是相对独立的,因此只需要计算丢失的部分即可,并不需要重算全部Partition。

Spark会自动对一些Shuffle操作的中间数据做持久化操作(比如:reduceByKey)。这样做的目的是为了当一个节点Shuffle失败了避免重新计算整个输入。但是,在实际使用的时候,如果想重用数据,仍然建议调用persist或cache。

  1. RDD CheckPoint检查点

所谓的检查点其实就是通过将RDD中间结果写入磁盘

由于血缘依赖过长会造成容错成本过高,这样就不如在中间阶段做检查点容错,如果检查点之后有节点出现问题,可以从检查点开始重做血缘,减少了开销。

对RDD进行checkpoint操作并不会马上被执行,必须执行Action操作才能触发。

// 设置检查点路径

sc.setCheckpointDir(“./checkpoint1”)

// 创建一个RDD,读取指定位置文件:hello atguigu atguigu

val lineRdd: RDD[String] = sc.textFile(“input/1.txt”)

// 业务逻辑

val wordRdd: RDD[String] = lineRdd.flatMap(line => line.split(“ “))

val wordToOneRdd: RDD[(String, Long)] = wordRdd.map {

word => {

​ (word, System.currentTimeMillis())

}

}

// 增加缓存,避免再重新跑一个job做checkpoint

wordToOneRdd.cache()

// 数据检查点:针对wordToOneRdd做检查点计算

wordToOneRdd.checkpoint()

// 触发执行逻辑

wordToOneRdd.collect().foreach(println)

  1. 缓存和检查点区别

1)Cache缓存只是将数据保存起来,不切断血缘依赖。Checkpoint检查点切断血缘依赖。

2)Cache缓存的数据通常存储在磁盘、内存等地方,可靠性低。Checkpoint的数据通常存储在HDFS等容错、高可用的文件系统,可靠性高。

3)建议对checkpoint()的RDD使用Cache缓存,这样checkpoint的job只需从Cache缓存中读取数据即可,否则需要再从头计算一次RDD。

2.1.4.9 RDD分区器

Spark目前支持Hash分区和Range分区,和用户自定义分区。Hash分区为当前的默认分区。分区器直接决定了RDD中分区的个数、RDD中每条数据经过Shuffle后进入哪个分区,进而决定了Reduce的个数。

Ø 只有Key-Value类型的RDD才有分区器,非Key-Value类型的RDD分区的值是None

Ø 每个RDD的分区ID范围:0 ~ (numPartitions - 1),决定这个值是属于那个分区的。

  1. Hash分区:对于给定的key,计算其hashCode,并除以分区个数取余

class HashPartitioner(partitions: Int) extends Partitioner {

require(partitions >= 0, s”Number of partitions ($partitions) cannot be negative.”)

def numPartitions: Int = partitions

def getPartition(key: Any): Int = key match {

case null => 0

case _ => Utils.nonNegativeMod(key.hashCode, numPartitions)

}

override def equals(other: Any): Boolean = other match {

case h: HashPartitioner =>

h.numPartitions == numPartitions

case _ =>

false

}

override def hashCode: Int = numPartitions

}

  1. Range分区:将一定范围内的数据映射到一个分区中,尽量保证每个分区数据均匀,而且分区间有序

class RangePartitioner[K : Ordering : ClassTag, V](

partitions: Int,

rdd: RDD[_ <: Product2[K, V]],

private var ascending: Boolean = true)

extends Partitioner {

// We allow partitions = 0, which happens when sorting an empty RDD under the default settings.

require(partitions >= 0, s”Number of partitions cannot be negative but found $partitions.”)

private var ordering = implicitly[Ordering[K]]

// An array of upper bounds for the first (partitions - 1) partitions

private var rangeBounds: Array[K] = {

…

}

def numPartitions: Int = rangeBounds.length + 1

private var binarySearch: ((Array[K], K) => Int) = CollectionsUtils.makeBinarySearch[K]

def getPartition(key: Any): Int = {

val k = key.asInstanceOf[K]

var partition = 0

if (rangeBounds.length <= 128) {

// If we have less than 128 partitions naive search

​ while (partition < rangeBounds.length && ordering.gt(k, rangeBounds(partition))) {

​ partition += 1

}

} else {

// Determine which binary search method to use only once.

partition = binarySearch(rangeBounds, k)

// binarySearch either returns the match location or -[insertion point]-1

if (partition < 0) {

​ partition = -partition-1

}

if (partition > rangeBounds.length) {

​ partition = rangeBounds.length

}

}

if (ascending) {

partition

} else {

rangeBounds.length - partition

}

}

override def equals(other: Any): Boolean = other match {

…

}

override def hashCode(): Int = {

…

}

@throws(classOf[IOException])

private def writeObject(out: ObjectOutputStream): Unit = Utils.tryOrIOException {

…

}

@throws(classOf[IOException])

private def readObject(in: ObjectInputStream): Unit = Utils.tryOrIOException {

…

}

}

2.1.4.10 RDD文件读取与保存

Spark的数据读取及数据保存可以从两个维度来作区分:文件格式以及文件系统。

文件格式分为:text文件、csv文件、sequence文件以及Object文件;

文件系统分为:本地文件系统、HDFS、HBASE以及数据库。

Ø text文件

// 读取输入文件

val inputRDD: RDD[String] = sc.textFile(“input/1.txt”)

// 保存数据

inputRDD.saveAsTextFile(“output”)

Ø sequence文件

SequenceFile文件是Hadoop用来存储二进制形式的key-value对而设计的一种平面文件(Flat File)。在SparkContext中,可以调用sequenceFilekeyClass, valueClass。

// 保存数据为SequenceFile

dataRDD.saveAsSequenceFile(“output”)

// 读取SequenceFile文件

sc.sequenceFileInt,Int.collect().foreach(println)

Ø object对象文件

对象文件是将对象序列化后保存的文件,采用Java的序列化机制。可以通过objectFileT: ClassTag函数接收一个路径,读取对象文件,返回对应的RDD,也可以通过调用saveAsObjectFile()实现对对象文件的输出。因为是序列化所以要指定类型。

// 保存数据

dataRDD.saveAsObjectFile(“output”)

// 读取数据

sc.objectFileInt.collect().foreach(println)

2.2 累加器

2.2.1 实现原理

累加器用来把Executor端变量信息聚合到Driver端。在Driver程序中定义的变量,在Executor端的每个Task都会得到这个变量的一份新的副本,每个task更新这些副本的值后,传回Driver端进行merge。

2.2.2 基础编程

2.2.2.1 系统累加器

val rdd = sc.makeRDD(List(1,2,3,4,5))
// 声明累加器
var sum = sc.longAccumulator("sum");
rdd.foreach(
  num => &#123;
    // 使用累加器
    sum.add(num)
  &#125;
)
// 获取累加器的值
println("sum = " + sum.value)

2.2.2.2 自定义累加器

// 自定义累加器
// 1. 继承AccumulatorV2,并设定泛型
// 2. 重写累加器的抽象方法
class WordCountAccumulator extends AccumulatorV2[String, mutable.Map[String, Long]]&#123;

var map : mutable.Map[String, Long] = mutable.Map()

// 累加器是否为初始状态
override def isZero: Boolean = &#123;
  map.isEmpty
&#125;

// 复制累加器
override def copy(): AccumulatorV2[String, mutable.Map[String, Long]] = &#123;
  new WordCountAccumulator
&#125;

// 重置累加器
override def reset(): Unit = &#123;
  map.clear()
&#125;

// 向累加器中增加数据 (In)
override def add(word: String): Unit = &#123;
    // 查询map中是否存在相同的单词
    // 如果有相同的单词,那么单词的数量加1
    // 如果没有相同的单词,那么在map中增加这个单词
    map(word) = map.getOrElse(word, 0L) + 1L
&#125;

// 合并累加器
override def merge(other: AccumulatorV2[String, mutable.Map[String, Long]]): Unit = &#123;

  val map1 = map
  val map2 = other.value

  // 两个Map的合并
  map = map1.foldLeft(map2)(
    ( innerMap, kv ) => &#123;
      innerMap(kv._1) = innerMap.getOrElse(kv._1, 0L) + kv._2
      innerMap
    &#125;
  )
&#125;

// 返回累加器的结果 (Out)
override def value: mutable.Map[String, Long] = map
&#125;

2.3 广播变量

2.3.1 实现原理

广播变量用来高效分发较大的对象。向所有工作节点发送一个较大的只读值,以供一个或多个Spark操作使用。比如,如果你的应用需要向所有节点发送一个较大的只读查询表,广播变量用起来都很顺手。在多个并行操作中使用同一个变量,但是 Spark会为每个任务分别发送。

2.3.2 基础编程

val rdd1 = sc.makeRDD(List( ("a",1), ("b", 2), ("c", 3), ("d", 4) ),4)
val list = List( ("a",4), ("b", 5), ("c", 6), ("d", 7) )
// 声明广播变量
val broadcast: Broadcast[List[(String, Int)]] = sc.broadcast(list)

val resultRDD: RDD[(String, (Int, Int))] = rdd1.map &#123;
  case (key, num) => &#123;
    var num2 = 0
    // 使用广播变量
    for ((k, v) <- broadcast.value) &#123;
      if (k == key) &#123;
        num2 = v
      &#125;
    &#125;
    (key, (num, num2))
  &#125;
&#125;

Spark学习笔记(一) 搭建Spark

1 Spark概述

1.1 spark or haddop

MR框架主要应用于数据的一次性计算:存存储介质中读取数据,然后进行过处理后,再存储到文件中。IO读取多,效率低。

1)Spark是基于MR框架的,但是优化了其中的计算过程,使用内存来代替计算结果。减少了磁盘IO,因此快。(MR多作业之间会多次磁盘的IO,因此慢)

2)Spark基于Scala语言开发的,更适合迭代计算和数据挖掘计算

3) Spark中计算模型非常丰富(MR中只有两个计算模型:mapper和reducer);spark的计算模型有:map,filter,groupby,sortby。

工作中:是Spark中和Yarn联合使用:资源用的是Yarn,计算用的是spark。

1638156481825

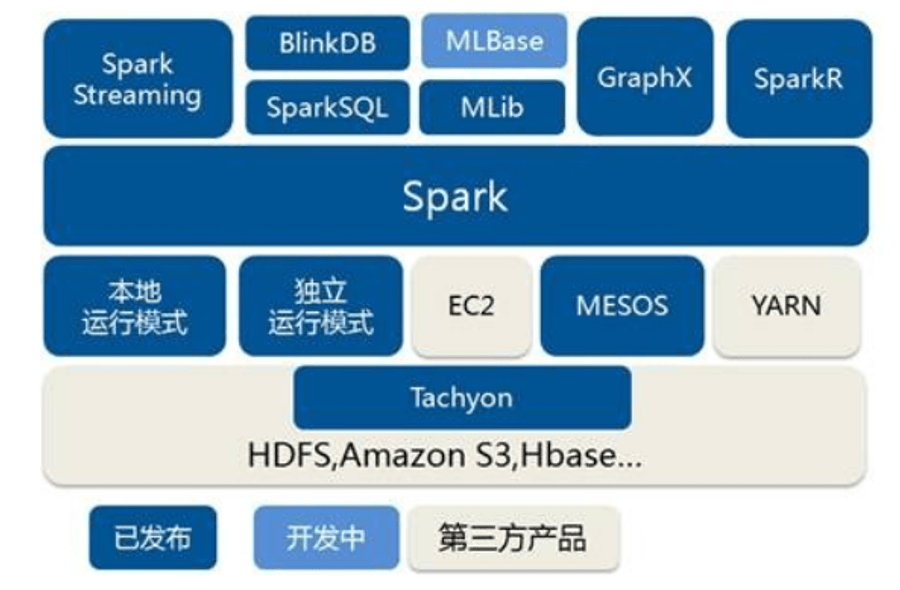
1.2 Spark核心模块

1.1 Spark 核心模块

1638176912041

1)Spark Core

Spark Core中提供了Spark最基础与最核心的功能,Spark其他的功能如:Spark SQL,Spark Streaming,GraphX, MLlib都是在Spark Core的基础上进行扩展的

2) Spark SQL

Spark SQL是Spark用来操作结构化数据的组件。通过Spark SQL,用户可以使用SQL或者Apache Hive版本的SQL方言(HQL)来查询数据。

  1. Spark Streaming

Spark Streaming是Spark平台上针对实时数据进行流式计算的组件,提供了丰富的处理数据流的API。

4) Spark MLlib

MLlib是Spark提供的一个机器学习算法库。MLlib不仅提供了模型评估、数据导入等额外的功能,还提供了一些更底层的机器学习原语。

5)Spark GraphX

GraphX是Spark面向图计算提供的框架与算法库。

2 Spark快速上手

在大数据早期的课程中我们已经学习了MapReduce框架的原理及基本使用,并了解了其底层数据处理的实现方式。接下来,就让咱们走进Spark的世界,了解一下它是如何带领我们完成数据处理的。

2.1 创建Maven项目

2.1.1 增加Scala插件

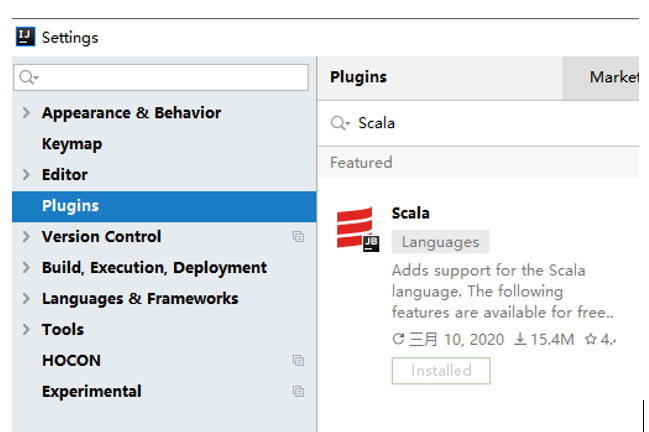
Spark由Scala语言开发的,所以本课件接下来的开发所使用的语言也为Scala,咱们当前使用的Spark版本为3.0.0,默认采用的Scala编译版本为2.12,所以后续开发时。我们依然采用这个版本。开发前请保证IDEA开发工具中含有Scala开发插件。

1638176561427

2.1.2 增加依赖关系

修改Maven项目中的POM文件,增加Spark框架的依赖关系。本课件基于Spark3.0版本,使用时请注意对应版本。

<dependencies>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-core_2.12</artifactId>
        <version>3.0.0</version>
    </dependency>
</dependencies>
<build>
    <plugins>
        <!-- 该插件用于将Scala代码编译成class文件 -->
        <plugin>
            <groupId>net.alchim31.maven</groupId>
            <artifactId>scala-maven-plugin</artifactId>
            <version>3.2.2</version>
            <executions>
                <execution>
                    <!-- 声明绑定到maven的compile阶段 -->
                    <goals>
                        <goal>testCompile</goal>
                    </goals>
                </execution>
            </executions>
        </plugin>
        <plugin>
            <groupId>org.apache.maven.plugins</groupId>
            <artifactId>maven-assembly-plugin</artifactId>
            <version>3.1.0</version>
            <configuration>
                <descriptorRefs>
                    <descriptorRef>jar-with-dependencies</descriptorRef>
                </descriptorRefs>
            </configuration>
            <executions>
                <execution>
                    <id>make-assembly</id>
                    <phase>package</phase>
                    <goals>
                        <goal>single</goal>
                    </goals>
                </execution>
            </executions>
        </plugin>
    </plugins>
</build>

2.1.3 WordCount

为了能直观地感受Spark框架的效果,接下来我们实现一个大数据学科中最常见的教学案例WordCount

// 创建Spark运行配置对象
val sparkConf = new SparkConf().setMaster("local[*]").setAppName("WordCount")

// 创建Spark上下文环境对象(连接对象)
val sc : SparkContext = new SparkContext(sparkConf)

// 读取文件数据
val fileRDD: RDD[String] = sc.textFile("input/word.txt")

// 将文件中的数据进行分词
val wordRDD: RDD[String] = fileRDD.flatMap( _.split(" ") )

// 转换数据结构 word => (word, 1)
val word2OneRDD: RDD[(String, Int)] = wordRDD.map((_,1))

// 将转换结构后的数据按照相同的单词进行分组聚合
val word2CountRDD: RDD[(String, Int)] = word2OneRDD.reduceByKey(_+_)

// 将数据聚合结果采集到内存中
val word2Count: Array[(String, Int)] = word2CountRDD.collect()

// 打印结果
word2Count.foreach(println)

//关闭Spark连接
sc.stop()

执行过程中,会产生大量的执行日志,如果为了能够更好的查看程序的执行结果,可以在项目的resources目录中创建log4j.properties文件,并添加日志配置信息:

log4j.rootCategory=ERROR, console
log4j.appender.console=org.apache.log4j.ConsoleAppender
log4j.appender.console.target=System.err
log4j.appender.console.layout=org.apache.log4j.PatternLayout
log4j.appender.console.layout.ConversionPattern=%d&#123;yy/MM/dd HH:mm:ss&#125; %p %c&#123;1&#125;: %m%n

# Set the default spark-shell log level to ERROR. When running the spark-shell, the
# log level for this class is used to overwrite the root logger's log level, so that
# the user can have different defaults for the shell and regular Spark apps.
log4j.logger.org.apache.spark.repl.Main=ERROR

# Settings to quiet third party logs that are too verbose
log4j.logger.org.spark_project.jetty=ERROR
log4j.logger.org.spark_project.jetty.util.component.AbstractLifeCycle=ERROR
log4j.logger.org.apache.spark.repl.SparkIMain$exprTyper=ERROR
log4j.logger.org.apache.spark.repl.SparkILoop$SparkILoopInterpreter=ERROR
log4j.logger.org.apache.parquet=ERROR
log4j.logger.parquet=ERROR

# SPARK-9183: Settings to avoid annoying messages when looking up nonexistent UDFs in SparkSQL with Hive support
log4j.logger.org.apache.hadoop.hive.metastore.RetryingHMSHandler=FATAL
log4j.logger.org.apache.hadoop.hive.ql.exec.FunctionRegistry=ERROR

2.1.4 异常处理

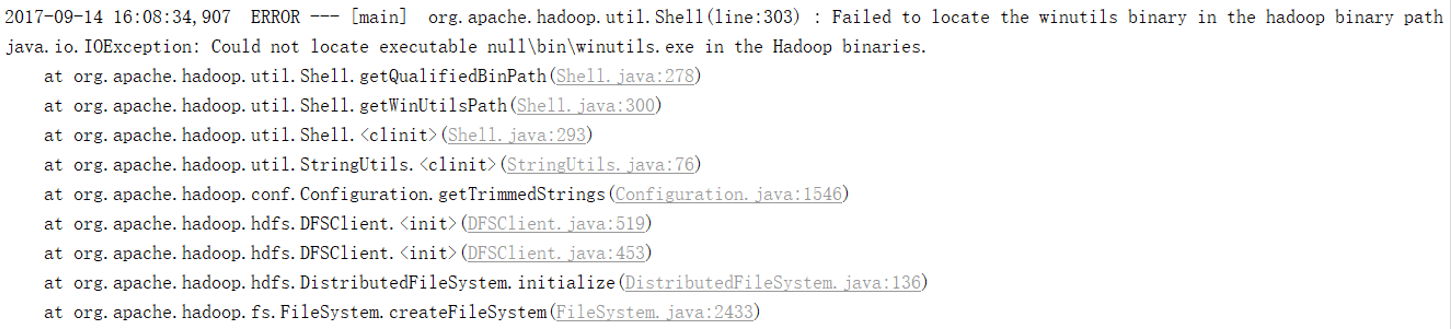
如果本机操作系统是Windows,在程序中使用了Hadoop相关的东西,比如写入文件到HDFS,则会遇到如下异常:

1638176731823

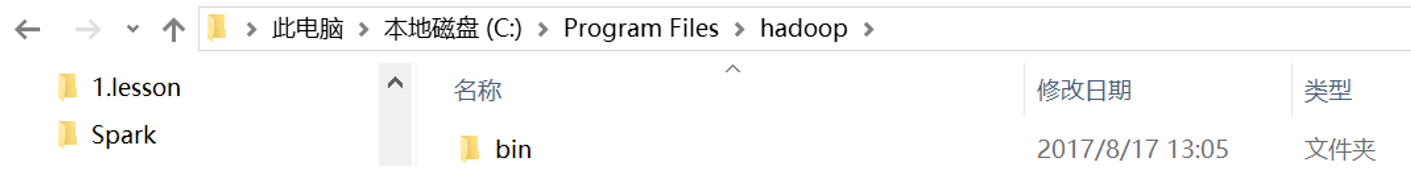
出现这个问题的原因,并不是程序的错误,而是windows系统用到了hadoop相关的服务,解决办法是通过配置关联到windows的系统依赖就可以了

1638176805506

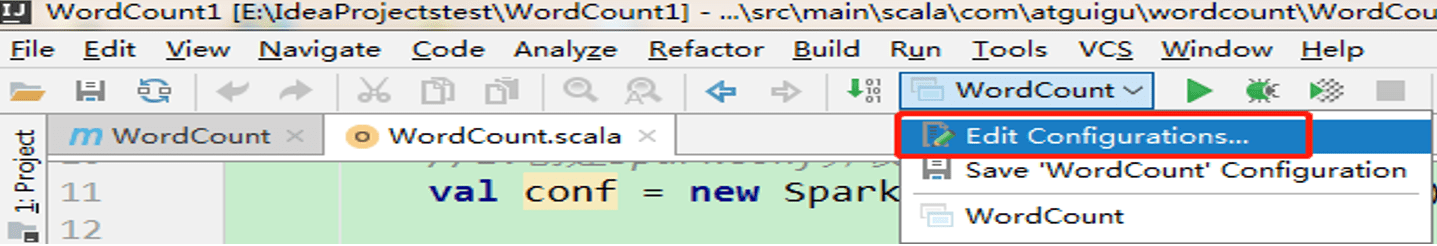
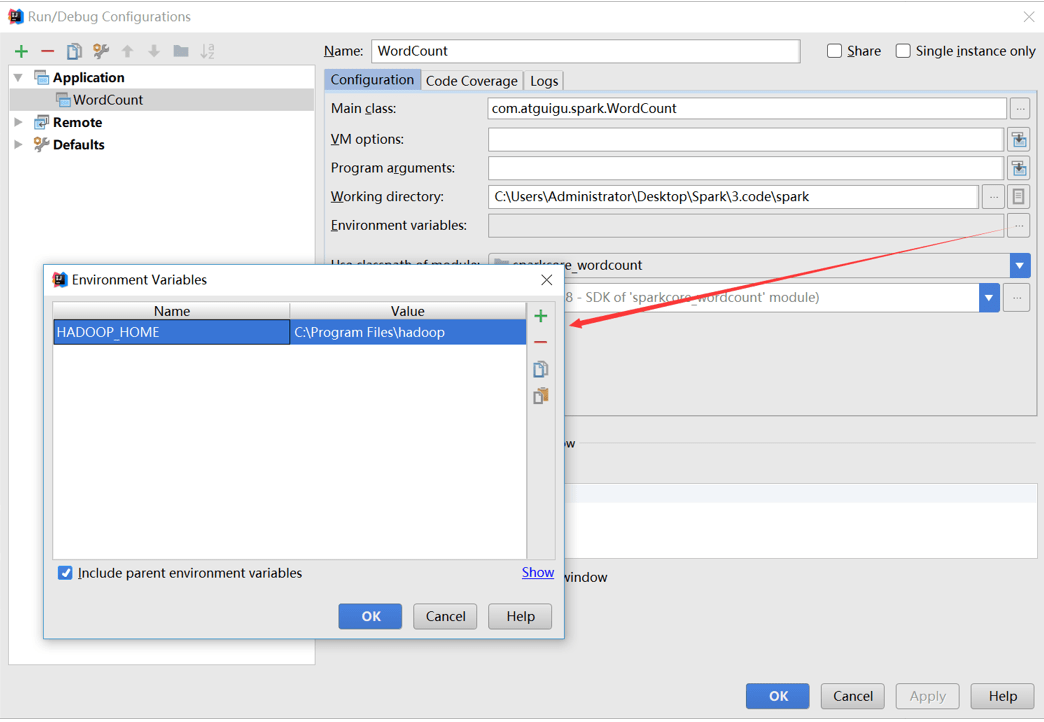
在IDEA中配置Run Configuration,添加HADOOP_HOME变量

1638176855314

1638176879056

3 Spark运行环境

Spark作为一个数据处理框架和计算引擎,被设计在所有常见的集群环境中运行, 在国内工作中主流的环境为Yarn,不过逐渐容器式环境也慢慢流行起来。接下来,我们就分别看看不同环境下Spark的运行。

1638176475372

3.1 Local模式

所谓的Local模式,就是不需要其他任何节点资源就可以在本地执行Spark代码的环境,一般用于教学,调试,演示等,之前在IDEA中运行代码的环境我们称之为开发环境,不太一样。(Local=本机提供资源+spark提供计算)

3.1.1 解压缩文件

将spark-3.0.0-bin-hadoop3.2.tgz文件上传到Linux并解压缩,放置在指定位置,路径中不要包含中文或空格,课件后续如果涉及到解压缩操作,不再强调。

tar -zxvf spark-3.0.0-bin-hadoop3.2.tgz -C /opt/module
cd /opt/module 
mv spark-3.0.0-bin-hadoop3.2 spark-local

3.1.2 启动Local环境

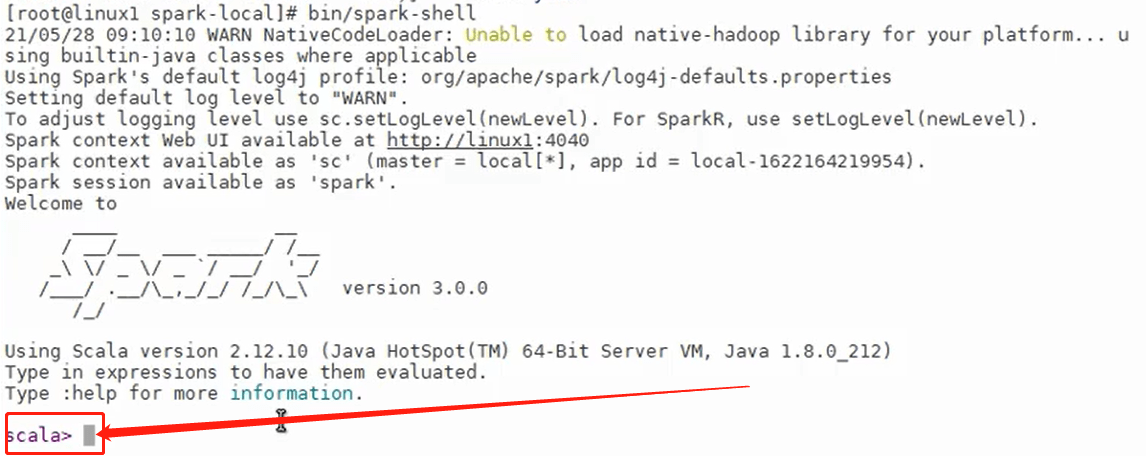
  1. 进入解压缩后的路径,执行如下指令
bin/spark-shell

1638173742050

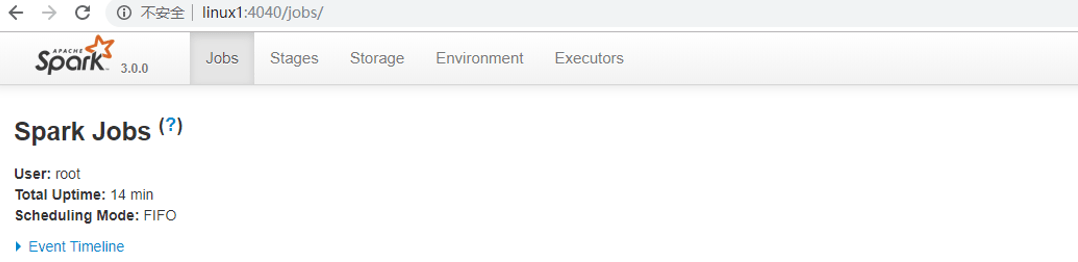
  1. 启动成功后,可以输入网址进行Web UI监控页面访问

http://虚拟机地址:4040

1638176427950

3.1.3 命令行工具

在解压缩文件夹下的data目录中,添加word.txt文件。在命令行工具中执行如下代码指令(和IDEA中代码简化版一致)

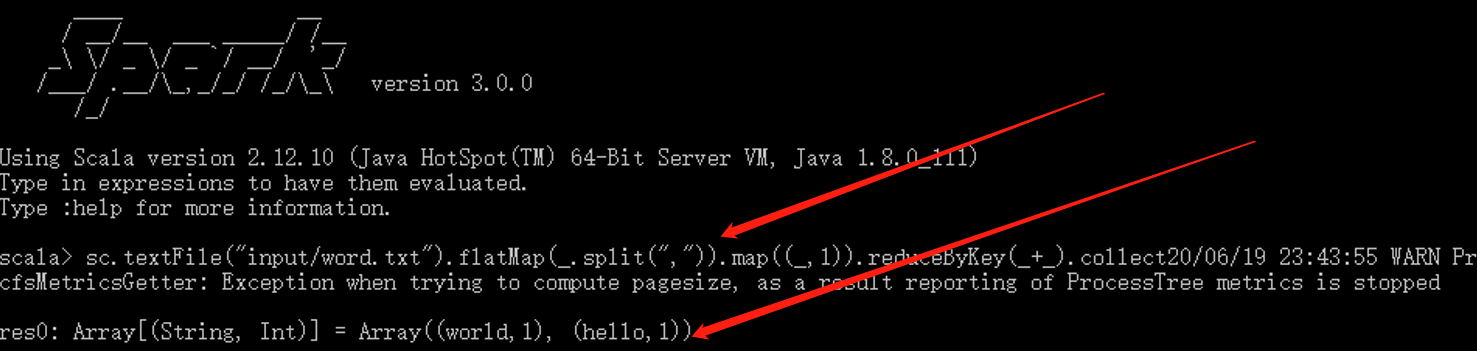
sc.textFile("data/word.txt").flatMap(_.split(" ")).map((_,1)).reduceByKey(_+_).collect

1638176440182

3.1.4 退出本地模式

按键Ctrl+C或输入Scala指令

:quit

3.1.5 提交应用

bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master local[2] \
./examples/jars/spark-examples_2.12-3.0.0.jar \
10
  1. –class表示要执行程序的主类,此处可以更换为咱们自己写的应用程序
  2. –master local[2] 部署模式,默认为本地模式,数字表示分配的虚拟CPU核数量;不知道可以用*
  3. spark-examples_2.12-3.0.0.jar 运行的应用类所在的jar包,实际使用时,可以设定为咱们自己打的jar包
  4. 数字10表示程序的入口参数,用于设定当前应用的任务数量

3.2 Standalone模式

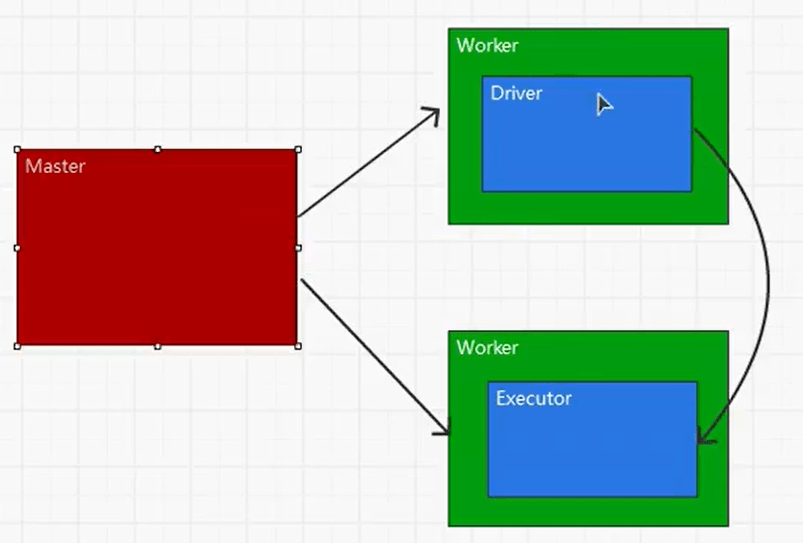
local本地模式毕竟只是用来进行练习演示的,真实工作中还是要将应用提交到对应的集群中去执行,这里我们来看看只使用Spark自身节点运行的集群模式,也就是我们所谓的独立部署(Standalone)模式。Spark的Standalone模式体现了经典的master-slave模式。(Standalone=spark提供资源+spark提供计算)

1638174301463

集群规划:

Linux1Linux2Linux3
SparkWorker MasterWorkerWorker

3.2.1 解压缩文件

将spark-3.0.0-bin-hadoop3.2.tgz文件上传到Linux并解压缩在指定位置

tar -zxvf spark-3.0.0-bin-hadoop3.2.tgz -C /opt/module
cd /opt/module 
mv spark-3.0.0-bin-hadoop3.2 spark-standalone

3.2.2 修改配置文件

  1. 进入解压缩后路径的conf目录,修改slaves.template文件名为slaves
mv slaves.template slaves 修改slaves文件,添加worker节点
linux1
linux2
linux3
  1. 修改spark-env.sh.template文件名为spark-env.sh
mv spark-env.sh.template spark-env.sh

修改spark-env.sh文件,添加JAVA_HOME环境变量和集群对应的master节点。指定master机器,和集群间spark通信的端口。

export JAVA_HOME=/opt/module/jdk1.8.0_144
SPARK_MASTER_HOST=linux1
SPARK_MASTER_PORT=7077

注意:7077端口,相当于hadoop3内部通信的8020端口,此处的端口需要确认自己的Hadoop配置

  1. 分发spark-standalone目录
xsync spark-standalone

3.2.3 启动集群

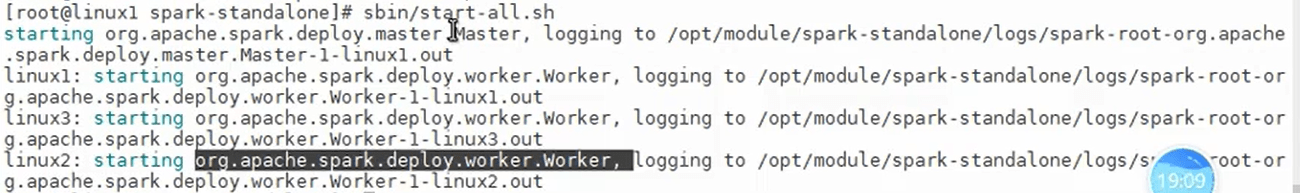
  1. 执行脚本命令:
sbin/start-all.sh

1638174700872

  1. 查看三台服务器运行进程
xcall jps
================linux1================
3330 Jps
3238 Worker
3163 Master
================linux2================
2966 Jps
2908 Worker
================linux3================
2978 Worker
3036 Jps
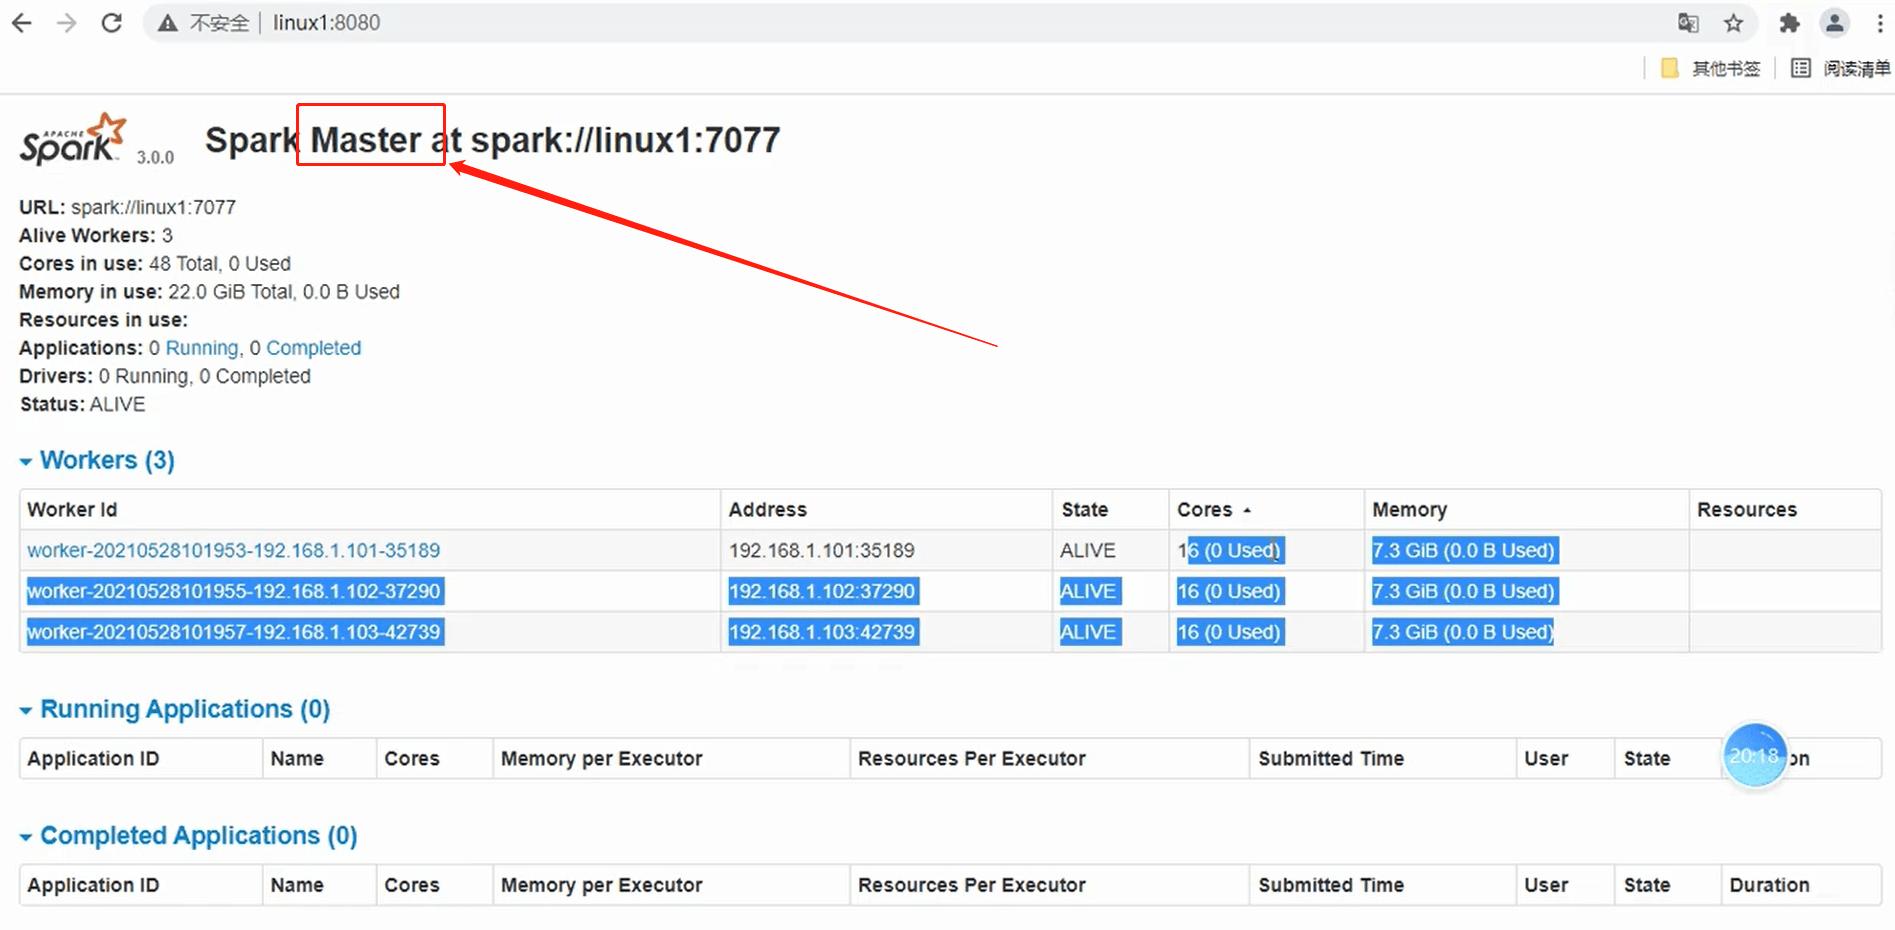
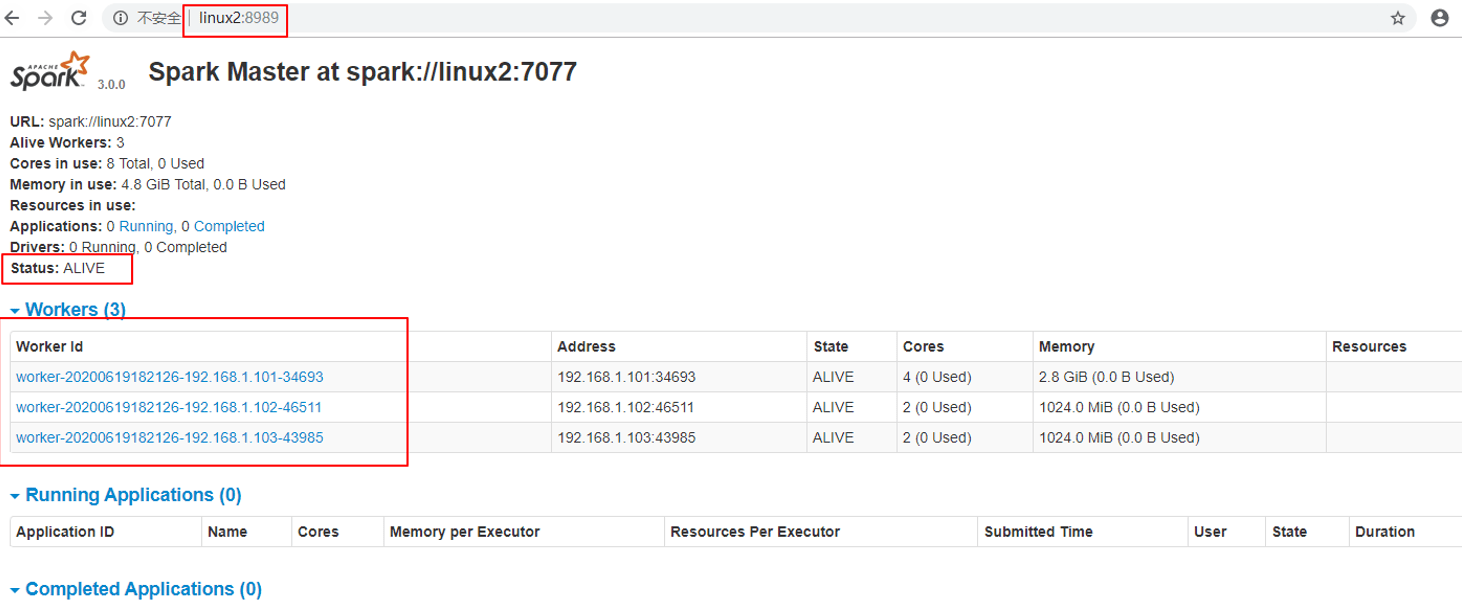
  1. 查看Master资源监控Web UI界面: http://linux1:8080

1638174744996

3.2.4 提交应用

bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master spark://linux1:7077 \
./examples/jars/spark-examples_2.12-3.0.0.jar \
10
  1. –class表示要执行程序的主
  2. –master spark://linux1:7077 独立部署模式,连接到Spark集群
  3. spark-examples_2.12-3.0.0.jar 运行类所在的jar包
  4. 数字10表示程序的入口参数,用于设定当前应用的任务数量

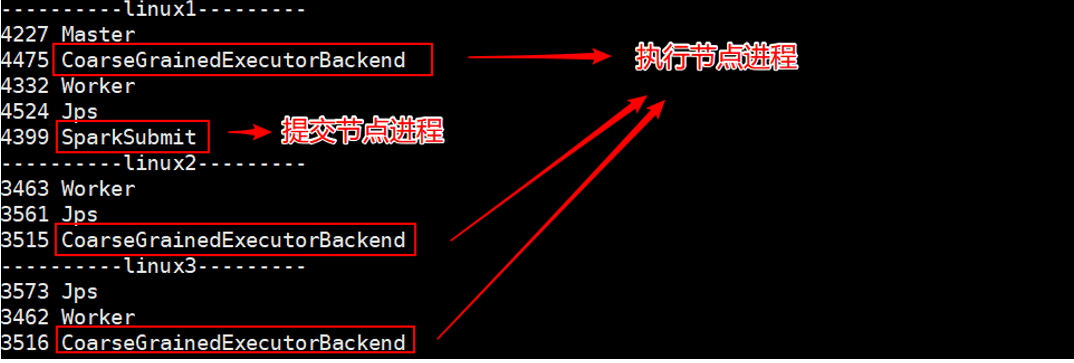
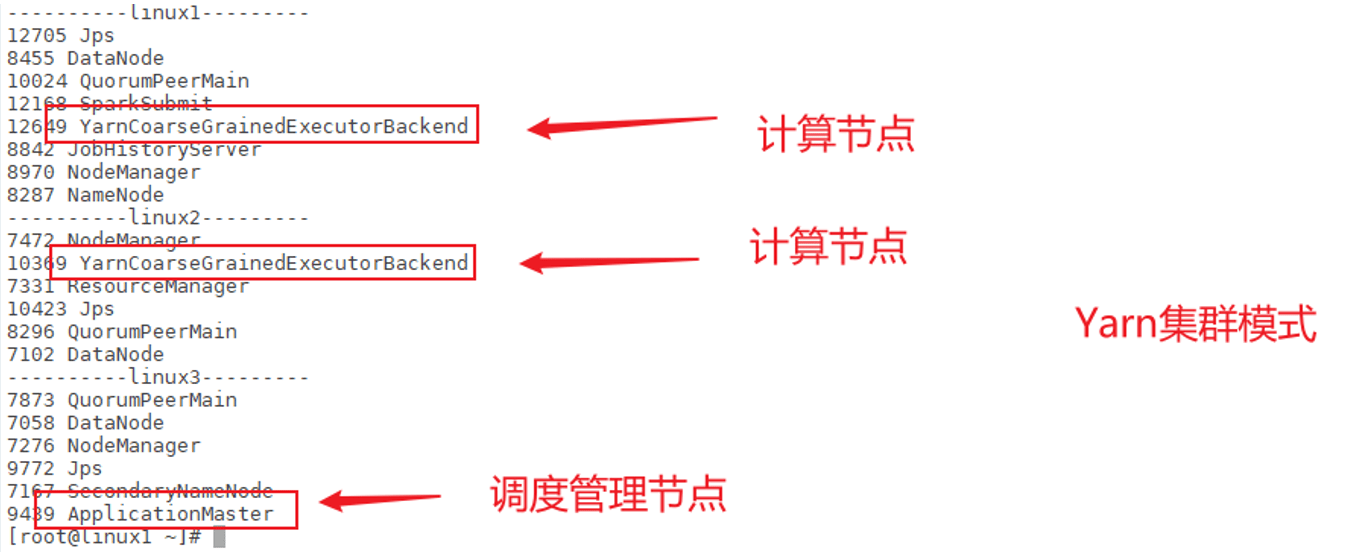
执行任务时,会产生多个Java进程

1638175491608

执行任务时,默认采用服务器集群节点的总核数,每个节点内存1024M。

1638175504305

3.2.5 提交参数说明

在提交应用中,一般会同时一些提交参数

bin/spark-submit \
--class <main-class>
--master <master-url> \
... # other options
<application-jar> \
[application-arguments]
参数解释可选值举例
–classSpark程序中包含主函数的类
–masterSpark程序运行的模式(环境)*模式:local[]、spark://linux1:7077、 Yarn**
–executor-memory 1G指定每个executor可用内存为1G符合集群内存配置即可,具体情况具体分析。
–total-executor-cores 2指定所有executor使用的cpu核数为2个
–executor-cores指定每个executor使用的cpu核数
application-jar打包好的应用jar,包含依赖。这个URL在集群中全局可见。 比如hdfs:// 共享存储系统,如果是file:// path,那么所有的节点的path都包含同样的jar
application-arguments传给main()方法的参数

3.2.6 配置历史服务

由于spark-shell停止掉后,集群监控linux1:4040页面就看不到历史任务的运行情况,所以开发时都配置历史服务器记录任务运行情况。**(历史信息存到了HDFS中)**

  1. 修改spark-defaults.conf.template文件名为spark-defaults.conf
mv spark-defaults.conf.template spark-defaults.conf
  1. 修改spark-default.conf文件,配置日志存储路径
spark.eventLog.enabled     true
spark.eventLog.dir        hdfs://linux1:8020/directory

注意:需要启动hadoop集群,HDFS上的directory目录需要提前存在。

sbin/start-dfs.sh
hadoop fs -mkdir /directory
  1. 修改spark-env.sh文件, 添加日志配置
export SPARK_HISTORY_OPTS="
-Dspark.history.ui.port=18080 
-Dspark.history.fs.logDirectory=hdfs://linux1:8020/directory 
-Dspark.history.retainedApplications=30"

l 参数1含义:WEB UI访问的端口号为18080
l 参数2含义:指定历史服务器日志存储路径
l 参数3含义:指定保存Application历史记录的个数,如果超过这个值,旧的应用程序信息将被删除,这个是内存中的应用数,而不是页面上显示的应用数。

  1. 分发配置文件
xsync conf 
  1. 重新启动集群和历史服务
sbin/start-all.sh

sbin/start-history-server.sh
  1. 重新执行任务
bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master spark://linux1:7077 \
./examples/jars/spark-examples_2.12-3.0.0.jar \
10
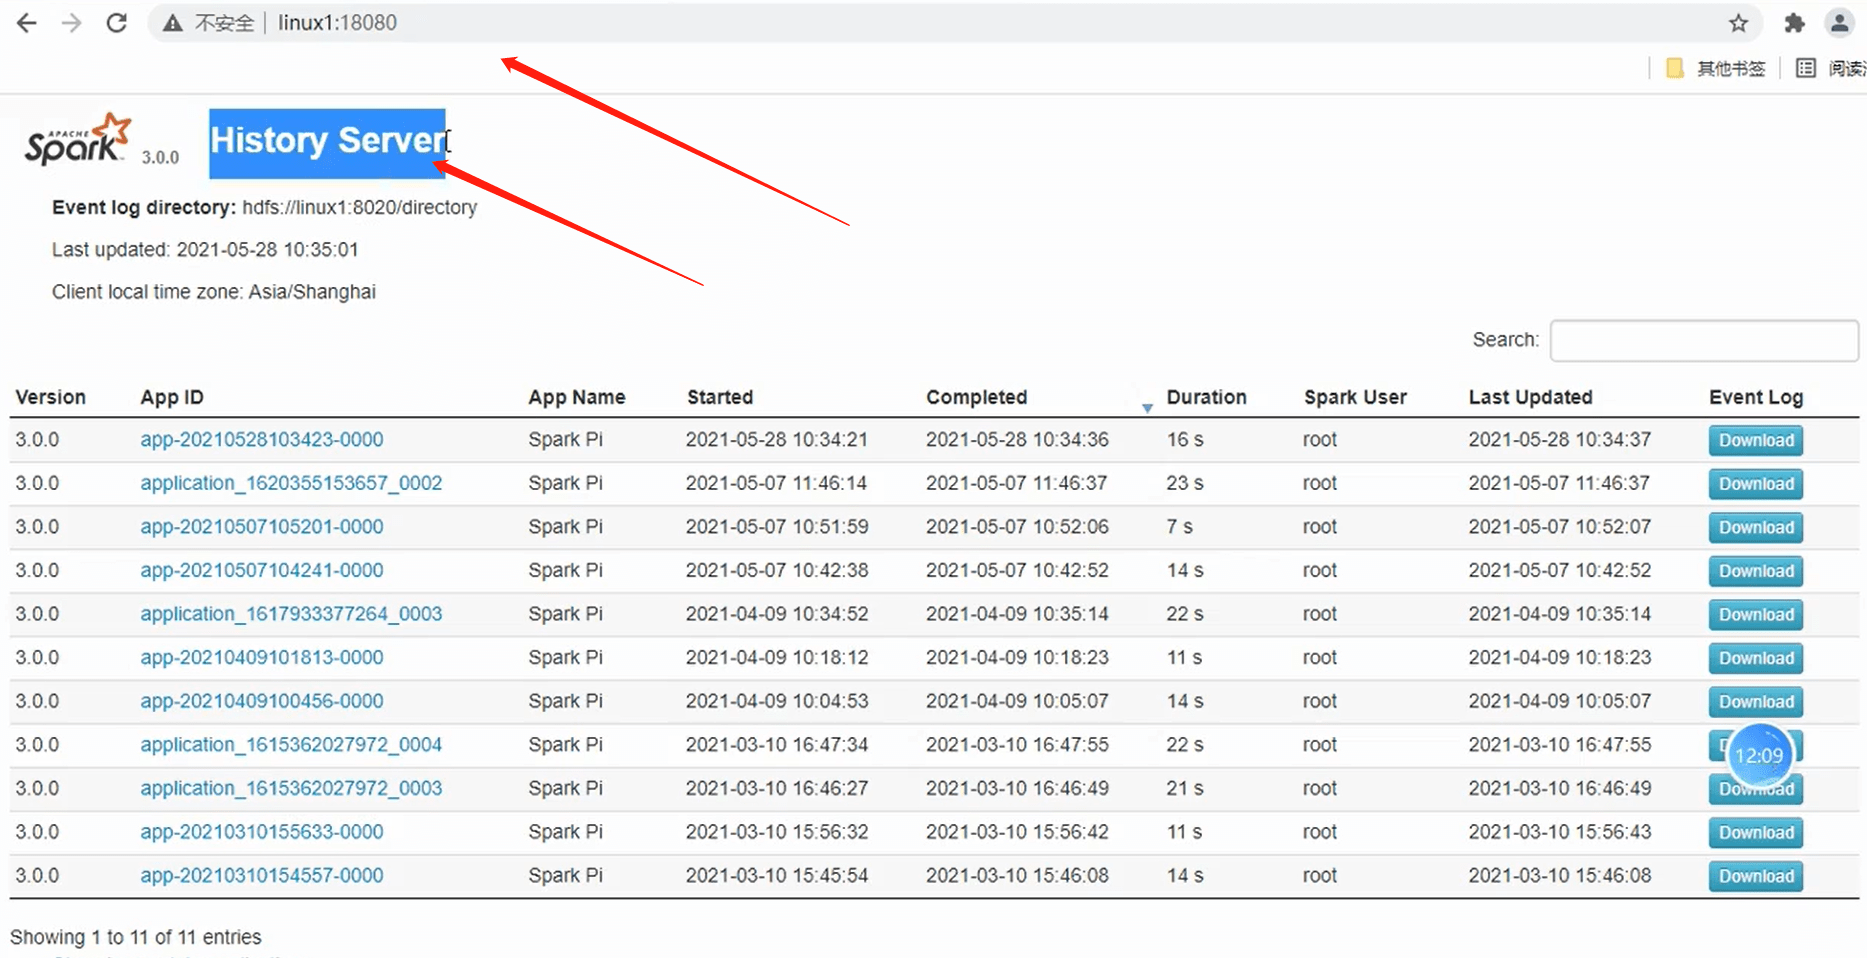
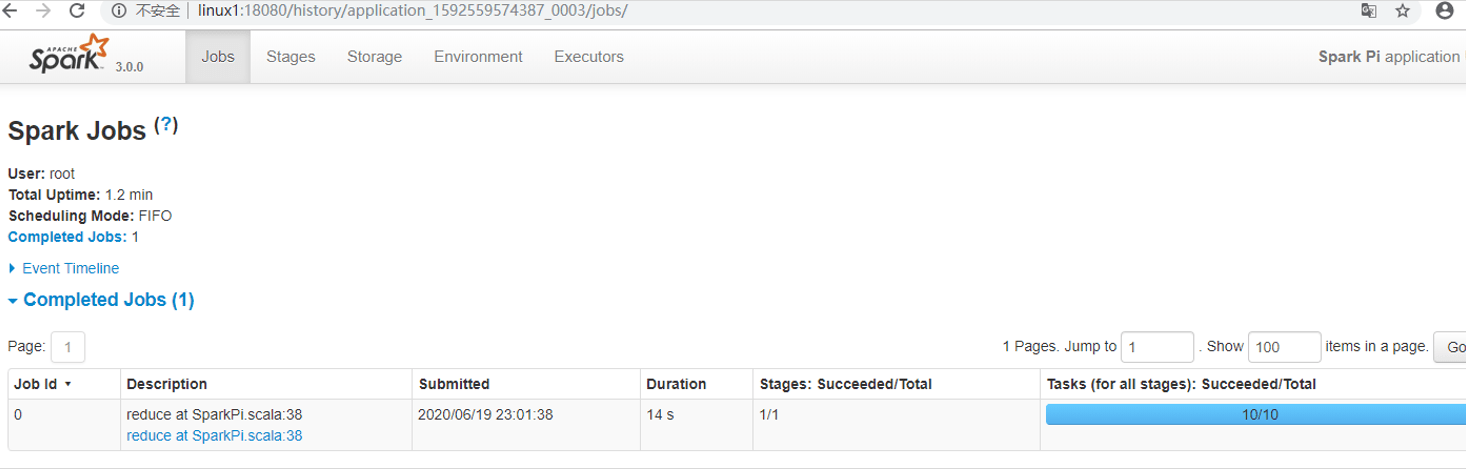
  1. 查看历史服务:http://linux1:18080

1638175185282

3.2.7 配置高可用(HA)

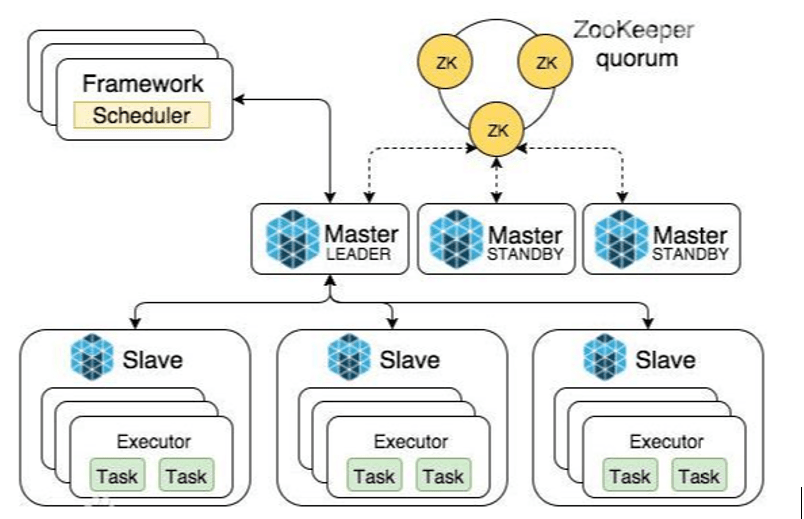
所谓的高可用是因为当前集群中的Master节点只有一个,所以会存在单点故障问题。所以为了解决单点故障问题,需要在集群中配置多个Master节点,一旦处于活动状态的Master发生故障时,由备用Master提供服务,保证作业可以继续执行。这里的高可用一般采用Zookeeper设置。

集群规划:

Linux1Linux2Linux3
SparkMaster Zookeeper WorkerMaster Zookeeper WorkerZookeeper Worker
  1. 停止集群
sbin/stop-all.sh 
  1. 启动Zookeeper
xstart zk 
  1. 修改spark-env.sh文件添加如下配置

注释如下内容:

#SPARK_MASTER_HOST=linux1

#SPARK_MASTER_PORT=7077

添加如下内容:

#Master监控页面默认访问端口为8080,但是可能会和Zookeeper冲突,所以改成8989,也可以自定义,访问UI监控页面时请注意

SPARK_MASTER_WEBUI_PORT=8989
export SPARK_DAEMON_JAVA_OPTS="
-Dspark.deploy.recoveryMode=ZOOKEEPER 
-Dspark.deploy.zookeeper.url=linux1,linux2,linux3 
-Dspark.deploy.zookeeper.dir=/spark"
  1. 分发配置文件
xsync conf/ 
  1. 启动集群
sbin/start-all.sh 

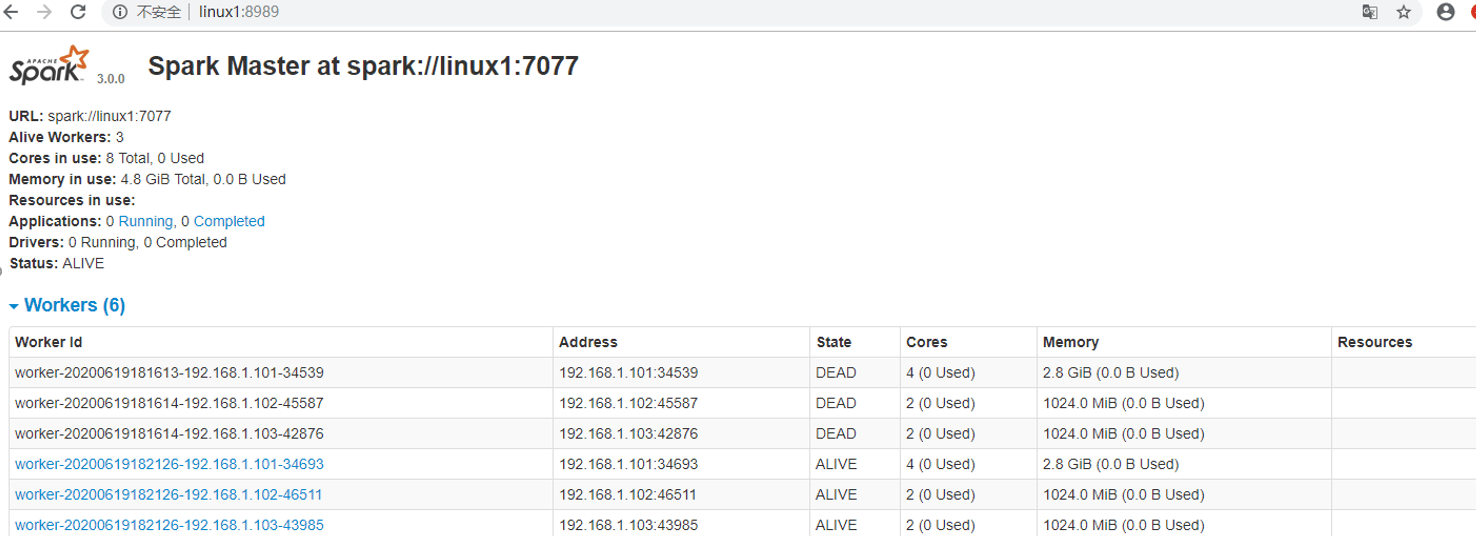
1638175383495

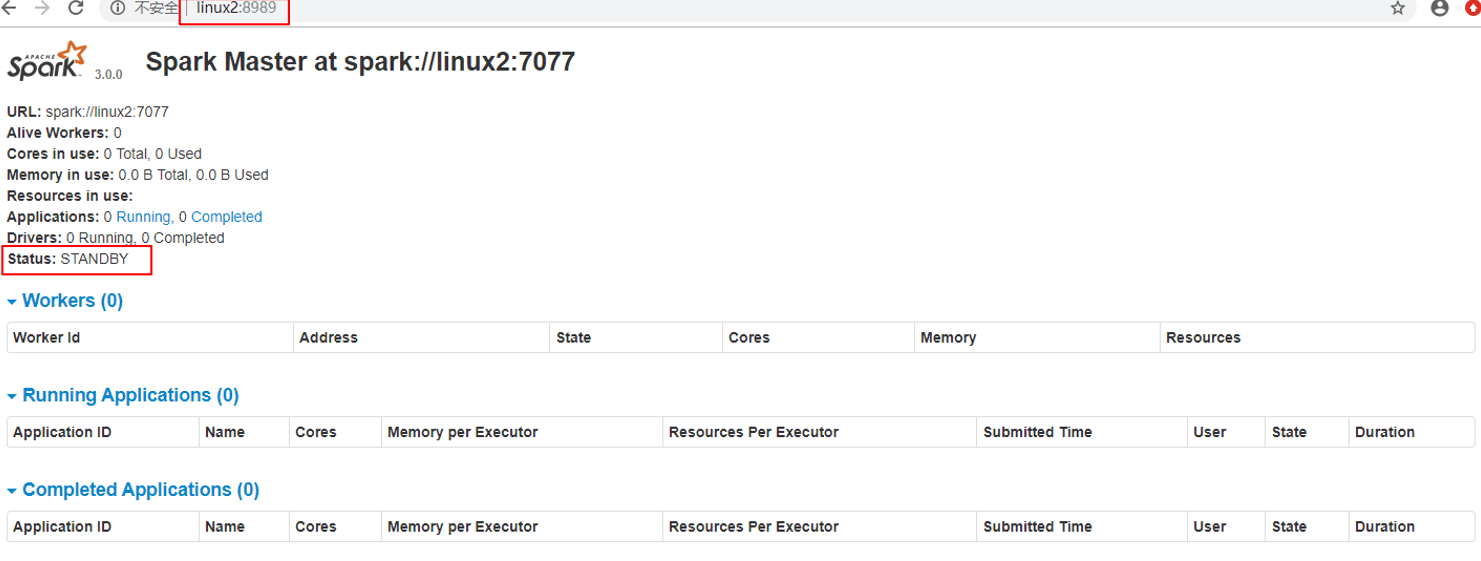
  1. 启动linux2的单独Master节点,此时linux2节点Master状态处于备用状态
[root@linux2 spark-standalone]# sbin/start-master.sh 

1638175397500

  1. 提交应用到高可用集群
bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master spark://linux1:7077,linux2:7077 \
./examples/jars/spark-examples_2.12-3.0.0.jar \
10
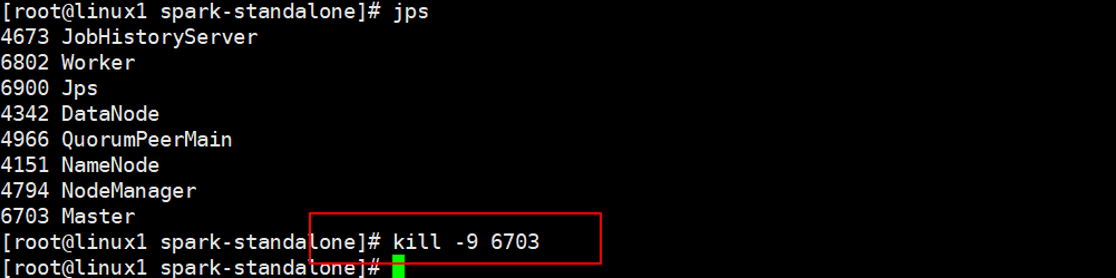
  1. 停止linux1的Master资源监控进程

1638175436542

  1. 查看linux2的Master 资源监控Web UI,稍等一段时间后,linux2节点的Master状态提升为活动状态

1638175451854

3.3 Yarn模式

独立部署(Standalone)模式由Spark自身提供计算资源,无需其他框架提供资源。这种方式降低了和其他第三方资源框架的耦合性,独立性非常强。但是你也要记住,Spark主要是计算框架,而不是资源调度框架,所以本身提供的资源调度并不是它的强项,所以还是和其他专业的资源调度框架集成会更靠谱一些。所以接下来我们来学习在强大的Yarn环境下Spark是如何工作的(其实是因为在国内工作中,Yarn使用的非常多)。

1638175863107

3.3.1 解压缩文件

将spark-3.0.0-bin-hadoop3.2.tgz文件上传到linux并解压缩,放置在指定位置。

tar -zxvf spark-3.0.0-bin-hadoop3.2.tgz -C /opt/module
cd /opt/module 
mv spark-3.0.0-bin-hadoop3.2 spark-yarn

3.3.2 修改配置文件

  1. 修改hadoop配置文件/opt/module/hadoop/etc/hadoop/yarn-site.xml, 并分发
<!--是否启动一个线程检查每个任务正使用的物理内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->
<property>
     <name>yarn.nodemanager.pmem-check-enabled</name>
     <value>false</value>
</property>

<!--是否启动一个线程检查每个任务正使用的虚拟内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->
<property>
     <name>yarn.nodemanager.vmem-check-enabled</name>
     <value>false</value>
</property>
  1. 修改conf/spark-env.sh,添加JAVA_HOME和YARN_CONF_DIR配置
mv spark-env.sh.template spark-env.sh

查找yarn的位置

export JAVA_HOME=/opt/module/jdk1.8.0_144
YARN_CONF_DIR=/opt/module/hadoop/etc/hadoop

3.3.3 启动HDFS以及YARN集群

瞅啥呢,自己启动去!

3.3.4 提交应用

master指定为yarn,部署模式为集群模式。

bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master yarn \
--deploy-mode cluster \
./examples/jars/spark-examples_2.12-3.0.0.jar \
10

1638175901609

1638175915913

查看 http://linux2:8088 页面,点击History,查看历史页面

1638175935231

3.3.5 配置历史服务器

  1. 修改spark-defaults.conf.template文件名为spark-defaults.conf
mv spark-defaults.conf.template spark-defaults.conf
  1. 修改spark-default.conf文件,配置日志存储路径
spark.eventLog.enabled     true
spark.eventLog.dir        hdfs://linux1:8020/directory

注意:需要启动hadoop集群,HDFS上的目录需要提前存在。

[root@linux1 hadoop]# sbin/start-dfs.sh
[root@linux1 hadoop]# hadoop fs -mkdir /directory
  1. 修改spark-env.sh文件, 添加日志配置
export SPARK_HISTORY_OPTS="
-Dspark.history.ui.port=18080 
-Dspark.history.fs.logDirectory=hdfs://linux1:8020/directory 
-Dspark.history.retainedApplications=30"

l 参数1含义:WEB UI访问的端口号为18080

l 参数2含义:指定历史服务器日志存储路径

l 参数3含义:指定保存Application历史记录的个数,如果超过这个值,旧的应用程序信息将被删除,这个是内存中的应用数,而不是页面上显示的应用数。

  1. 修改spark-defaults.conf
spark.yarn.historyServer.address=linux1:18080
spark.history.ui.port=18080
  1. 启动历史服务
sbin/start-history-server.sh 
  1. 重新提交应用
bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master yarn \
--deploy-mode client \
./examples/jars/spark-examples_2.12-3.0.0.jar \
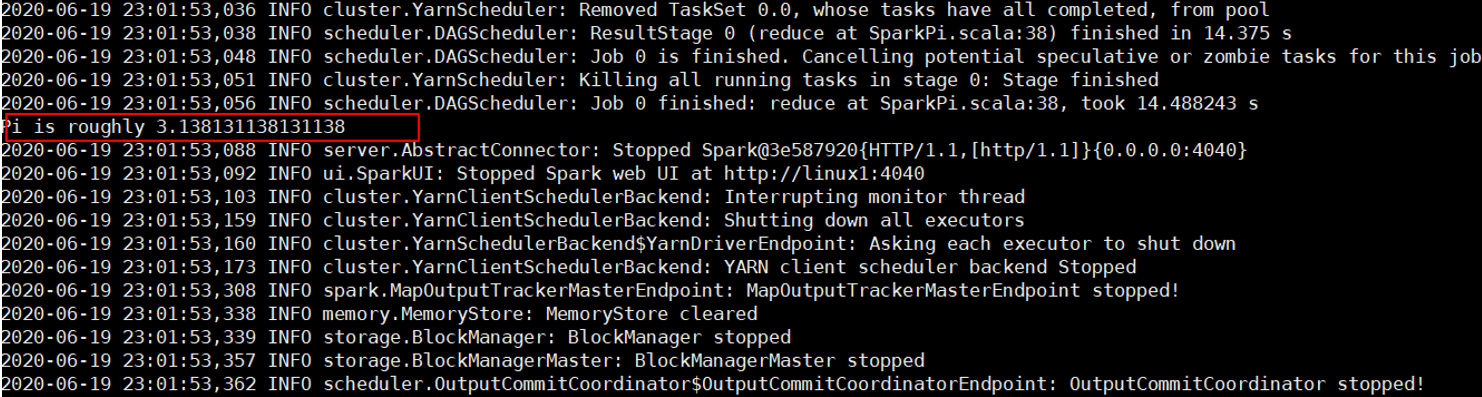
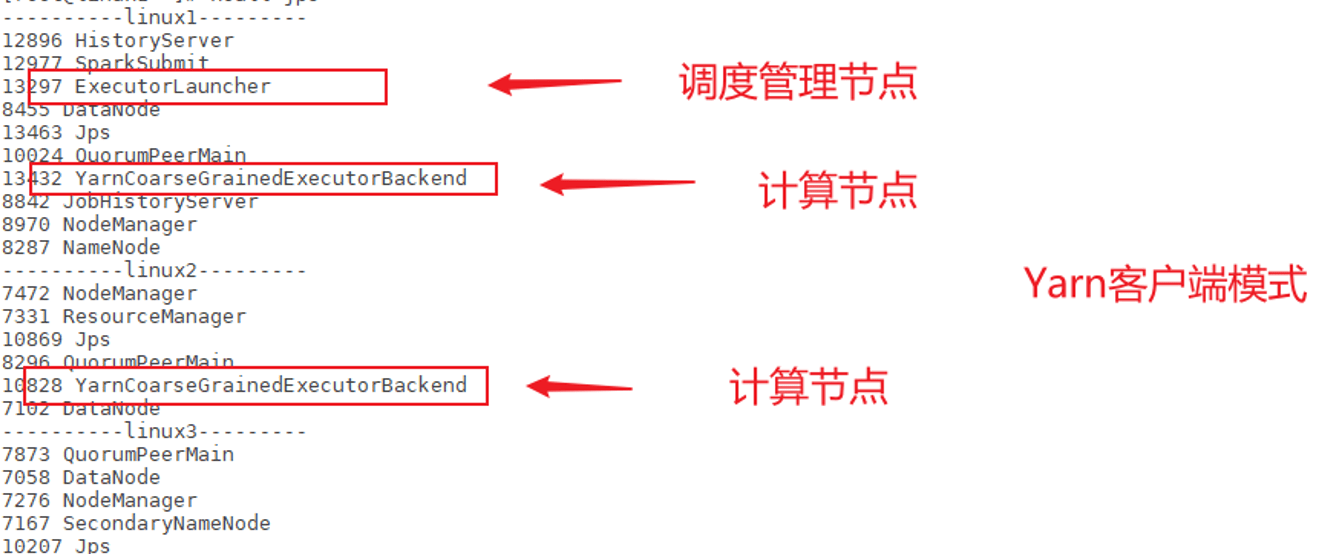
10

1638176022879

1638176037995

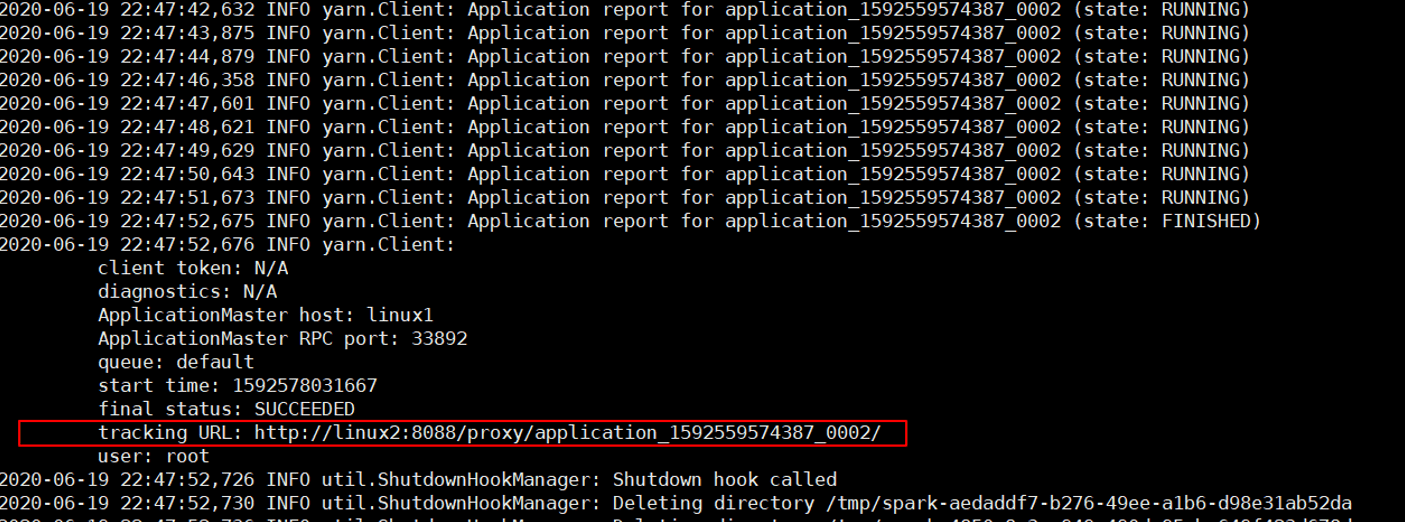
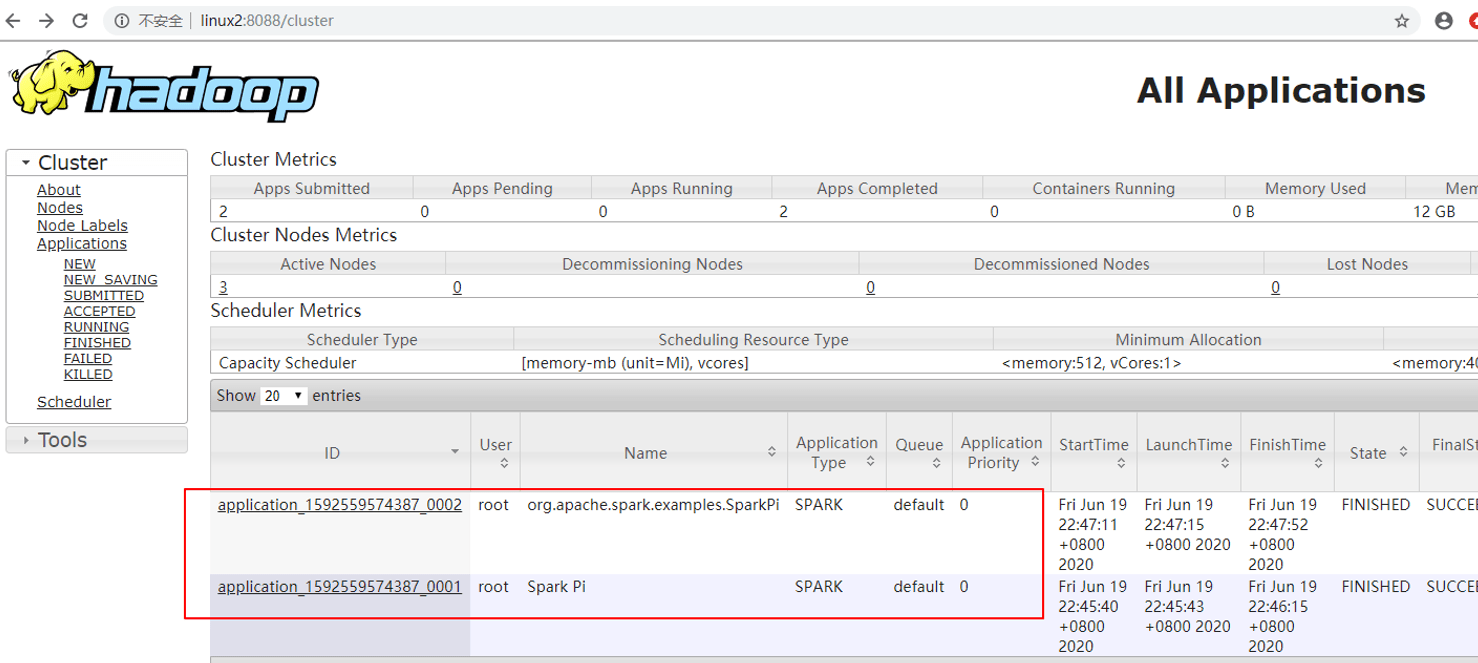
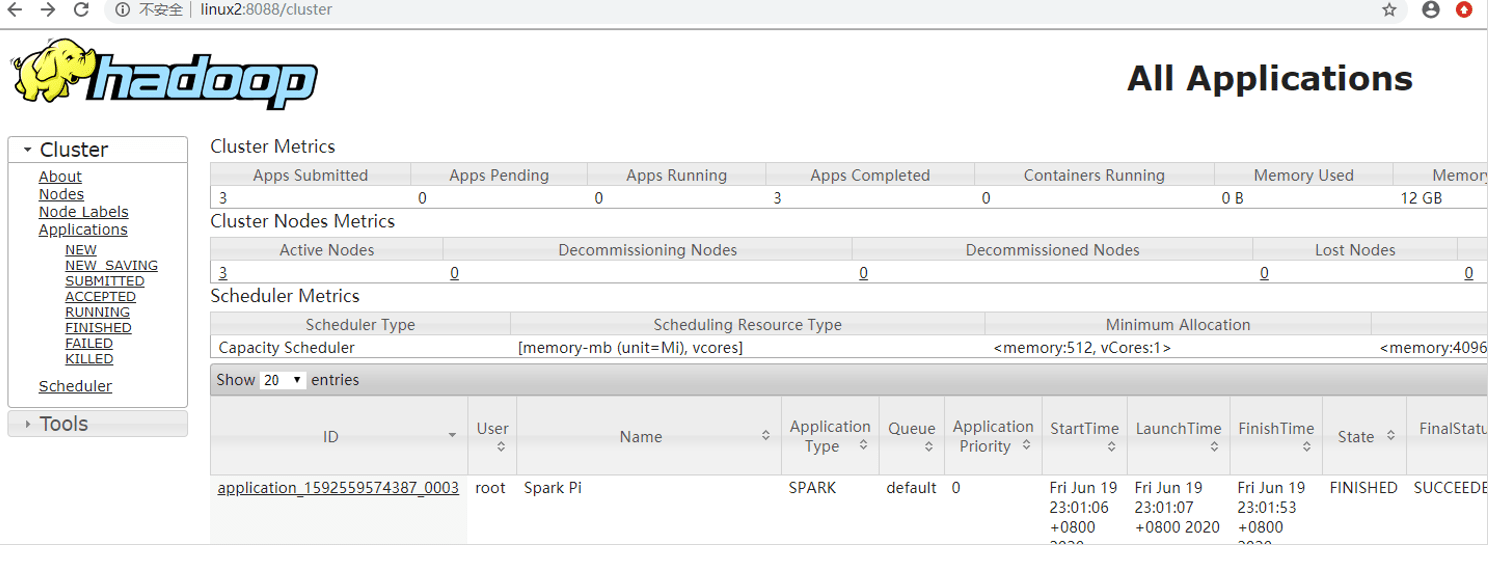
  1. Web页面查看日志:http://linux2:8088

1638176059473

1638176071216

3.4 K8S & Mesos模式

Mesos是Apache下的开源分布式资源管理框架,它被称为是分布式系统的内核,在Twitter得到广泛使用,管理着Twitter超过30,0000台服务器上的应用部署,但是在国内,依然使用着传统的Hadoop大数据框架,所以国内使用Mesos框架的并不多,但是原理其实都差不多,这里我们就不做过多讲解了。

1638176091921

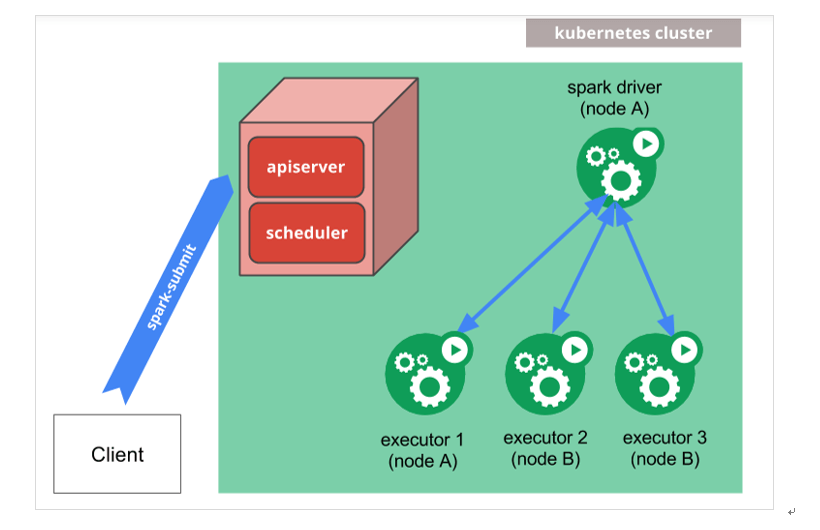
容器化部署是目前业界很流行的一项技术,基于Docker镜像运行能够让用户更加方便地对应用进行管理和运维。容器管理工具中最为流行的就是Kubernetes(k8s),而Spark也在最近的版本中支持了k8s部署模式。这里我们也不做过多的讲解。给个链接大家自己感受一下:https://spark.apache.org/docs/latest/running-on-kubernetes.html

1638176106974

3.5 Windows模式

在同学们自己学习时,每次都需要启动虚拟机,启动集群,这是一个比较繁琐的过程,并且会占大量的系统资源,导致系统执行变慢,不仅仅影响学习效果,也影响学习进度,Spark非常暖心地提供了可以在windows系统下启动本地集群的方式,这样,在不使用虚拟机的情况下,也能学习Spark的基本使用!

在后续的教学中,为了能够给同学们更加流畅的教学效果和教学体验,我们一般情况下都会采用windows系统的集群来学习Spark。

3.5.1 解压缩文件

将文件spark-3.0.0-bin-hadoop3.2.tgz解压缩到无中文无空格的路径中

3.5.2 启动本地环境

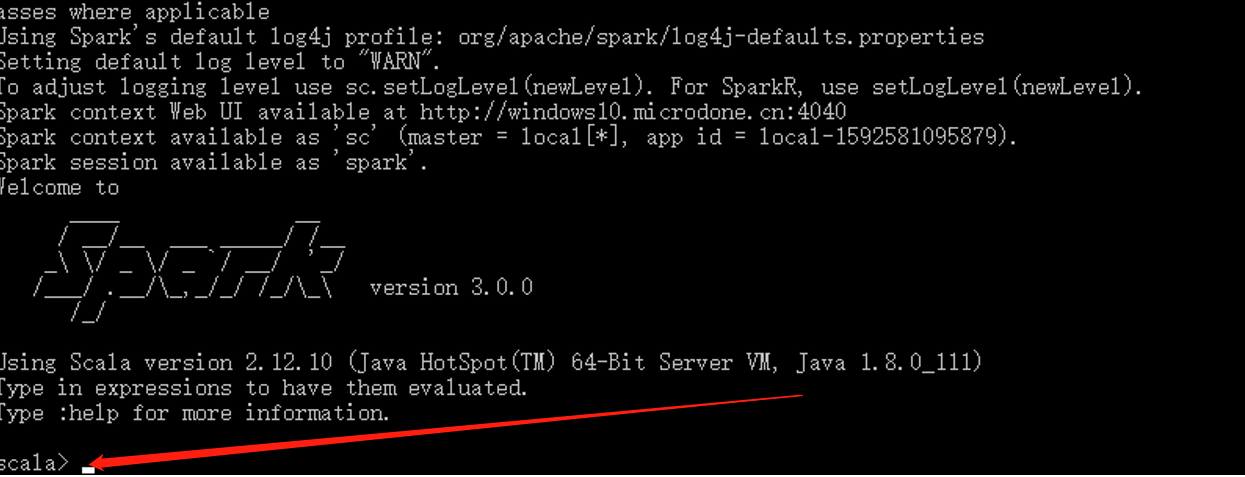
  1. 执行解压缩文件路径下bin目录中的spark-shell.cmd文件,启动Spark本地环境

1638176202265

  1. 在bin目录中创建input目录,并添加word.txt文件, 在命令行中输入脚本代码

1638176219502

3.5.3 命令行提交应用

在DOS命令行窗口中执行提交指令

spark-submit --class org.apache.spark.examples.SparkPi --master local[2] ../examples/jars/spark-examples_2.12-3.0.0.jar 10

3.6 部署模式对比

模式Spark安装机器数需启动的进程所属者应用场景
Local1无Spark测试
Standalone3Master及WorkerSpark单独部署
Yarn1Yarn及HDFSHadoop混合部署

3.7 端口号

  • Spark查看当前Spark-shell运行任务情况端口号:4040(计算)

  • Spark Master内部通信服务端口号:7077

  • Standalone模式下,Spark Master Web端口号:8080(资源)

  • Spark历史服务器端口号:18080

  • Hadoop YARN任务运行情况查看端口号:8088

HBase学习笔记(二) HBase架构解析

1 HBase架构解析

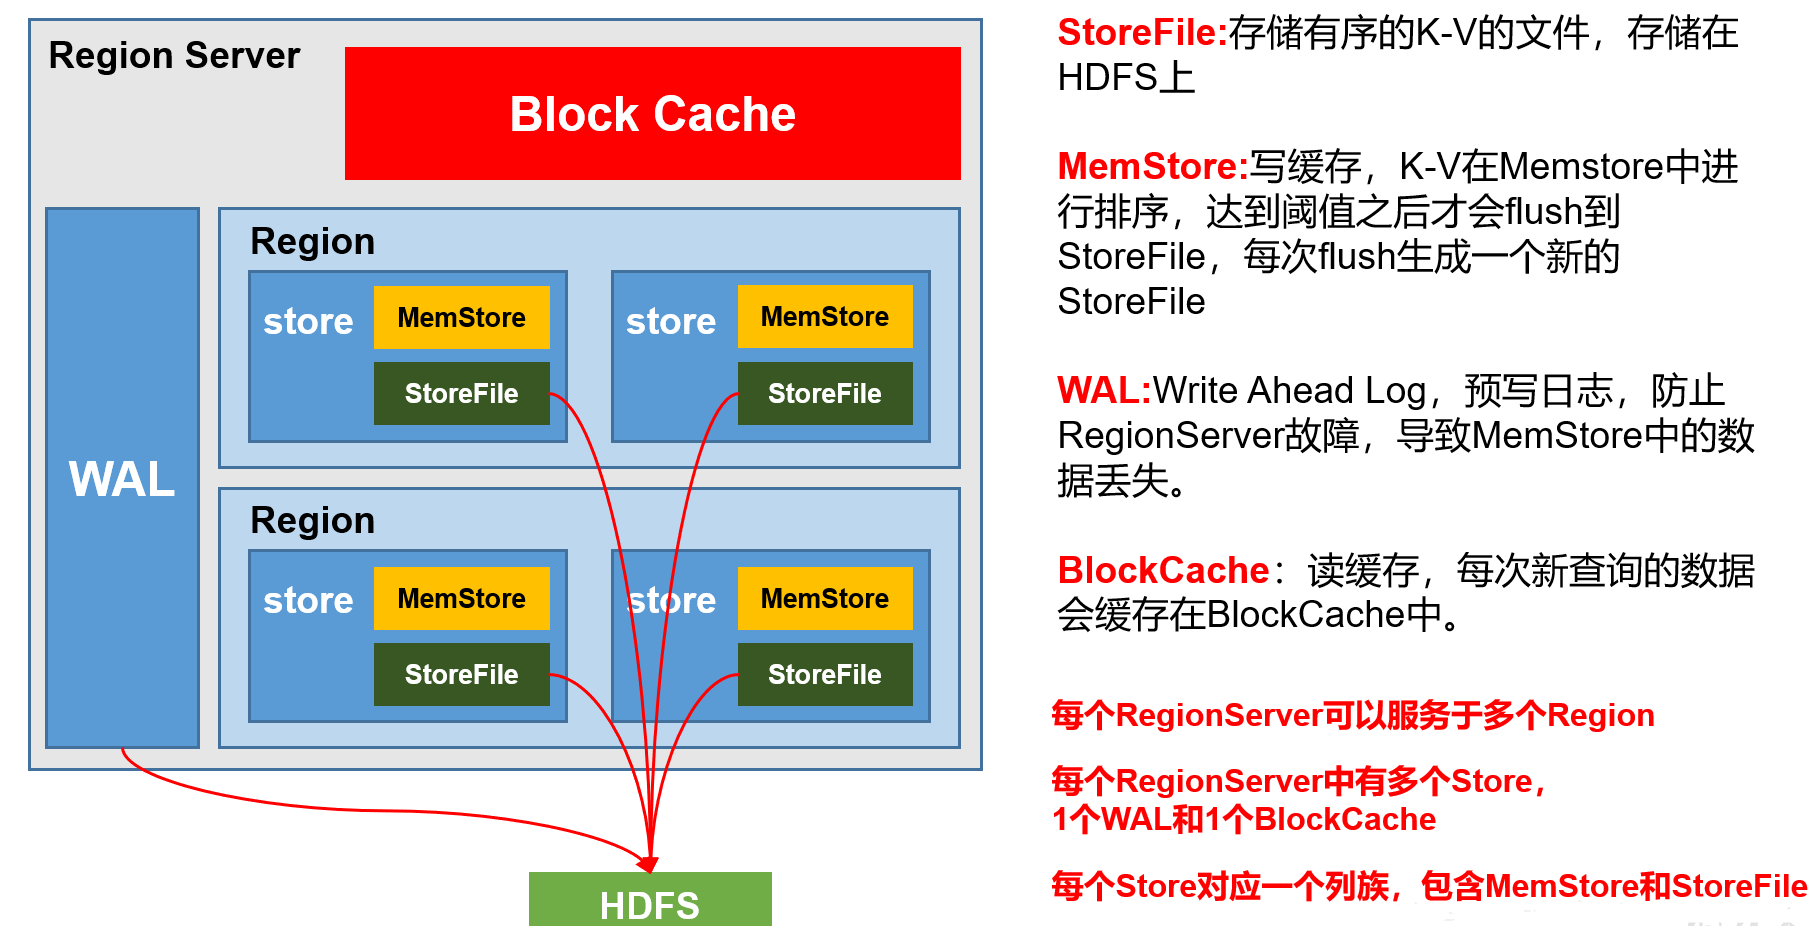
1.1 RegionServer 架构

1637810890299

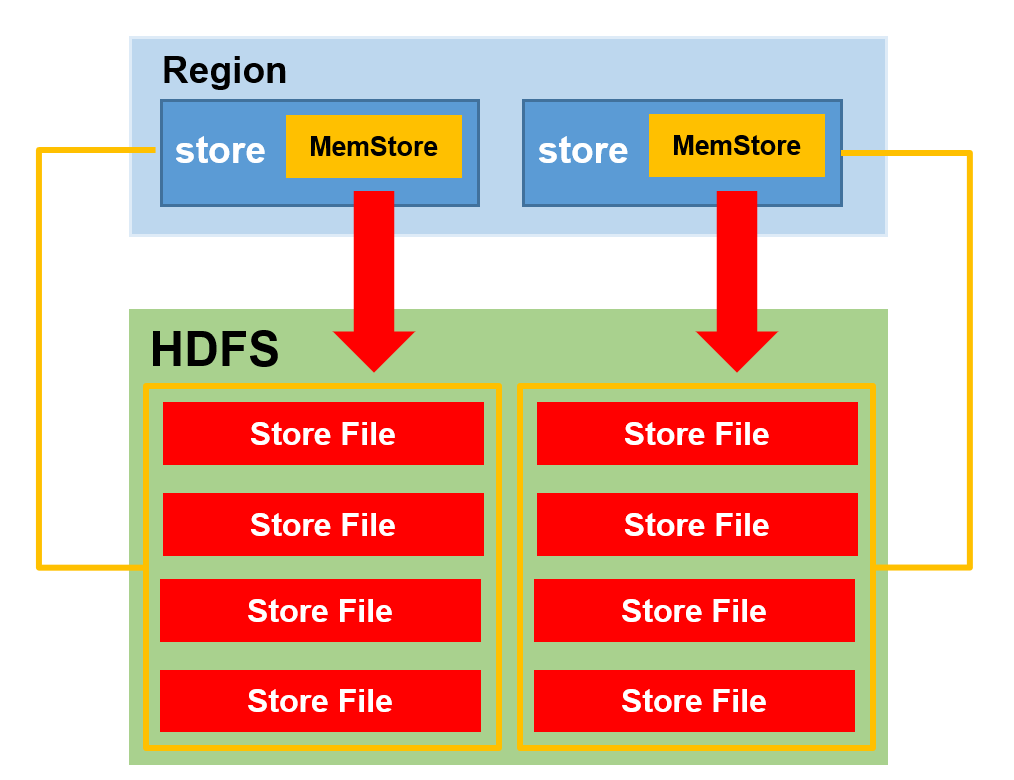
1)StoreFile

保存实际数据的物理文件,StoreFile以Hfile的形式存储在HDFS上。每个Store会有一个或多个StoreFile(HFile),数据在每个StoreFile中都是有序的。

2)MemStore

写缓存,由于HFile中的数据要求是有序的,所以数据是先存储在MemStore中,排好序后,等到达刷写时机才会刷写到HFile,每次刷写都会形成一个新的HFile。

3)WAL

由于数据要经MemStore排序后才能刷写到HFile,但把数据保存在内存中会有很高的概率导致数据丢失,为了解决这个问题,数据会先写在一个叫做Write-Ahead logfile的文件中,然后再写入MemStore中。所以在系统出现故障的时候,数据可以通过这个日志文件重建。

4)BlockCache

读缓存,每次查询出的数据会缓存在BlockCache中,方便下次查询(LRU机制清理)。

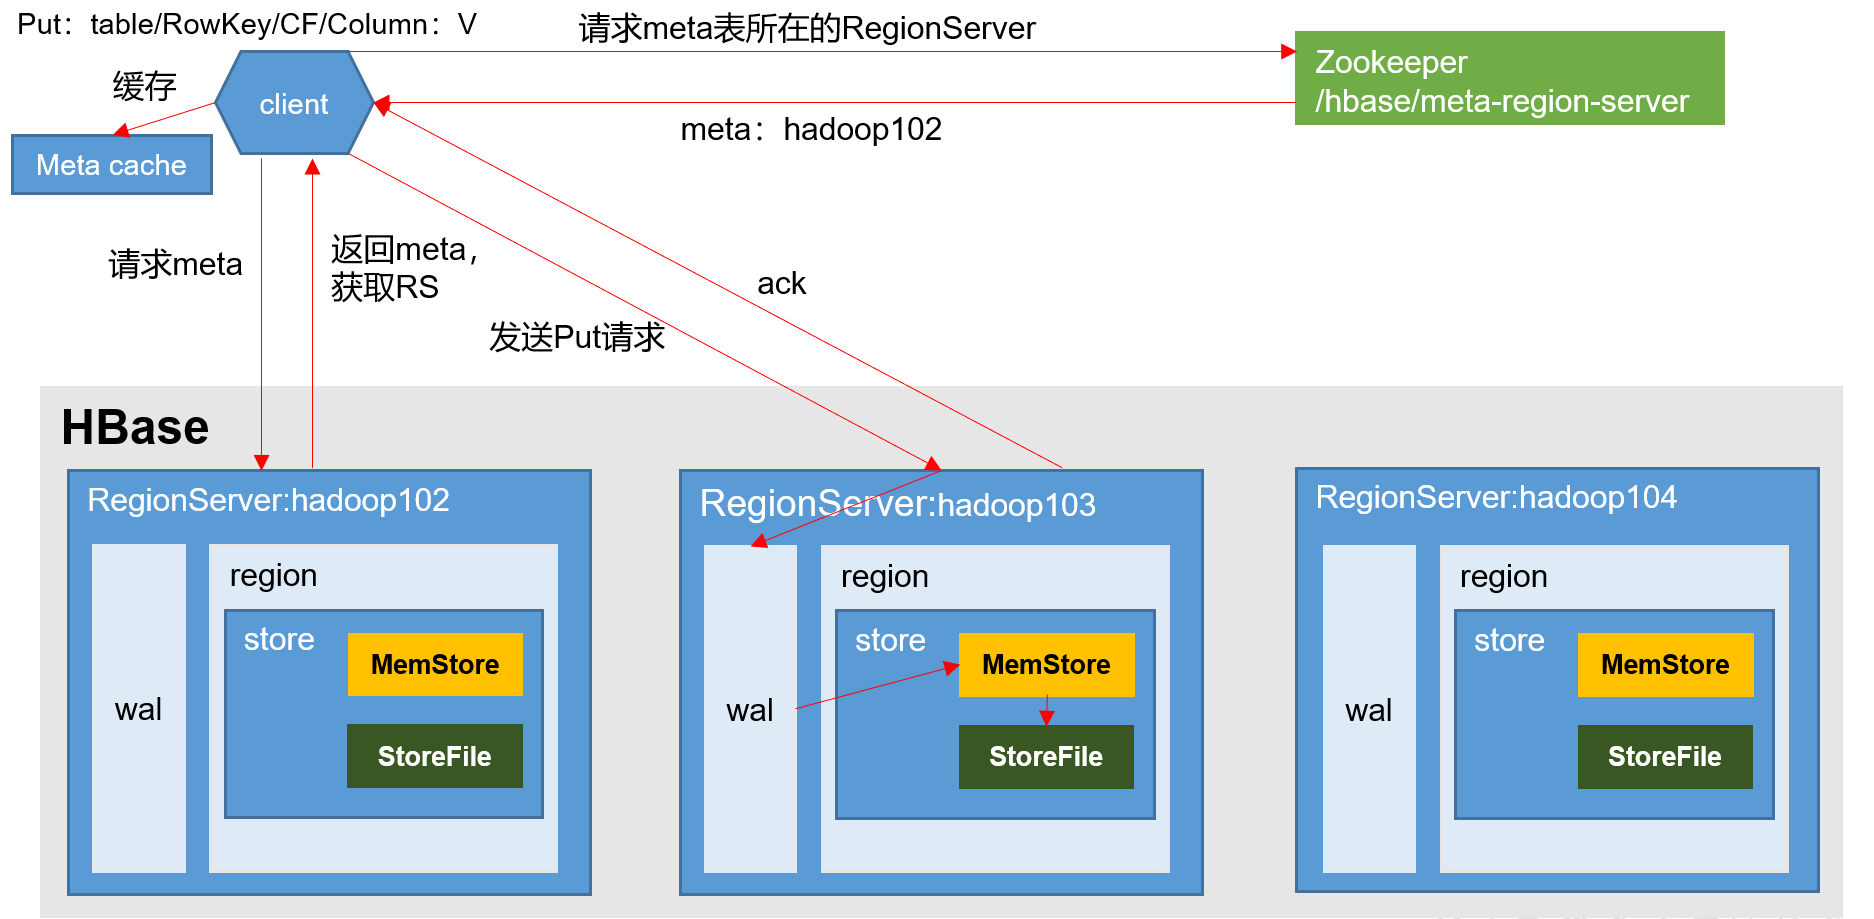
1.2 写流程

1637810932896

写流程:

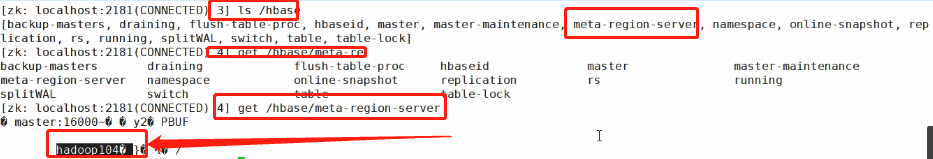
1)Client先访问zookeeper,获取hbase:meta(存储业务表的元数据)表位于哪个Region Server。可以看到hbase:meta表存在hadoop104中。

1637825177104

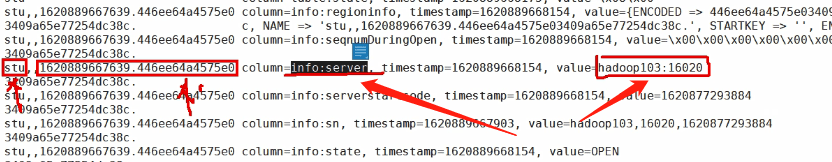
2)访问对应的Region Server,获取hbase:meta表,根据读请求的namespace:table/rowkey,查询出目标数据位于哪个Region Server中的哪个Region中。并将该table的region信息以及meta表的位置信息缓存在客户端的meta cache,方便下次访问。途中发现:该表是存储在hadoop103的(scan ‘student’)。

1637825241657

3)与目标Region Server进行通讯;

4)将数据顺序写入(追加)到WAL;

5)将数据写入对应的MemStore,数据会在MemStore进行排序;

6)向客户端发送ack;

7)等达到MemStore的刷写时机后,将数据刷写到HFile。

1.3 MemStore Flush

1637810958068

MemStore刷写时机:

0)手动刷写 :刷写’stu’表

flush 'stu'

1)当某个memstore的大小达到了hbase.hregion.memstore.flush.size(默认值128M),其所在region的所有memstore都会刷写。

当memstore的大小达到了

hbase.hregion.memstore.flush.size(默认值128M)* hbase.hregion.memstore.block.multiplier(默认值4)

时,会阻止继续往该memstore写数据。

2)当region server中memstore的总大小达到

java_heapsize*hbase.regionserver.global.memstore.size(默认值0.4)*hbase.regionserver.global.memstore.size.lower.limit(默认值0.95)

region会按照其所有memstore的大小顺序(由大到小)依次进行刷写。直到region server中所有memstore的总大小减小到上述值以下。

当region server中memstore的总大小达到

java_heapsize*hbase.regionserver.global.memstore.size(默认值0.4)

时,会阻止继续往所有的memstore写数据。

  1. 到达自动刷写的时间,也会触发memstore flush。自动刷新的时间间隔由该属性进行配置hbase.regionserver.optionalcacheflushinterval(默认1小时)。

4)当WAL文件的数量超过hbase.regionserver.max.logs,region会按照时间顺序依次进行刷写,直到WAL文件数量减小到hbase.regionserver.max.logs以下(该属性名已经废弃,现无需手动设置,最大值为32)。

1.4 读流程

1.4.1 整体流程

和写的流程是一样的。

1637810986292

1.4.2 Merge细节

1637811017103

读流程

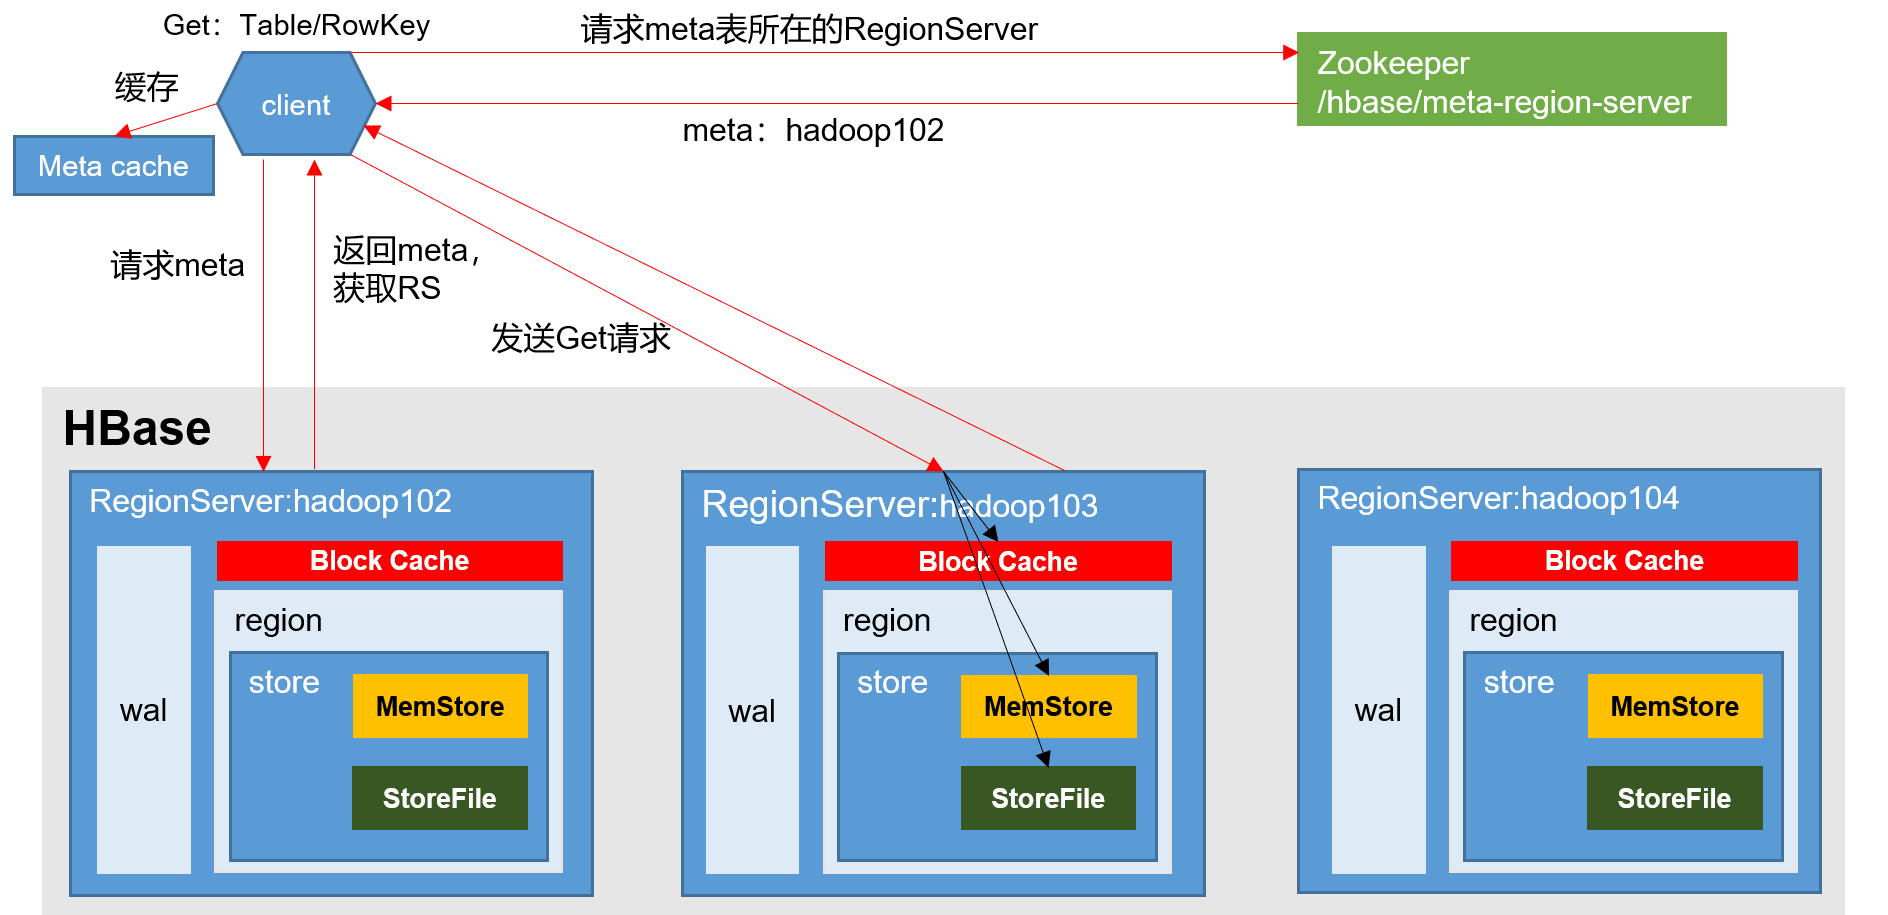
1)Client先访问zookeeper,获取hbase:meta表位于哪个Region Server。

2)访问对应的Region Server,获取hbase:meta表,根据读请求的namespace:table/rowkey,查询出目标数据位于哪个Region Server中的哪个Region中。并将该table的region信息以及meta表的位置信息缓存在客户端的meta cache,方便下次访问。

3)与目标Region Server进行通讯;

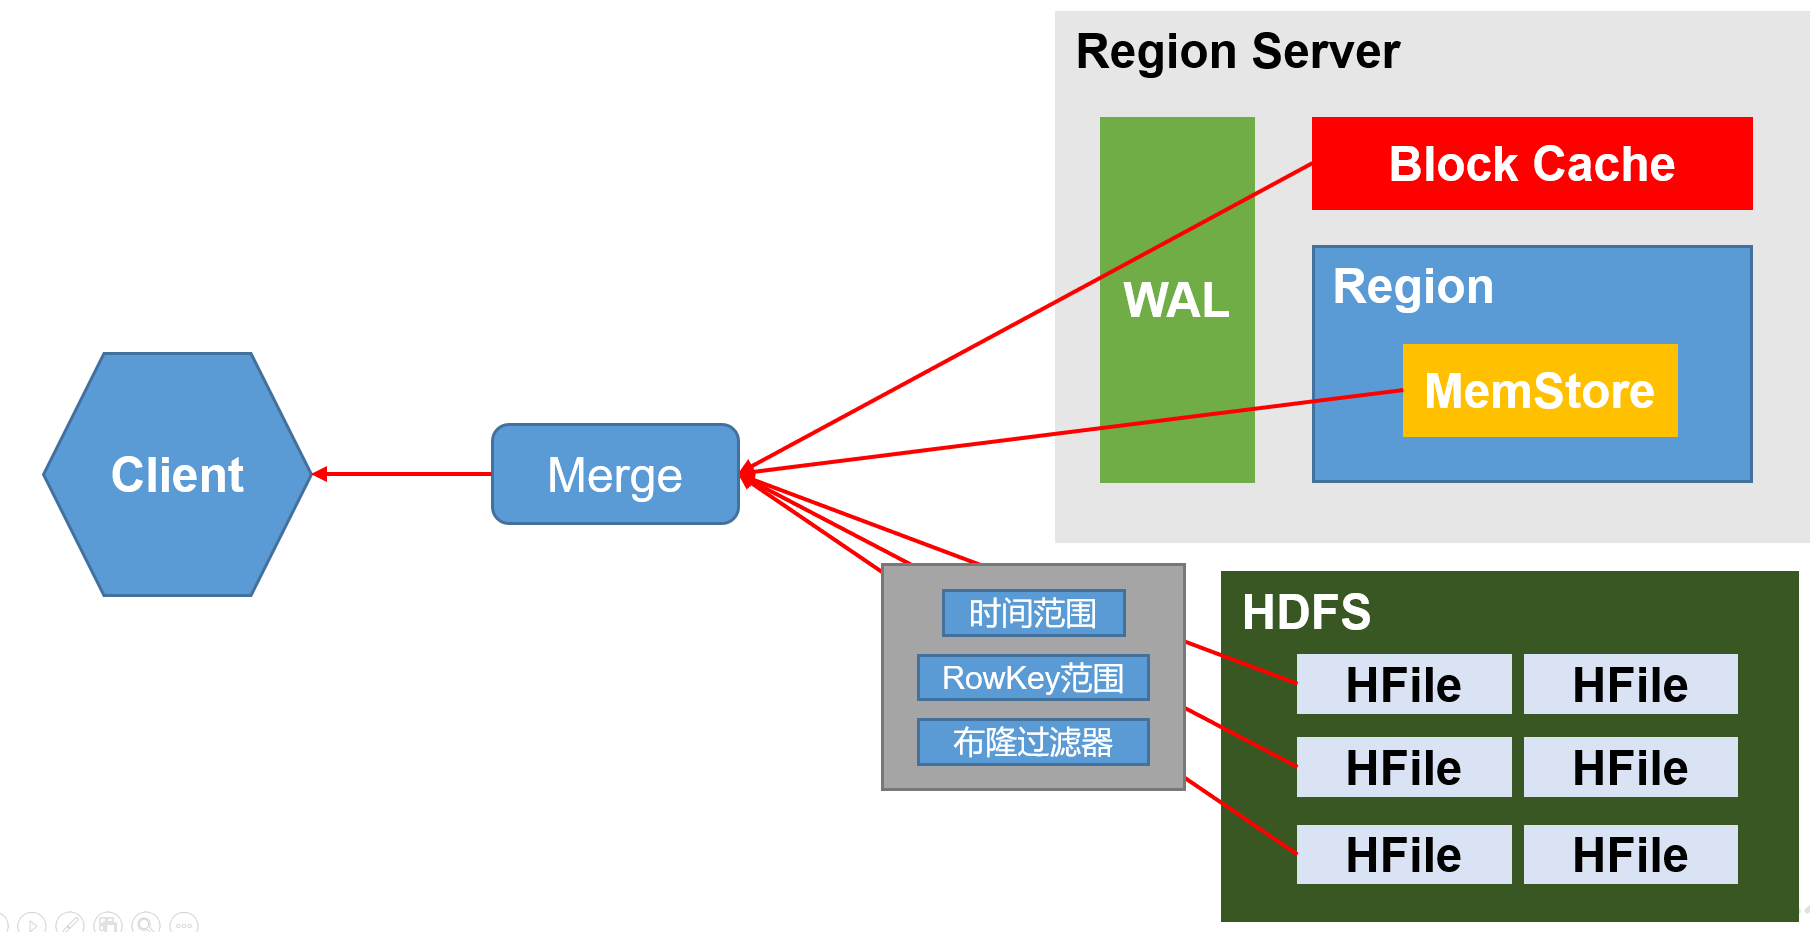
4)分别在MemStore和Store File(HFile)中查询目标数据,并将查到的所有数据进行合并。此处所有数据是指同一条数据的不同版本(time stamp)或者不同的类型(Put/Delete)。

5)将查询到的新的数据块(Block,HFile数据存储单元,默认大小为64KB)缓存到Block Cache。

6)将合并后的最终结果返回给客户端。

1.5 StoreFile Compaction

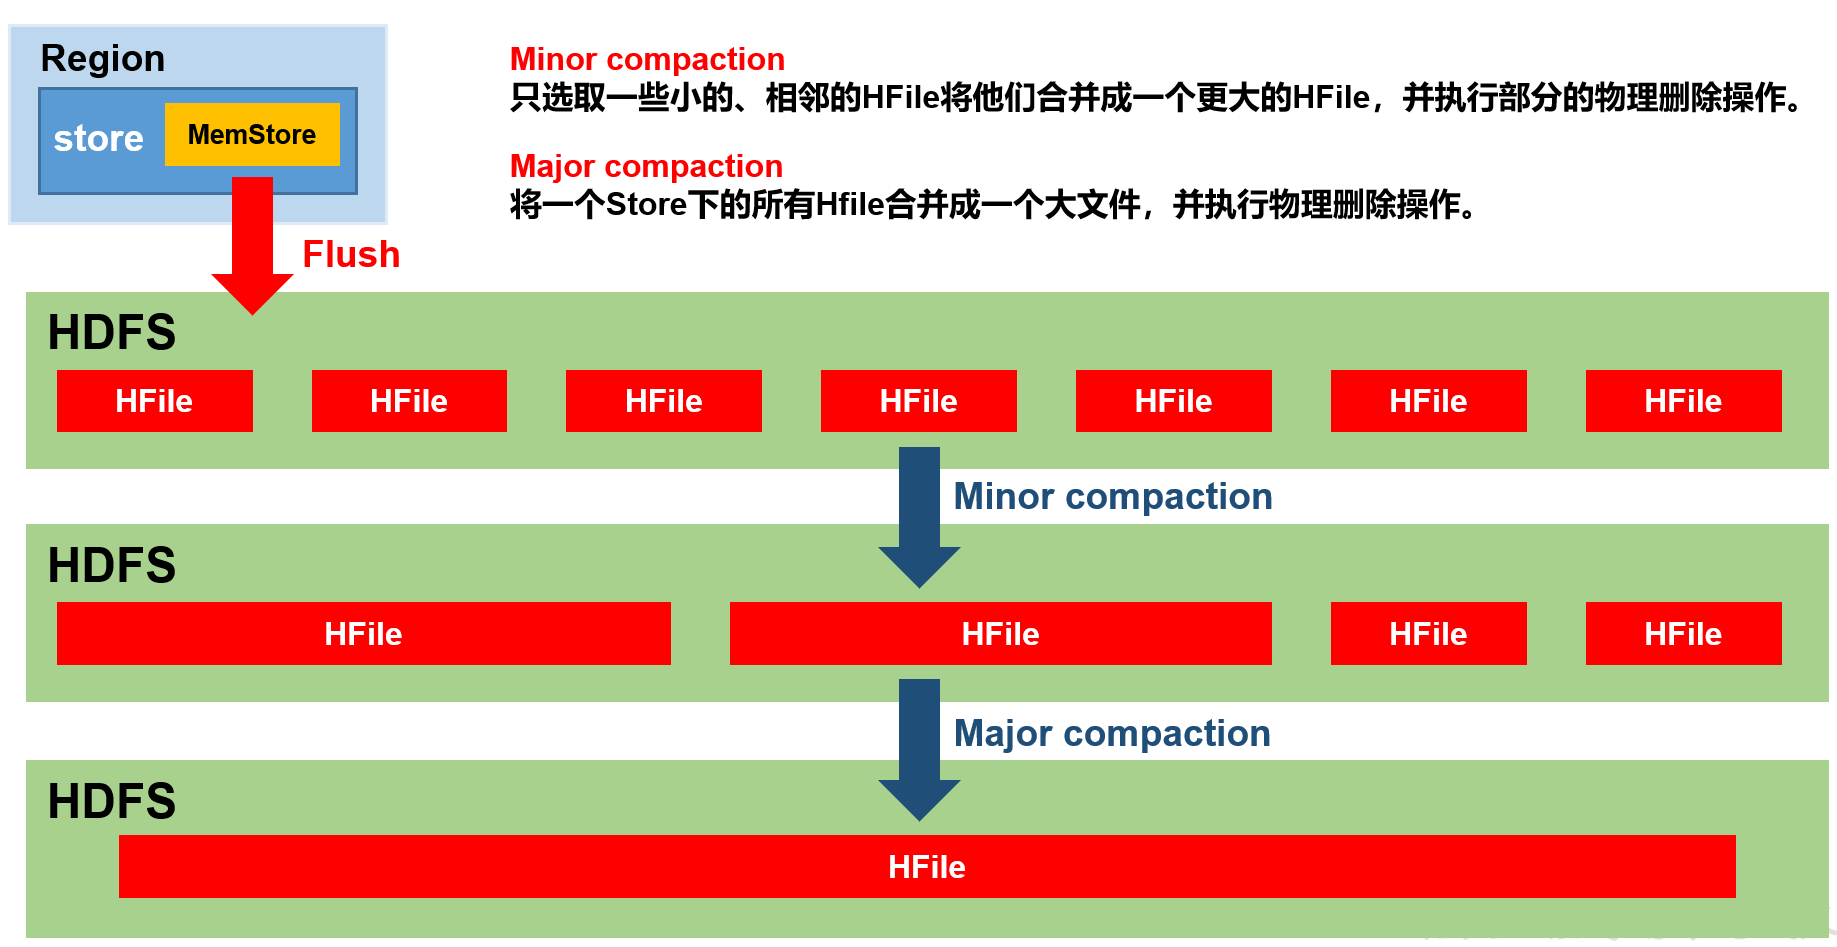
由于memstore每次刷写都会生成一个新的HFile,且同一个字段的不同版本(timestamp)和不同类型(Put/Delete)有可能会分布在不同的HFile中,因此查询时需要遍历所有的HFile。为了减少HFile的个数,以及清理掉过期和删除的数据,会进行StoreFile Compaction。

Compaction分为两种,分别是Minor Compaction和Major Compaction。Minor Compaction会将临近的若干个较小的HFile合并成一个较大的HFile,并清理掉部分过期和删除的数据。Major Compaction会将一个Store下的所有的HFile合并成一个大HFile,并且会清理掉所有过期和删除的数据。

1637811135391

1.6 Region Split

默认情况下,每个Table起初只有一个Region,随着数据的不断写入,Region会自动进行拆分。刚拆分时,两个子Region都位于当前的Region Server,但处于负载均衡的考虑,HMaster有可能会将某个Region转移给其他的Region Server。

Region Split时机:

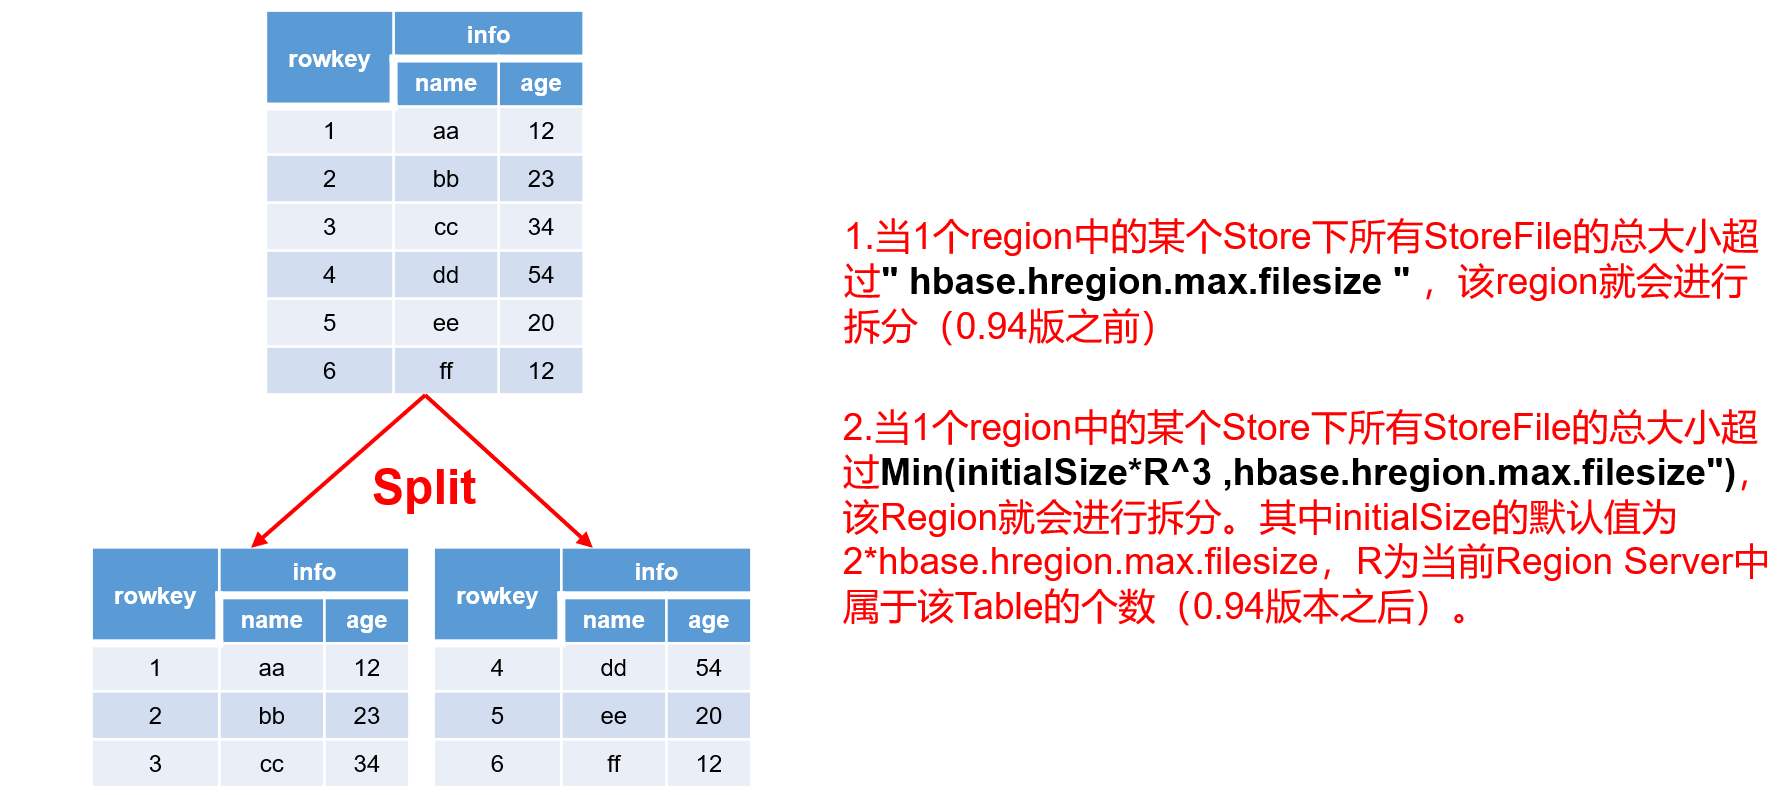
1)当1个region中的某个Store下所有StoreFile的总大小超过hbase.hregion.max.filesize,该Region就会进行拆分(0.94版本之前)。

2)当1个region中的某个Store下所有StoreFile的总大小超过*Min(initialSize x R^3 ,hbase.hregion.max.filesize”)**,该Region就会进行拆分。其中initialSize的默认值为2hbase.hregion.memstore.flush.size,R为当前Region Server中属于该Table的Region个数(0.94版本之后)。

具体的切分策略为:

第一次split:1^3 * 256 = 256MB

第二次split:2^3 * 256 = 2048MB

第三次split:3^3 * 256 = 6912MB

第四次split:4^3 * 256 = 16384MB > 10GB,因此取较小的值10GB

后面每次split的size都是10GB了。

3)Hbase 2.0引入了新的split策略:如果当前RegionServer上该表只有一个Region,按照2 * hbase.hregion.memstore.flush.size分裂,否则按照hbase.hregion.max.filesize分裂。

1637811167674

2 HBase优化

2.1 预分区(region)

建表的时候就设计好几个分区。

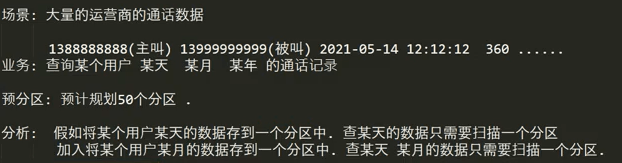
每一个region维护着startRow与endRowKey,如果加入的数据符合某个region维护的rowKey范围,则该数据交给这个region维护。那么依照这个原则,我们可以将数据所要投放的分区提前大致的规划好,以提高HBase性能。

1)手动设定预分区

hbase> create 'staff1','info',SPLITS => ['1000','2000','3000','4000']

2)生成16进制序列预分区

create 'staff2','info',&#123;NUMREGIONS => 15, SPLITALGO => 'HexStringSplit'&#125;

3)按照文件中设置的规则预分区

创建splits.txt文件内容如下:

aaaa
bbbb
cccc
dddd

然后执行:

create 'staff3','info',SPLITS_FILE => 'splits.txt'

4)使用JavaAPI创建预分区

//自定义算法,产生一系列Hash散列值存储在二维数组中
byte[][] splitKeys = 某个散列值函数
//创建HbaseAdmin实例
HBaseAdmin hAdmin = new HBaseAdmin(HbaseConfiguration.create());
//创建HTableDescriptor实例
HTableDescriptor tableDesc = new HTableDescriptor(tableName);
//通过HTableDescriptor实例和散列值二维数组创建带有预分区的Hbase表
hAdmin.createTable(tableDesc, splitKeys);

2.2 RowKey设计

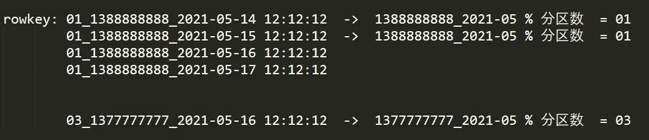
一条数据的唯一标识就是rowkey,那么这条数据存储于哪个分区,取决于rowkey处于哪个一个预分区的区间内,设计rowkey的主要目的 ,就是让数据均匀的分布于所有的region中,在一定程度上防止数据倾斜。接下来我们就谈一谈rowkey常用的设计方案。

1)生成随机数、hash、散列值

比如:
原本rowKey为1001的,SHA1后变成:dd01903921ea24941c26a48f2cec24e0bb0e8cc7
原本rowKey为3001的,SHA1后变成:49042c54de64a1e9bf0b33e00245660ef92dc7bd
原本rowKey为5001的,SHA1后变成:7b61dec07e02c188790670af43e717f0f46e8913
在做此操作之前,一般我们会选择从数据集中抽取样本,来决定什么样的rowKey来Hash后作为每个分区的临界值。

2)字符串反转

20170524000001转成10000042507102
20170524000002转成20000042507102

这样也可以在一定程度上散列逐步put进来的数据。

3)字符串拼接

20170524000001_a12e
20170524000001_93i7

rowkey设计原则:

唯一性 散列性 长度

1637828239660

1637828222514

1637828263210

2.3 内存优化

HBase操作过程中需要大量的内存开销,毕竟Table是可以缓存在内存中的,但是不建议分配非常大的堆内存,因为GC过程持续太久会导致RegionServer处于长期不可用状态,一般16~36G内存就可以了,如果因为框架占用内存过高导致系统内存不足,框架一样会被系统服务拖死。

2.4 基础优化

1)Zookeeper会话超时时间

hbase-site.xml

属性:zookeeper.session.timeout

解释:默认值为90000毫秒(90s)。当某个RegionServer挂掉,90s之后Master才能察觉到。可适当减小此值,以加快Master响应,可调整至60000毫秒。

2)设置RPC监听数量

hbase-site.xml

属性:zookeeper.session.timeout
解释:默认值为90000毫秒(90s)。当某个RegionServer挂掉,90s之后Master才能察觉到。可适当减小此值,以加快Master响应,可调整至60000毫秒。

3)手动控制Major Compaction

hbase-site.xml

属性:hbase.hregion.majorcompaction

解释:默认值:604800000秒(7天), Major Compaction的周期,若关闭自动Major Compaction,可将其设为0

4)优化HStore文件大小

hbase-site.xml

属性:hbase.hregion.max.filesize
解释:默认值10737418240(10GB),如果需要运行HBase的MR任务,可以减小此值,因为一个region对应一个map任务,如果单个region过大,会导致map任务执行时间过长。该值的意思就是,如果HFile的大小达到这个数值,则这个region会被切分为两个Hfile。

  1. 优化HBase客户端缓存

hbase-site.xml

属性:hbase.client.write.buffer
解释:默认值2097152bytes(2M)用于指定HBase客户端缓存,增大该值可以减少RPC调用次数,但是会消耗更多内存,反之则反之。一般我们需要设定一定的缓存大小,以达到减少RPC次数的目的。

6)指定scan.next扫描HBase所获取的行数

hbase-site.xml

属性:hbase.client.scanner.caching
解释:用于指定scan.next方法获取的默认行数,值越大,消耗内存越大。

7)BlockCache占用RegionServer堆内存的比例

hbase-site.xml

属性:hfile.block.cache.size
解释:默认0.4,读请求比较多的情况下,可适当调大

8.MemStore占用RegionServer堆内存的比例

hbase-site.xml

属性:hbase.regionserver.global.memstore.size
解释:默认0.4,写请求较多的情况下,可适当调大

HBase学习笔记(四) HBase整合phoenix和Hive

1 整合Phoenix

1.1 Phoenix简介

1.1.1 Phoenix定义

Phoenix是HBase的开源SQL皮肤。可以使用标准JDBC API代替HBase客户端API来创建表,插入数据和查询HBase数据。(Phoenix是HBase的JDBC类型客户端)。

可以把Phoenix理解成数据库,并且有事务,底层存储就是HBase。

Phoenix查询数据可以用sql查询的方式,Phoenix默认执行的语句到了hbase中都是大写的,除非使用双引号。

1.1.2 Phoenix特点

1)容易集成:如Spark,Hive,Pig,Flume和Map Reduce;

2)操作简单:DML命令(CRUD)以及通过DDL(建库建表)命令创建和操作表和版本化增量更改;

3)支持HBase二级索引创建。

1.1.3 Phoenix架构

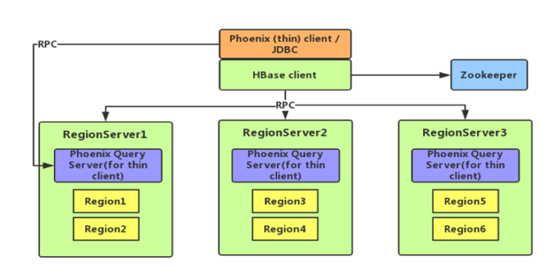
Phoenix怎么和HBase去集成呢?

(1)第一种方式:薄客户端:下图是Phoenix thin client,Phoenix thin client写Sql命令,Regionserver中的Phoenix Query server服务将其转化为Hbase语句。

(2)第二种方式:厚客户端:Phoenix thick client将Phoenix Query server服务封装到本身的Phoenix 客户端里面。Phoenix 内部直接将SQL转化为Hbase语句。

1637834908636

1.2 Phoenix快速入门

1.2.1 安装

1.官网地址

http://phoenix.apache.org/

2.Phoenix部署

1)上传并解压tar包

[molly@hadoop102 module]$ tar -zxvf apache-phoenix-5.0.0-HBase-2.0-bin.tar.gz -C /opt/module/
[molly@hadoop102 module]$ mv apache-phoenix-5.0.0-HBase-2.0-bin phoenix

2)复制Phoenix server包并拷贝到各个节点的hbase/lib:用于Phoenix 和连接hbase。分发后,重启hbase

[molly@hadoop102 module]$ cd /opt/module/phoenix/
[molly@hadoop102 phoenix]$ cp /opt/module/phoenix/phoenix-5.0.0-HBase-2.0-server.jar /opt/module/hbase/lib/
[molly@hadoop102 phoenix]$ xsync /opt/module/hbase/lib/phoenix-5.0.0-HBase-2.0-server.jar

4)配置环境变量

#phoenix
export PHOENIX_HOME=/opt/module/phoenix
export PHOENIX_CLASSPATH=$PHOENIX_HOME
export PATH=$PATH:$PHOENIX_HOME/bin

5)重启HBase

[molly@hadoop102 ~]$ stop-hbase.sh
[molly@hadoop102 ~]$ start-hbase.sh
  1. 厚Phoenix连接Hbase:sqlline.py
[molly@hadoop101 phoenix]$ /opt/module/phoenix/bin/sqlline.py hadoop102,hadoop103,hadoop104:2181

1637835818060

  1. 薄Phoenix连接Hbase:sqlline-thin.py

需要先启用queryserver.py,再启用sqlline-thin.py指定去找queryserver(端口8765)。

[molly@hadoop101 phoenix]$ /opt/module/phoenix/bin/queryserver.py 
[molly@hadoop101 phoenix]$ /opt/module/phoenix/bin/sqlline-thin.py hadoop102:8765

1637836402464

1.2.2 Phoenix Shell操作

1.2.2.1 schema的操作

1)创建schema(库)

默认情况下,在phoenix中不能直接创建schema。需要将如下的参数添加到Hbase中conf目录下的hbase-site.xml 和 phoenix中bin目录下的 hbase-site.xml中

  <property>
​    <name>phoenix.schema.isNamespaceMappingEnabled</name>
​    <value>true</value>
  </property>

重新启动Hbase和连接phoenix客户端.

[molly@hadoop102 ~]$ stop-hbase.sh
[molly@hadoop102 ~]$ start-hbase.sh
[molly@hadoop102 ~]$ /opt/module/phoenix/bin/sqlline.py hadoop102,hadoop103,hadoop104:2181

创建schema

create schema bigdata;
create schema if exists bigdata;

注意:在phoenix中,schema名,表名,字段名等会自动转换为大写,若要小写,使用双引号,如”student”。

1.2.2.2 表的操作

1)显示所有表

!table 或 !tables

2)创建表

直接指定单个列作为RowKey

CREATE TABLE IF NOT EXISTS student(
id VARCHAR primary key,
name VARCHAR,
addr VARCHAR);

指定多个列的联合作为RowKey

3)插入数据

upsert into student values('1001','zhangsan','beijing');

4)查询记录

select * from student;
select * from student where id='1001';

5)删除记录

delete from student where id='1001';

6)删除表

drop table student;

7)退出命令行

!quit

1.2.2.3 表的映射

1)表的关系

默认情况下,直接在HBase中创建的表,通过Phoenix是查看不到的。如果要在Phoenix中操作直接在HBase中创建的表,则需要在Phoenix中进行表的映射。映射方式有两种:视图映射和表映射。

2)命令行中创建表test

HBase 中test的表结构如下,两个列族info1、info2。

Rowkeyinfo1info2
idnameaddress

启动HBase Shell

[molly@hadoop102 ~]$ /opt/module/hbase/bin/hbase shell

创建HBase表test

hbase(main):001:0> create 'test','info1','info2'

3)视图映射

Phoenix创建的视图是只读的,所以只能用来做查询,无法通过视图对源数据进行修改等操作。在phoenix中创建关联test表的视图

0: jdbc:phoenix:hadoop101,hadoop102,hadoop103> create view "test"(id varchar primary key,"info1"."name" varchar, "info2"."address" varchar);

删除视图

0: jdbc:phoenix:hadoop101,hadoop102,hadoop103> drop view "test";

4)表映射

使用Apache Phoenix创建对HBase的表映射,有两种方法:

(1)HBase中不存在表时,可以直接使用create table指令创建需要的表,系统将会自动在Phoenix和HBase中创建person_infomation的表,并会根据指令内的参数对表结构进行初始化。

(2)当HBase中已经存在表时,可以以类似创建视图的方式创建关联表,只需要将create view改为create table即可。

0: jdbc:phoenix:hadoop101,hadoop102,hadoop103> create table "test"(id varchar primary key,"info1"."name" varchar, "info2"."address" varchar) column_encoded_bytes=0;

1.2.2.4表映射中数值类型的问题

Hbase中存储数值类型的值(如int,long等)会按照正常数字的补码进行存储. 而phoenix对数字的存储做了特殊的处理. phoenix 为了解决遇到正负数同时存在时,导致负数排到了正数的后面(负数高位为1,正数高位为0,字典序0 < 1)的问题。 phoenix在存储数字时会对高位进行转换.原来为1,转换为0, 原来为0,转换为1.

因此,如果hbase表中的数据的写是由phoenix写入的,不会出现问题,因为对数字的编解码都是phoenix来负责。如果hbase表中的数据不是由phoenix写入的,数字的编码由hbase负责. 而phoenix读数据时要对数字进行解码。 因为编解码方式不一致。导致数字出错.

1) 在hbase中创建表,并插入数值类型的数据

hbase(main):001:0> create 'person','info'
hbase(main):001:0> put 'person','1001', 'info:salary',Bytes.toBytes(123456)

注意: 如果要插入数字类型,需要通过Bytes.toBytes(123456)来实现。

2)在phoenix中创建映射表并查询数据

create table "person"(id varchar primary key,"info"."salary" integer ) 

column_encoded_bytes=0

select * from "person"

会发现数字显示有问题

3) 解决办法:

在phoenix中创建表时使用无符号的数值类型. unsigned_long

create table "person"(id varchar primary key,"info"."salary" unsigned_long ) 
column_encoded_bytes=0;

1.2.3 Phoenix JDBC API操作

1.2.3.1 Thin Client

1)启动query server

[molly@hadoop102 ~]$ queryserver.py start

2)创建项目并导入依赖

 <dependencies>
​    <dependency>
​      <groupId>org.apache.phoenix</groupId>
​      <artifactId>phoenix-queryserver-client</artifactId>
​      <version>5.0.0-HBase-2.0</version>
​    </dependency>
  </dependencies>

3)编写代码

package com.atguigu;

import java.sql.*;
import org.apache.phoenix.queryserver.client.ThinClientUtil;

public class PhoenixTest &#123;
public static void main(String[] args) throws SQLException &#123;

        String connectionUrl = ThinClientUtil.getConnectionUrl("hadoop102", 8765);

        Connection connection = DriverManager.getConnection(connectionUrl);
        PreparedStatement preparedStatement = connection.prepareStatement("select * from student");

        ResultSet resultSet = preparedStatement.executeQuery();

        while (resultSet.next()) &#123;
            System.out.println(resultSet.getString(1) + "\t" + resultSet.getString(2));
        &#125;

        //关闭
        connection.close();

&#125;
&#125;

1.2.3.2 Thick Client

1)在pom中加入依赖

 <dependencies>
        <dependency>
            <groupId>org.apache.phoenix</groupId>
            <artifactId>phoenix-core</artifactId>
            <version>5.0.0-HBase-2.0</version>
            <exclusions>
                <exclusion>
                    <groupId>org.glassfish</groupId>
                    <artifactId>javax.el</artifactId>
                </exclusion>
            </exclusions>
        </dependency>

        <dependency>
            <groupId>org.glassfish</groupId>
            <artifactId>javax.el</artifactId>
            <version>3.0.1-b06</version>
        </dependency>
    </dependencies>

2)编写代码

package com.atguigu.phoenix.thin;
import java.sql.*;
import java.util.Properties;
public class TestThick &#123;

    public static void main(String[] args) throws SQLException &#123;
        String url = "jdbc:phoenix:hadoop102,hadoop103,hadoop104:2181";
        Properties props = new Properties();
        props.put("phoenix.schema.isNamespaceMappingEnabled","true");
        Connection connection = DriverManager.getConnection(url,props);
        PreparedStatement ps = connection.prepareStatement("select * from \"test\"");
        ResultSet rs = ps.executeQuery();
        while(rs.next())&#123;
            System.out.println(rs.getString(1)+":" +rs.getString(2));
        &#125;
    &#125;
&#125;

1.3 Phoenix二级索引

1.3.1 二级索引配置文件

1.添加如下配置到HBase的HRegionserver节点的hbase-site.xml

  <!-- phoenix regionserver 配置参数-->
    <property>
        <name>hbase.regionserver.wal.codec</name>
        <value>org.apache.hadoop.hbase.regionserver.wal.IndexedWALEditCodec</value>
    </property>

    <property>
        <name>hbase.region.server.rpc.scheduler.factory.class</name>
        <value>org.apache.hadoop.hbase.ipc.PhoenixRpcSchedulerFactory</value>
        <description>Factory to create the Phoenix RPC Scheduler that uses separate queues for index and metadata updates</description>
    </property>

    <property>
        <name>hbase.rpc.controllerfactory.class</name>
        <value>org.apache.hadoop.hbase.ipc.controller.ServerRpcControllerFactory</value>
        <description>Factory to create the Phoenix RPC Scheduler that uses separate queues for index and metadata updates</description>
    </property>

1.3.2 全局二级索引

Global Index是默认的索引格式,创建全局索引时,会在HBase中建立一张新表。也就是说索引数据和数据表是存放在不同的表中的,因此全局索引适用于多读少写的业务场景。

写数据的时候会消耗大量开销,因为索引表也要更新,而索引表是分布在不同的数据节点上的,跨节点的数据传输带来了较大的性能消耗。

在读数据的时候Phoenix会选择索引表来降低查询消耗的时间。

  1. 创建单个字段的全局索引
CREATE INDEX my_index ON my_table (my_col);

1637837037624

如果想查询的字段不是索引字段的话索引表不会被使用,也就是说不会带来查询速度的提升。

2)创建携带其他字段的全局索引

CREATE INDEX my_index ON my_table (v1) INCLUDE (v2);

1637837124230

1.3.3 本地二级索引

Local Index适用于写操作频繁的场景。

索引数据和数据表的数据是存放在同一张表中(且是同一个Region),避免了在写操作的时候往不同服务器的索引表中写索引带来的额外开销。

CREATE LOCAL INDEX my_index ON my_table (my_column);

1637837158438

2 与Hive的集成

2.1 HBase与Hive的对比

2.1.1 Hive

(1) 数据分析工具

Hive的本质其实就相当于将HDFS中已经存储的文件在Mysql中做了一个双射关系,以方便使用HQL去管理查询。

(2) 用于数据分析、清洗

Hive适用于离线的数据分析和清洗,延迟较高。

(3) 基于HDFS、MapReduce

Hive存储的数据依旧在DataNode上,编写的HQL语句终将是转换为MapReduce代码执行。

2.1.2 HBase

(1) 数据库

是一种面向列族存储的非关系型数据库。

(2) 用于存储结构化和非结构化的数据

适用于单表非关系型数据的存储,不适合做关联查询,类似JOIN等操作。

(3) 基于HDFS

数据持久化存储的体现形式是HFile,存放于DataNode中,被ResionServer以region的形式进行管理。

(4) 延迟较低,接入在线业务使用

面对大量的企业数据,HBase可以直线单表大量数据的存储,同时提供了高效的数据访问速度。

2.2 HBase与Hive集成使用

在hive-site.xml中添加zookeeper的属性,如下:

    <property>
        <name>hive.zookeeper.quorum</name>
        <value>hadoop102,hadoop103,hadoop104</value>
    </property>

    <property>
        <name>hive.zookeeper.client.port</name>
        <value>2181</value>
    </property>

案例一

目标:建立Hive表,关联HBase表,插入数据到Hive表的同时能够影响HBase表。

分步实现:

1.在Hive中创建表同时关联HBase

CREATE TABLE hive_hbase_emp_table(
empno int,
ename string,
job string,
mgr int,
hiredate string,
sal double,
comm double,
deptno int)
STORED BY 'org.apache.hadoop.hive.hbase.HBaseStorageHandler'
WITH SERDEPROPERTIES ("hbase.columns.mapping" = ":key,info:ename,info:job,info:mgr,info:hiredate,info:sal,info:comm,info:deptno")
TBLPROPERTIES ("hbase.table.name" = "hbase_emp_table");

提示:完成之后,可以分别进入Hive和HBase查看,都生成了对应的表

2.在Hive中创建临时中间表,用于load文件中的数据

提示:不能将数据直接load进Hive所关联HBase的那张表中

CREATE TABLE emp(
empno int,
ename string,
job string,
mgr int,
hiredate string,
sal double,
comm double,
deptno int)
row format delimited fields terminated by '\t';

3.向Hive中间表中load数据

hive> load data local inpath '/home/admin/softwares/data/emp.txt' into table emp;

4.通过insert命令将中间表中的数据导入到Hive关联Hbase的那张表中

hive> insert into table hive_hbase_emp_table select * from emp;

5.查看Hive以及关联的HBase表中是否已经成功的同步插入了数据
Hive:

hive> select * from hive_hbase_emp_table;

HBase:

Hbase> scan 'hbase_emp_table'

案例二

目标:在HBase中已经存储了某一张表hbase_emp_table,然后在Hive中创建一个外部表来关联HBase中的hbase_emp_table这张表,使之可以借助Hive来分析HBase这张表中的数据。

注:该案例2紧跟案例1的脚步,所以完成此案例前,请先完成案例1。

分步实现:

1.在Hive中创建外部表

CREATE EXTERNAL TABLE relevance_hbase_emp(
empno int,
ename string,
job string,
mgr int,
hiredate string,
sal double,
comm double,
deptno int)
STORED BY 
'org.apache.hadoop.hive.hbase.HBaseStorageHandler'
WITH SERDEPROPERTIES ("hbase.columns.mapping" = 
":key,info:ename,info:job,info:mgr,info:hiredate,info:sal,info:comm,info:deptno") 
TBLPROPERTIES ("hbase.table.name" = "hbase_emp_table");

2.关联后就可以使用Hive函数进行一些分析操作了

hive (default)> select * from relevance_hbase_emp;

HBase学习笔记(三) HBase的API使用

1 环境准备

新建项目后在pom.xml中添加依赖

<dependency>
    <groupId>org.apache.hbase</groupId>
    <artifactId>hbase-server</artifactId>
    <version>2.0.5</version>
</dependency>

<dependency>
    <groupId>org.apache.hbase</groupId>
    <artifactId>hbase-client</artifactId>
    <version>2.0.5</version>
</dependency>

API官方手册:

https://hbase.apache.org/2.2/apidocs/index.html

2 DDL

创建HBase_DDL类

2.1 判断表是否存在和创建命名空间

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.NamespaceDescriptor;
import org.apache.hadoop.hbase.NamespaceExistException;
import org.apache.hadoop.hbase.TableName;
import org.apache.hadoop.hbase.client.*;
import org.apache.hadoop.hbase.util.Bytes;

import java.io.IOException;

public class HBase_DDL &#123;

    //TODO 判断表是否存在
    public static boolean isTableExist(String tableName) throws IOException &#123;

        //1.创建配置信息并配置
        Configuration configuration = HBaseConfiguration.create();
        configuration.set("hbase.zookeeper.quorum", "hadoop102,hadoop103,hadoop104");

        //2.获取与HBase的连接
        Connection connection = ConnectionFactory.createConnection(configuration);

        //3.获取DDL操作对象
        Admin admin = connection.getAdmin();

        //4.1判断表是否存在操作
        boolean exists = admin.tableExists(TableName.valueOf(tableName));

        //4.2 创建命名空间
         //42.1创建命名空间描述器
        NamespaceDescriptor namespaceDescriptor = NamespaceDescriptor.create(ns).build();
        //4.2.2执行创建命名空间操作
        try &#123;
            admin.createNamespace(namespaceDescriptor);
        &#125; catch (NamespaceExistException e) &#123;
            System.out.println("命名空间已存在!");
        &#125; catch (Exception e) &#123;
            e.printStackTrace();
        &#125;

        //5.关闭连接
        admin.close();
        connection.close();

        //6.返回结果
        return exists;
    &#125;

&#125;

2.2 创建表

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.NamespaceDescriptor;
import org.apache.hadoop.hbase.NamespaceExistException;
import org.apache.hadoop.hbase.TableName;
import org.apache.hadoop.hbase.client.*;
import org.apache.hadoop.hbase.util.Bytes;

import java.io.IOException;

public class HBase_DDL &#123;

    //TODO 创建表
    public static void createTable(String tableName, String... cfs) throws IOException &#123;

        //1.判断是否存在列族信息
        if (cfs.length <= 0) &#123;
            System.out.println("请设置列族信息!");
            return;
        &#125;

        //2.判断表是否存在
        if (isTableExist(tableName)) &#123;
            System.out.println("需要创建的表已存在!");
            return;
        &#125;

        //3.创建配置信息并配置
        Configuration configuration = HBaseConfiguration.create();
        configuration.set("hbase.zookeeper.quorum", "hadoop102,hadoop103,hadoop104");

        //4.获取与HBase的连接
        Connection connection = ConnectionFactory.createConnection(configuration);

        //5.获取DDL操作对象
        Admin admin = connection.getAdmin();

        //6.创建表描述器构造器
        TableDescriptorBuilder tableDescriptorBuilder = TableDescriptorBuilder.newBuilder(TableName.valueOf(tableName));

        //7.循环添加列族信息
        for (String cf : cfs) &#123;
            ColumnFamilyDescriptorBuilder columnFamilyDescriptorBuilder = ColumnFamilyDescriptorBuilder.newBuilder(Bytes.toBytes(cf));
            tableDescriptorBuilder.setColumnFamily(columnFamilyDescriptorBuilder.build());
        &#125;

        //8.执行创建表的操作
        admin.createTable(tableDescriptorBuilder.build());

        //9.关闭资源
        admin.close();
        connection.close();
    &#125;

&#125;

2.3 删除表

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.NamespaceDescriptor;
import org.apache.hadoop.hbase.NamespaceExistException;
import org.apache.hadoop.hbase.TableName;
import org.apache.hadoop.hbase.client.*;
import org.apache.hadoop.hbase.util.Bytes;

import java.io.IOException;

public class HBase_DDL &#123;

    //TODO 删除表
    public static void dropTable(String tableName) throws IOException &#123;

        //1.判断表是否存在
        if (!isTableExist(tableName)) &#123;
            System.out.println("需要删除的表不存在!");
            return;
        &#125;

        //2.创建配置信息并配置
        Configuration configuration = HBaseConfiguration.create();
        configuration.set("hbase.zookeeper.quorum", "hadoop102,hadoop103,hadoop104");

        //3.获取与HBase的连接
        Connection connection = ConnectionFactory.createConnection(configuration);

        //4.获取DDL操作对象
        Admin admin = connection.getAdmin();

        //5.使表下线
        TableName name = TableName.valueOf(tableName);
        admin.disableTable(name);

        //6.执行删除表操作
        admin.deleteTable(name);

        //7.关闭资源
        admin.close();
        connection.close();
    &#125;

&#125;

3 DML

创建类HBase_DML

(1) 插入数据

(2) 单条数据查询

(3) 扫描数据

(4) 删除数据

import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.hbase.Cell;
import org.apache.hadoop.hbase.HBaseConfiguration;
import org.apache.hadoop.hbase.TableName;
import org.apache.hadoop.hbase.client.*;
import org.apache.hadoop.hbase.util.Bytes;

import java.io.IOException;

public class HBase_DML &#123;

    //TODO 插入数据
    public static void putData(String tableName, String rowKey, String cf, String cn, String value) throws IOException &#123;

        //1.获取配置信息并设置连接参数
        Configuration configuration = HBaseConfiguration.create();
        configuration.set("hbase.zookeeper.quorum", "hadoop102,hadoop103,hadoop104");

        //2.获取连接
        Connection connection = ConnectionFactory.createConnection(configuration);

        //3.获取表的连接
        Table table = connection.getTable(TableName.valueOf(tableName));
    //4.1 插入数据
        //4.1.1 创建Put对象
        Put put = new Put(Bytes.toBytes(rowKey));
        //4.1.2 放入数据
        put.addColumn(Bytes.toBytes(cf), Bytes.toBytes(cn), Bytes.toBytes(value));
        //4.1.3 执行插入数据操作
        table.put(put);
     //4.2 单条数据查询
          //4.2.1 创建Get对象
        Get get = new Get(Bytes.toBytes(rowKey));
        // 指定列族查询
        // get.addFamily(Bytes.toBytes(cf));
        // 指定列族:列查询
        // get.addColumn(Bytes.toBytes(cf), Bytes.toBytes(cn));
        //4.2.2查询数据
        Result result = table.get(get);
        //4.2.3解析result
        for (Cell cell : result.rawCells()) &#123;
            System.out.println("ROW:" + Bytes.toString(CellUtil.cloneRow(cell)) +
                        " CF:" + Bytes.toString(CellUtil.cloneFamily(cell))+
                        " CL:" + Bytes.toString(CellUtil.cloneQualifier(cell))+
                        " VALUE:" + Bytes.toString(CellUtil.cloneValue(cell)));
        &#125;

 //4.3 scan数据
        //4.3.1创建Scan对象
        Scan scan = new Scan();
        //4.3.2扫描数据
        ResultScanner results = table.getScanner(scan);

        //4.3.3 解析results
        for (Result result : results) &#123;
            for (Cell cell : result.rawCells()) &#123;
      System.out.println(                       Bytes.toString(CellUtil.cloneRow(cell))+":"+ Bytes.toString(CellUtil.cloneFamily(cell))+":" +  Bytes.toString(CellUtil.cloneQualifier(cell)) +":" +  Bytes.toString(CellUtil.cloneValue(cell))
                );
            &#125;
        &#125;
 //4.4 删除数据
         //4.4.1创建Delete对象
        Delete delete = new Delete(Bytes.toBytes(rowKey));

        // 指定列族删除数据
        // delete.addFamily(Bytes.toBytes(cf));
        // 指定列族:列删除数据(所有版本)
        // delete.addColumn(Bytes.toBytes(cf), Bytes.toBytes(cn));
        // 指定列族:列删除数据(指定版本)
        // delete.addColumns(Bytes.toBytes(cf), Bytes.toBytes(cn));
        //4.4.2执行删除数据操作
        table.delete(delete);

        //5.关闭连接
        table.close();
        connection.close();
    &#125;

&#125;

HBase学习笔记(一) 安装教程

1 HBase简介

1.1 HBase定义

HBase是一种分布式、可扩展、支持海量数据存储的NoSQL数据库。HBase底层是HDFS。用于实时处理场景。

1.2 HBase数据模型

逻辑上,HBase的数据模型同关系型数据库很类似,数据存储在一张表中,有行有列。但从HBase的底层物理存储结构(K-V)来看,HBase更像是一个multi-dimensional map。

1.2.1 HBase逻辑结构

再HBase中列不能单独存在,必须属于某个列族。一个列族有多个列。

Row key:行键 唯一性 自动排序(字典排序)。

region:分区,表横向切开 去维护。一个Region是存到一起的,即存到同一个机器中。

store: 按照列族去切割,一个store存到一个文件中。

​ 1637809034793

1.2.2 HBase物理存储结构(底层真实存储)

物理存储(真实存储的结构)其实是以KV进行存储,并存储在HDFS中,例如第一条数据:

1637821581208

通过时间戳TimeStamp去标识不同版本,因为HBase不能修改,因此,修改一条数据就是通过追加一条新数据,但是加一个新的时间戳。因此显示的时候,显示时间戳最大的数据即可。过期的数据会按照一定的机制去删除。

因此Hbase修改和新增的Type都是PUT。删除的Type是deletecolumn。

1637809177548

1.2.3 数据模型

1)Name Space

命名空间,类似于关系型数据库的database概念,每个命名空间下有多个表。HBase有两个自带的命名空间,分别是hbase和default,hbase中存放的是HBase内置的表,default表是用户默认使用的命名空间。

2)Table

类似于关系型数据库的表概念。不同的是,HBase定义表时只需要声明列族即可,不需要声明具体的列。这意味着,往HBase写入数据时,字段可以动态、按需指定。因此,和关系型数据库相比,HBase能够轻松应对字段变更的场景。

3)Row

HBase表中的每行数据都由一个RowKey和多个Column(列)组成,数据是按照RowKey的字典顺序存储的,并且查询数据时只能根据RowKey进行检索,所以RowKey的设计十分重要(如果根据其他列去查询例如名字,就会全表扫描,因此效率很低,通常不会使用)。

4)Column

HBase中的每个列都由Column Family(列族)**和Column Qualifier(列限定符)**进行限定,例如info:name,info:age。建表时,只需指明列族,而列限定符无需预先定义。

5)Time Stamp

用于标识数据的不同版本(version),每条数据写入时,系统会自动为其加上该字段,其值为写入HBase的时间。

6)Cell

由{rowkey, column Family:column Qualifier, time Stamp} 唯一确定的单元。cell中的数据全部是字节码形式存贮。

1.3 HBase基本架构(不完整版本)

架构角色:

1)Region Server

Region Server为 Region的管理者,其实现类为HRegionServer,主要作用如下:

对于数据的操作:get, put, delete;(查询修改删除)

对于Region的操作:splitRegion(切分)、compactRegion(合并storeFile)。

2)Master

Master是所有Region Server的管理者,其实现类为HMaster,主要作用如下:

对于表的操作:create, delete, alter(涉及元数据的管理)

对于RegionServer的操作:分配regions到每个RegionServer,监控每个RegionServer的状态,负载均衡和故障转移。

3)Zookeeper

HBase通过Zookeeper来做master的高可用、RegionServer的监控、元数据的入口以及集群配置的维护等工作。

4)HDFS

HDFS为Hbase提供最终的底层数据存储服务,同时为HBase提供高可用的支持。

1637809993409

2 HBase安装部署

2.1 HBase的解压

解压Hbase到指定目录:

[molly@hadoop102 software]$ tar -zxvf hbase-2.0.5-bin.tar.gz -C /opt/module
[molly@hadoop102 software]$ mv /opt/module/hbase-2.0.5 /opt/module/hbase

配置环境变量

[molly@hadoop102 ~]$ sudo vim /etc/profile.d/my_env.sh
#添加
#HBASE_HOME
export HBASE_HOME=/opt/module/hbase
export PATH=$PATH:$HBASE_HOME/bin

2.2 HBase的配置文件

修改HBase对应的配置文件。

1)hbase-env.sh修改内容:

不要使用内置的ZK。

export HBASE_MANAGES_ZK=false

2)hbase-site.xml修改内容:

<configuration>
    <property>
        <name>hbase.rootdir</name>
        <value>hdfs://hadoop102:8020/hbase</value>
    </property>

    <property>
        <name>hbase.cluster.distributed</name>
        <value>true</value>
    </property>

    <property>
        <name>hbase.zookeeper.quorum</name>
        <value>hadoop102,hadoop103,hadoop104</value>
    </property>
</configuration>

3)regionservers:类似于workers

vim regionservers
hadoop102
hadoop103
hadoop104

2.3 HBase远程发送到其他集群

[molly@hadoop102 module]$ xsync hbase/

2.4 Zookeeper正常部署

首先保证Zookeeper集群的正常部署,并启动之:

[molly@hadoop102 zookeeper-3.5.7]$ bin/zkServer.sh start
[molly@hadoop103 zookeeper-3.5.7]$ bin/zkServer.sh start
[molly@hadoop104 zookeeper-3.5.7]$ bin/zkServer.sh start

2.5Hadoop正常部署

Hadoop集群的正常部署并启动:

[molly@hadoop102 hadoop-3.1.3]$ sbin/start-dfs.sh
[molly@hadoop103 hadoop-3.1.3]$ sbin/start-yarn.sh

2.6 HBase服务的启动

2.6.1 单点启动

[molly@hadoop102 hbase]$ bin/hbase-daemon.sh start master
[molly@hadoop102 hbase]$ bin/hbase-daemon.sh start regionserver

提示:如果集群之间的节点时间不同步,会导致regionserver无法启动,抛出ClockOutOfSyncException异常。

修复提示:错误提示如下所示:

1637823414826

a、同步时间服务

将几台机器进行时间同步操作。

b、属性:hbase.master.maxclockskew设置更大的值

<property>
        <name>hbase.master.maxclockskew</name>
        <value>180000</value>
        <description>Time difference of regionserver from master</description>
</property>

2.6.2 群启

[molly@hadoop102 hbase]$ bin/start-hbase.sh

对应的停止服务:

[molly@hadoop102 hbase]$ bin/stop-hbase.sh

1637822682585

可以看到在那台机器去启用Hbase,那台就是HMaster,这里可以看到102是HMaster

1637822698155

查看ZK:

1637822773695

2.7 查看HBase页面

启动成功后,可以通过“host:port”的方式来访问HBase管理页面,例如:

http://hadoop102:16010 可以看到有3个region server

1637822822917

2.8 高可用(可选)

在HBase中HMaster负责监控HRegionServer的生命周期,均衡RegionServer的负载,如果HMaster挂掉了,那么整个HBase集群将陷入不健康的状态,并且此时的工作状态并不会维持太久。所以HBase支持对HMaster的高可用配置。

1)关闭HBase集群(如果没有开启则跳过此步)

[molly@hadoop102 hbase]$ bin/stop-hbase.sh

2)在conf目录下创建backup-masters文件

[molly@hadoop102 hbase]$ touch conf/backup-masters

3)在backup-masters文件中配置高可用HMaster节点

[molly@hadoop102 hbase]$ echo hadoop103 > conf/backup-masters

4)将整个conf目录scp到其他节点

[molly@hadoop102 hbase]$ scp -r conf/ hadoop103:/opt/module/hbase/
[molly@hadoop102 hbase]$ scp -r conf/ hadoop104:/opt/module/hbase/

5)打开页面测试查看

http://hadooo102:16010

3 HBase Shell操作

3.1 基本操作

1)进入HBase客户端命令行

[molly@hadoop102 hbase]$ bin/hbase shell

2)查看帮助命令

hbase(main):001:0> help 

3.2 namespace的操作

1)查看当前Hbase中有哪些namespace

hbase(main):002:0> list_namespace

NAMESPACE

default(创建表时未指定命名空间的话默认在default下)

hbase(系统使用的,用来存放系统相关的元数据信息等,勿随便操作)

2)创建namespace

hbase(main):010:0> create_namespace "test"
hbase(main):010:0> create_namespace "test01", &#123;"author"=>"wyh", "create_time"=>"2020-03-10 08:08:08"&#125;

3)查看namespace

hbase(main):010:0>  describe_namespace "test01"

4)修改namespace的信息(添加或者修改属性)

hbase(main):010:0> alter_namespace "test01", &#123;METHOD => 'set', 'author' => 'weiyunhui'&#125;

添加或者修改属性:

alter_namespace 'ns1', &#123;METHOD => 'set', 'PROPERTY_NAME' => 'PROPERTY_VALUE'&#125; 

删除属性:

alter_namespace 'ns1', &#123;METHOD => 'unset', NAME => ' PROPERTY_NAME '&#125; 

5)删除namespace

hbase(main):010:0> drop_namespace "test01"

注意: 要删除的namespace必须是空的,其下没有表。

3.3 表的操作

0)查看当前数据库中有哪些表

hbase(main):002:0> list

1)创建表

创建student表,列族info

hbase(main):002:0> create 'student','info'

2)插入数据到表

表明,rowkey,列,value

hbase(main):003:0> put 'student','1001','info:sex','male'
hbase(main):004:0> put 'student','1001','info:age','18'
hbase(main):005:0> put 'student','1002','info:name','Janna'
hbase(main):006:0> put 'student','1002','info:sex','female'
hbase(main):007:0> put 'student','1002','info:age','20'

3)扫描查看表数据

hbase(main):008:0> scan 'student'
hbase(main):009:0> scan 'student',&#123;STARTROW => '1001', STOPROW => '1001'&#125;
hbase(main):010:0> scan 'student',&#123;STARTROW => '1001'&#125;

4)查看表结构

hbase(main):011:0> describe 'student'

5)更新指定字段的数据

hbase(main):012:0> put 'student','1001','info:name','Nick'
hbase(main):013:0> put 'student','1001','info:age','100'

6)查看“指定行”或“指定列族:列”的数据必须:指定rowkey

hbase(main):014:0> get 'student','1001'
hbase(main):015:0> get 'student','1001','info:name'
hbase(main):015:0> get 'student','1001','info:name','info:age'

7)统计表数据行数

hbase(main):021:0> count 'student'

8)删除数据

删除某rowkey的全部数据:

hbase(main):016:0> deleteall 'student','1001'

删除某rowkey的某一列数据:

hbase(main):017:0> delete 'student','1002','info:sex'

9)清空表数据

hbase(main):018:0> truncate 'student'

提示:清空表的操作顺序为先disable,然后再truncate。

10)删除表

首先需要先让该表为disable状态:

hbase(main):019:0> disable 'student'

然后才能drop这个表:

hbase(main):020:0> drop 'student'

提示:如果直接drop表,会报错:ERROR: Table student is enabled. Disable it first.

11)变更表信息

将info列族中的数据存放3个版本:

hbase(main):022:0> alter 'student',&#123;NAME=>'info',VERSIONS=>3&#125;
hbase(main):022:0> get 'student','1001',&#123;COLUMN=>'info:name',VERSIONS=>3&#125;

大数据实践(一)数仓采集项目

1 数仓概念

1637651564709

2 项目需求及架构设计

2.1 项目需求分析

1)用户行为数据采集平台搭建(存在日志服务器-用flume采集到数据仓库(hdfs)中)
2)业务数据采集平台搭建(存在mysql,oracle):通过sqoop采集到数据仓库(hdfs)中
3)数据仓库维度建模:建库建表
4)分析,设备 会员 商品 地区 活动等电商核心主题,统计的报表指标近100个。
5)采用即席查询工具,随时进行指标分析
6)对集群性能进行监控,发送异常需要报警
7)元数据管理:管理Hive的元数据(数仓的核心就是hive)
8)质量监控:数仓分析的质量 有没有丢数据等

2.2 项目框架

2.2.1 技术选型

技术选型主要考虑因素:数据量大小,业务需求,行业内经验,技术成熟度、开发维护成本、总成本预算。下面加粗的是本次选择的。

  • 数据采集传输:Flume,Logstash(elk系列),Kafka,Sqoop(开源的),DataX(阿里技术,比Sqoop强大)
  • 数据存储:Mysq,HDFS,HBase,Redis,MongoDB
  • 数据计算:Hive,Tez,Spark,Flink,Storm(Hive底层用Tex或者Spark),Storm较早 不用
  • 数据查询:Presto,Kylin(Apache),Impala,Druid
  • 数据可视化:Echarts(百度的,现在已经是Apache的了),Superset(开源),QuickBI,DataV(后两个都是阿里)
  • 任务调度:Azkaban(Apache的,可视化界面),Oozie(CDH生态,HUE,功能比azkaban强大)
  • 集群监控:Zabbix
  • 元数据管理:Atlas

2.2.2 系统数据流程设计

1637652372079

多个Flume往HDFS中写数据,会有压力,因此中间部署Kafka,来缓冲。

Hive通过写sql对数据进行处理,主要有5层处理,分别是ods,dwd,dws,dwt,ads。

对整个仓库的任务:利用什么时候导入数据等用Azkaban来调度。

2.2.3 框架版本选型

1)如何选择Apache/CDH/HDP版本?

Apache:运维麻烦;组件间兼容性需要自己调研(一般大厂使用,技术实力雄厚,有专业的运维人员)

CDH:国内使用最多的版本,但是CM不开源。2021年开始收费,一个节点1万美金

HDP:开源,可以进行二次开发,但是没有CDH稳定,国内使用较少

目前CDH和HDP已经合并了。

2)框架版本参考

产品版本
Hadoop3.1.3
Flume1.9.0
Kafka2.4.1
Hive3.1.2
Sqoop1.4.6
Java1.8
Zookeeper3.5.7
Presto0.189

2.2.4 服务器选型

服务器选择物理机还是云主机?

1)物理机:

以128G内存,20核物理CPU,40线程,戴尔品牌单台报价4W出头,一般物理机寿命5年左右。

需要有专业的运维任意,平均一个月1万。电费也是不少的开销。

2)云主机:

以阿里云为例,差不多配置,每年5W。运维工作都有阿里云完成,运维相对较轻松。

3)企业选择

金融有限公司和阿里没有直接冲突的公司选择阿里云。

中小公司,为了融资上市,选择阿里云,拉到融资后买物理机。

有长期打算,资金比较足,选择物理机。

2.2.5 集群资源规划设计

1)如何确认集群规模?(假设服务器8T磁盘,128G内存)

(1)每天日活跃用户100万,每人一天平均100条:100万*100条=1亿条

(2)每条日志1k左右,每天1亿条:100000000/1024/1024=约100G

(3)半年内不扩容服务器来算:100G*180天=约18T

(4)保留3副本:18T*3=54T

(5)保留20%-30%buf=54T/0.7=77T

(6)算到这里:约8T*10台服务器

2)测试集群服务器规划

服务名称子服务服务器 hadoop102服务器 hadoop103服务器 hadoop104
HDFSNameNode√
DataNode√√√
SecondaryNameNode√
YarnNodeManager√√√
Resourcemanager√
ZookeeperZookeeper Server√√√
Flume(采集日志)Flume√√
KafkaKafka√√√
Flume(消费Kafka)Flume√
HiveHive√
MySQLMySQL√
SqoopSqoop√
PrestoCoordinator√
Worker√√
AzkabanAzkabanWebServer√
AzkabanExecutorServer√
DruidDruid√√√
Kylin√
HbaseHMaster√
HRegionServer√√√
Superset√
Atlas√
SolrJar√
服务数总计1899

3 数据生成模块

3.1 目标数据

我们要收集和分析的数据主要包括页面数据、事件数据、曝光数据、启动数据和错误数据。

3.1.1 页面

页面数据主要记录一个页面的用户访问情况,包括访问时间、停留时间、页面路径等信息。

​

1)所有页面id如下

home("首页"),
category("分类页"),
discovery("发现页"),
top_n("热门排行"),
favor("收藏页"),
search("搜索页"),
good_list("商品列表页"),
good_detail("商品详情"),
good_spec("商品规格"),
comment("评价"),
comment_done("评价完成"),
comment_list("评价列表"),
cart("购物车"),
trade("下单结算"),
payment("支付页面"),
payment_done("支付完成"),
orders_all("全部订单"),
orders_unpaid("订单待支付"),
orders_undelivered("订单待发货"),
orders_unreceipted("订单待收货"),
orders_wait_comment("订单待评价"),
mine("我的"),
activity("活动"),
login("登录"),
register("注册");

2)所有页面对象类型如下:

sku_id("商品skuId"),
keyword("搜索关键词"),
sku_ids("多个商品skuId"),
activity_id("活动id"),
coupon_id("购物券id");

3)所有来源类型如下:

promotion("商品推广"),
recommend("算法推荐商品"),
query("查询结果商品"),
activity("促销活动");

3.1.2 事件

事件数据主要记录应用内一个具体操作行为,包括操作类型、操作对象、操作对象描述等信息。

1)所有动作类型如下:

favor_add("添加收藏"),
favor_canel("取消收藏"),
cart_add("添加购物车"),
cart_remove("删除购物车"),
cart_add_num("增加购物车商品数量"),
cart_minus_num("减少购物车商品数量"),
trade_add_address("增加收货地址"),
get_coupon("领取优惠券");

注:对于下单、支付等业务数据,可从业务数据库获取。

2)所有动作目标类型如下:

sku_id(“商品”),
coupon_id(“购物券”);

3.1.3 曝光

曝光数据主要记录页面所曝光的内容,包括曝光对象,曝光类型等信息。

1)所有曝光类型如下:

promotion("商品推广"),
recommend("算法推荐商品"),
query("查询结果商品"),
activity("促销活动");

2)所有曝光对象类型如下:

sku_id("商品skuId"),
activity_id("活动id");

3.1.4 启动

启动数据记录应用的启动信息。

1)所有启动入口类型如下:

icon("图标"),
notification("通知"),
install("安装后启动");

3.1.5 错误

错误数据记录应用使用过程中的错误信息,包括错误编号及错误信息。

3.2 数据埋点

3.2.1 主流埋点方式(了解)

目前主流的埋点方式,有代码埋点(前端/后端)、可视化埋点、全埋点三种。

代码埋点是通过调用埋点SDK函数,在需要埋点的业务逻辑功能位置调用接口,上报埋点数据。例如,我们对页面中的某个按钮埋点后,当这个按钮被点击时,可以在这个按钮对应的 OnClick 函数里面调用SDK提供的数据发送接口,来发送数据。

可视化埋点只需要研发人员集成采集 SDK,不需要写埋点代码,业务人员就可以通过访问分析平台的“圈选”功能,来“圈”出需要对用户行为进行捕捉的控件,并对该事件进行命名。圈选完毕后,这些配置会同步到各个用户的终端上,由采集 SDK 按照圈选的配置自动进行用户行为数据的采集和发送。(三方埋点技术:神策大数据,GrowingIO)

全埋点是通过在产品中嵌入SDK,前端自动采集页面上的全部用户行为事件,上报埋点数据,相当于做了一个统一的埋点。然后再通过界面配置哪些数据需要在系统里面进行分析。

3.2.2 埋点数据日志结构

我们的日志结构大致可分为两类,一是普通页面埋点日志,二是启动日志。

普通页面日志结构如下,每条日志包含了,当前页面的页面信息,所有事件(动作)、所有曝光信息以及错误信息。除此之外,还包含了一系列公共信息,包括设备信息,地理位置,应用信息等,即下边的common字段。

1)普通页面埋点日志格式

&#123;
  "common": &#123;                  -- 公共信息
    "ar": "230000",              -- 地区编码
    "ba": "iPhone",              -- 手机品牌
    "ch": "Appstore",            -- 渠道
    "is_new": "1",--是否首日使用,首次使用的当日,该字段值为1,过了24:00,该字段置为0。
    "md": "iPhone 8",            -- 手机型号
    "mid": "YXfhjAYH6As2z9Iq", -- 设备id
    "os": "iOS 13.2.9",          -- 操作系统
    "uid": "485",                 -- 会员id
    "vc": "v2.1.134"             -- app版本号
  &#125;,
"actions": [                     --动作(事件)  
    &#123;
      "action_id": "favor_add",   --动作id
      "item": "3",                   --目标id
      "item_type": "sku_id",       --目标类型
      "ts": 1585744376605           --动作时间戳
    &#125;
  ],
  "displays": [
    &#123;
      "displayType": "query",        -- 曝光类型
      "item": "3",                     -- 曝光对象id
      "item_type": "sku_id",         -- 曝光对象类型
      "order": 1,                      --出现顺序
      "pos_id": 2                      --曝光位置
    &#125;,
    &#123;
      "displayType": "promotion",
      "item": "6",
      "item_type": "sku_id",
      "order": 2, 
      "pos_id": 1
    &#125;,
    &#123;
      "displayType": "promotion",
      "item": "9",
      "item_type": "sku_id",
      "order": 3, 
      "pos_id": 3
    &#125;,
    &#123;
      "displayType": "recommend",
      "item": "6",
      "item_type": "sku_id",
      "order": 4, 
      "pos_id": 2
    &#125;,
    &#123;
      "displayType": "query ",
      "item": "6",
      "item_type": "sku_id",
      "order": 5, 
      "pos_id": 1
    &#125;
  ],
  "page": &#123;                       --页面信息
    "during_time": 7648,        -- 持续时间毫秒
    "item": "3",                  -- 目标id
    "item_type": "sku_id",      -- 目标类型
    "last_page_id": "login",    -- 上页类型
    "page_id": "good_detail",   -- 页面ID
    "sourceType": "promotion"   -- 来源类型
  &#125;,
"err":&#123;                     --错误
"error_code": "1234",      --错误码
    "msg": "***********"       --错误信息
&#125;,
  "ts": 1585744374423  --跳入时间戳
&#125;

2)启动日志格式

启动日志结构相对简单,主要包含公共信息,启动信息和错误信息。

&#123;
  "common": &#123;
    "ar": "370000",
    "ba": "Honor",
    "ch": "wandoujia",
    "is_new": "1",
    "md": "Honor 20s",
    "mid": "eQF5boERMJFOujcp",
    "os": "Android 11.0",
    "uid": "76",
    "vc": "v2.1.134"
  &#125;,
  "start": &#123;   
    "entry": "icon",         --icon手机图标  notice 通知   install 安装后启动
    "loading_time": 18803,  --启动加载时间
    "open_ad_id": 7,        --广告页ID
    "open_ad_ms": 3449,    -- 广告总共播放时间
    "open_ad_skip_ms": 1989   --  用户跳过广告时点
  &#125;,
"err":&#123;                     --错误
"error_code": "1234",      --错误码
    "msg": "***********"       --错误信息
&#125;,
  "ts": 1585744304000
&#125;

3.2.3 埋点数据上报时机

埋点数据上报时机包括两种方式。

方式一,在离开该页面时,上传在这个页面产生的所有数据(页面、事件、曝光、错误等)。优点,批处理,减少了服务器接收数据压力。缺点,不是特别及时。

方式二,每个事件、动作、错误等,产生后,立即发送。优点,响应及时。缺点,对服务器接收数据压力比较大。

3.3 服务器和JDK准备

3.3.1 服务器准备

安装hadoop集群,分别安装hadoop102、hadoop103、hadoop104三台主机。

3.3.2 阿里云服务器准备(可选)

3.3.3 JDK准备

1)卸载现有JDK(3台节点)

[molly@hadoop102 opt]# sudo rpm -qa | grep -i java | xargs -n1 sudo rpm -e --nodeps
[molly@hadoop103 opt]# sudo rpm -qa | grep -i java | xargs -n1 sudo rpm -e --nodeps
[molly@hadoop104 opt]# sudo rpm -qa | grep -i java | xargs -n1 sudo rpm -e --nodeps

2)用SecureCRT工具将JDK导入到hadoop102的/opt/software文件夹下面

3) “alt+p”进入sftp模式

4)选择jdk1.8拖入工具

5)在Linux系统下的opt目录中查看软件包是否导入成功

[molly@hadoop102 software]# ls /opt/software/

看到如下结果:

jdk-8u212-linux-x64.tar.gz

6)解压JDK到/opt/module目录下

[molly@hadoop102 software]# tar -zxvf jdk-8u212-linux-x64.tar.gz -C /opt/module/

7)配置JDK环境变量

​ (1)新建/etc/profile.d/my_env.sh文件

[molly@hadoop102 module]# sudo vim /etc/profile.d/my_env.sh

添加如下内容,然后保存(:wq)退出

#JAVA_HOME
export JAVA_HOME=/opt/module/jdk1.8.0_212
export PATH=$PATH:$JAVA_HOME/bin

​ (2)让环境变量生效

[molly@hadoop102 software]$ source /etc/profile.d/my_env.sh

8)测试JDK是否安装成功

[molly@hadoop102 module]# java -version
#如果能看到以下结果、则Java正常安装
java version "1.8.0_212"

9)分发JDK

[molly@hadoop102 module]$ xsync /opt/module/jdk1.8.0_212/

10)分发环境变量配置文件

[molly@hadoop102 module]$ sudo /home/molly/bin/xsync /etc/profile.d/my_env.sh

11)分别在hadoop103、hadoop104上执行source

[molly@hadoop103 module]$ source /etc/profile.d/my_env.sh
[molly@hadoop104 module]$ source /etc/profile.d/my_env.sh

3.3.4 环境变量配置说明

Linux的环境变量可在多个文件中配置,如/etc/profile,/etc/profile.d/*.sh,/.bashrc,/.bash_profile等,下面说明上述几个文件之间的关系和区别。

bash的运行模式可分为login shell和non-login shell。

例如,我们通过终端,输入用户名、密码,登录系统之后,得到就是一个login shell,而当我们执行以下命令ssh hadoop103 command,在hadoop103执行command的就是一个non-login shell。

这两种shell的主要区别在于,它们启动时会加载不同的配置文件,login shell启动时会加载/etc/profile,/.bash_profile,/.bashrc,non-login shell启动时会加载~/.bashrc。

而在加载/.bashrc(实际是/.bashrc中加载的/etc/bashrc)或/etc/profile时,都会执行如下代码片段,

​ 1637657318225

因此不管是login shell还是non-login shell,启动时都会加载/etc/profile.d/*.sh中的环境变量。

3.4 模拟数据

3.4.1 使用说明

1)将application.yml、gmall2020-mock-log-2021-01-22.jar、path.json、logback.xml上传到hadoop102的/opt/module/applog目录下

(1)创建applog路径

[molly@hadoop102 module]$ mkdir /opt/module/applog

(2)上传文件

2)配置文件

(1)application.yml文件

可以根据需求生成对应日期的用户行为日志。

[molly@hadoop102 applog]$ vim application.yml

修改如下内容

# 外部配置打开
# 外部配置打开
logging.config: "./logback.xml"
#业务日期
mock.date: "2020-06-14"

#模拟数据发送模式
#mock.type: "http"
#mock.type: "kafka"
mock.type: "log"

#http模式下,发送的地址
mock.url: "http://hdp1/applog"

#kafka模式下,发送的地址
mock:
  kafka-server: "hdp1:9092,hdp2:9092,hdp3:9092"
  kafka-topic: "ODS_BASE_LOG"

#启动次数
mock.startup.count: 200
#设备最大值
mock.max.mid: 500000
#会员最大值
mock.max.uid: 100
#商品最大值
mock.max.sku-id: 35
#页面平均访问时间
mock.page.during-time-ms: 20000
#错误概率 百分比
mock.error.rate: 3
#每条日志发送延迟 ms
mock.log.sleep: 10
#商品详情来源  用户查询,商品推广,智能推荐, 促销活动
mock.detail.source-type-rate: "40:25:15:20"
#领取购物券概率
mock.if_get_coupon_rate: 75
#购物券最大id
mock.max.coupon-id: 3
#搜索关键词  
mock.search.keyword: "图书,小米,iphone11,电视,口红,ps5,苹果手机,小米盒子"

(2)path.json,该文件用来配置访问路径

根据需求,可以灵活配置用户点击路径。

来到主页-搜索-上篇-下单-。。

[
  &#123;"path":["home","good_list","good_detail","cart","trade","payment"],"rate":20 &#125;,
  &#123;"path":["home","search","good_list","good_detail","login","good_detail","cart","trade","payment"],"rate":40 &#125;,
  &#123;"path":["home","mine","orders_unpaid","trade","payment"],"rate":10 &#125;,
  &#123;"path":["home","mine","orders_unpaid","good_detail","good_spec","comment","trade","payment"],"rate":5 &#125;,
  &#123;"path":["home","mine","orders_unpaid","good_detail","good_spec","comment","home"],"rate":5 &#125;,
  &#123;"path":["home","good_detail"],"rate":10 &#125;,
  &#123;"path":["home"  ],"rate":10 &#125;
]

(3)logback配置文件

可配置日志生成路径,修改内容如下

<?xml version="1.0" encoding="UTF-8"?>
<configuration>
    <property name="LOG_HOME" value="/opt/module/applog/log" />
    <appender name="console" class="ch.qos.logback.core.ConsoleAppender">
        <encoder>
            <pattern>%msg%n</pattern>
        </encoder>
    </appender>

    <appender name="rollingFile" class="ch.qos.logback.core.rolling.RollingFileAppender">
        <rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy">
            <fileNamePattern>$&#123;LOG_HOME&#125;/app.%d&#123;yyyy-MM-dd&#125;.log</fileNamePattern>
        </rollingPolicy>
        <encoder>
            <pattern>%msg%n</pattern>
        </encoder>
    </appender>

    <!-- 将某一个包下日志单独打印日志 -->
    <logger name="com.atgugu.gmall2020.mock.log.util.LogUtil"
            level="INFO" additivity="false">
        <appender-ref ref="rollingFile" />
        <appender-ref ref="console" />
    </logger>

    <root level="error"  >
        <appender-ref ref="console" />
    </root>
</configuration>

3)生成日志

(1)进入到/opt/module/applog路径,执行以下命令

[molly@hadoop102 applog]$ java -jar gmall2020-mock-log-2021-01-22.jar

(2)在/opt/module/applog/log目录下查看生成日志

[molly@hadoop102 log]$ ll

3.4.2 集群日志生成脚本

在生成日志的时候模拟多台服务器生产的日志。在hadoop102的/home/molly目录下创建bin目录,这样脚本可以在服务器的任何目录执行。

[molly@hadoop102 ~]$ echo $PATH
/usr/local/bin:/usr/bin:/usr/local/sbin:/usr/sbin:/home/molly/.local/bin:/home/molly/bin

​ 1)在/home/molly/bin目录下创建脚本lg.sh

[molly@hadoop102 bin]$ vim lg.sh

​ 2)在脚本中编写如下内容

#!/bin/bash
for i in hadoop102 hadoop103; do
    echo "========== $i =========="
    ssh $i "cd /opt/module/applog/; java -jar gmall2020-mock-log-2021-01-22.jar >/dev/null 2>&1 &"
done 

注:

(1)/opt/module/applog/为jar包及配置文件所在路径

(2)/dev/null代表linux的空设备文件,所有往这个文件里面写入的内容都会丢失,俗称“黑洞”。

标准输入0:从键盘获得输入 /proc/self/fd/0

标准输出1:输出到屏幕(即控制台) /proc/self/fd/1

错误输出2:输出到屏幕(即控制台) /proc/self/fd/2

3)修改脚本执行权限

[molly@hadoop102 bin]$ chmod u+x lg.sh

4)将jar包及配置文件s上传至hadoop103的/opt/module/applog/路径

5)启动脚本

[molly@hadoop102 module]$ lg.sh 

6)分别在hadoop102、hadoop103的/opt/module/applog/log目录上查看生成的数据

[molly@hadoop102 logs]$ ls
app.2020-06-14.log
[molly@hadoop103 logs]$ ls
app.2020-06-14.log

4 数据采集模块

4.1 集群所有进程查看脚本

1)在/home/molly/bin目录下创建脚本xcall.sh

[molly@hadoop102 bin]$ vim xcall.sh

2)在脚本中编写如下内容

#! /bin/bash

for i in hadoop102 hadoop103 hadoop104
do
    echo --------- $i ----------
    ssh $i "$*"
done

3)修改脚本执行权限

[molly@hadoop102 bin]$ chmod 777 xcall.sh

4)启动脚本

[molly@hadoop102 bin]$ xcall.sh jps

4.2 Hadoop安装

详见:Hadoop 教程(二)安装hadoop集群-完全分布式部署

1)集群规划:

服务器hadoop102服务器hadoop103服务器hadoop104
HDFSNameNode DataNodeDataNodeDataNode SecondaryNameNode
YarnNodeManagerResourcemanager NodeManagerNodeManager

注意:尽量使用离线方式安装。第一次启动需要格式化namenode.

[molly@hadoop102 bin]hdfs namenode -format

4.2.1 项目经验之HDFS存储多目录

datanode和namenode都可以多目录存储。namenode不同目录的数据都是一样的,所以这里我们不配namenode的多目录。但是datanode的多目录中每个目录存储的数据是不一样的,可以多目录(磁盘挂载到的对应目录。因此用不同磁盘来存储Datanode,实现方式就是:datanode配置多目录)

1)生产环境服务器磁盘情况

从当前服务器可以看到:4个磁盘挂载在不同的目录。

1637661734977

2)在hdfs-site.xml文件中配置多目录,注意新挂载磁盘的访问权限问题。

HDFS的DataNode节点保存数据的路径由dfs.datanode.data.dir参数决定,其默认值为file://${hadoop.tmp.dir}/dfs/data,若服务器有多个磁盘,必须对该参数进行修改。如服务器磁盘如上图所示,则该参数应修改为如下的值。

<property>
  <name>dfs.datanode.data.dir</name>
<value>file:///dfs/data1,file:///hd2/dfs/data2,file:///hd3/dfs/data3,file:///hd4/dfs/data4</value>
</property>

注意:每台服务器挂载的磁盘不一样,所以每个节点的多目录配置可以不一致。单独配置即可。

4.2.2 集群数据均衡

1)节点间数据均衡:就是102 103 104之间的

下面由于人工操作会导致三台节点的存储数据不均衡,如下图所示:1637662122810

解决办法:开启数据均衡命令:

start-balancer.sh -threshold 10

对于参数10,代表的是集群中各个节点的磁盘空间利用率相差不超过10%,可根据实际情况进行调整。

停止数据均衡命令:

stop-balancer.sh

2)磁盘间数据均衡

hadoop3.x的新特性:针对磁盘间的数据均衡

(1)生成均衡计划(我们只有一块磁盘,不会生成计划)

hdfs diskbalancer -plan hadoop103

(2)执行均衡计划

hdfs diskbalancer -execute hadoop103.plan.json

(3)查看当前均衡任务的执行情况

hdfs diskbalancer -query hadoop103

(4)取消均衡任务

hdfs diskbalancer -cancel hadoop103.plan.json

4.2.3 项目经验之支持LZO压缩配置

1)hadoop本身并不支持lzo压缩,故需要使用twitter提供的hadoop-lzo开源组件。hadoop-lzo需依赖hadoop和lzo进行编译。

2)将编译好后的hadoop-lzo-0.4.20.jar 放入hadoop-3.1.3/share/hadoop/common/

[molly@hadoop102 common]$ pwd
/opt/module/hadoop-3.1.3/share/hadoop/common
[molly@hadoop102 common]$ ls
hadoop-lzo-0.4.20.jar

3)同步hadoop-lzo-0.4.20.jar到hadoop103、hadoop104

[molly@hadoop102 common]$ xsync hadoop-lzo-0.4.20.jar

4)core-site.xml增加配置支持LZO压缩

<configuration>
  <property>
​    <name>io.compression.codecs</name>
​    <value>
​      org.apache.hadoop.io.compress.GzipCodec,
​      org.apache.hadoop.io.compress.DefaultCodec,
​      org.apache.hadoop.io.compress.BZip2Codec,
​      org.apache.hadoop.io.compress.SnappyCodec,
​      com.hadoop.compression.lzo.LzoCodec,
​      com.hadoop.compression.lzo.LzopCodec
​    </value>
  </property>
  <property>
​    <name>io.compression.codec.lzo.class</name>
​    <value>com.hadoop.compression.lzo.LzoCodec</value>
  </property>
</configuration>

5)同步core-site.xml到hadoop103、hadoop104

[molly@hadoop102 hadoop]$ xsync core-site.xml

6)启动及查看集群

[molly@hadoop102 hadoop-3.1.3]$ sbin/start-dfs.sh
[molly@hadoop103 hadoop-3.1.3]$ sbin/start-yarn.sh

4.2.4 测试LZO

(1)执行wordcount程序

[molly@hadoop102 module]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar wordcount -Dmapreduce.job.inputformat.class=com.hadoop.mapreduce.LzoTextInputFormat /input /lzo-output

​ 1637662603236

4.2.4 项目经验之LZO创建索引

1)创建LZO文件的索引,LZO压缩文件的可切片特性依赖于其索引,故我们需要手动为LZO压缩文件创建索引。若无索引,则LZO文件的切片只有一个。

hadoop jar /path/to/your/hadoop-lzo.jar com.hadoop.compression.lzo.DistributedLzoIndexer big_file.lzo

2)测试

​ (1)将bigtable.lzo(200M)上传到集群的根目录

[molly@hadoop102 module]$ hadoop fs -mkdir /input
[molly@hadoop102 module]$ hadoop fs -put bigtable.lzo /input

​ 1637662802344

(2)执行wordcount程序

[molly@hadoop102 module]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar wordcount -Dmapreduce.job.inputformat.class=com.hadoop.mapreduce.LzoTextInputFormat /input /output1

允许发现切片只有一个,因此想起原理,Lzo切片是依赖于索引的,因此我们需要建索引

(3)对上传的LZO文件建索引

[molly@hadoop102 module]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/common/hadoop-lzo-0.4.20.jar com.hadoop.compression.lzo.DistributedLzoIndexer /input/bigtable.lzo

1637662962636

(4)再次执行WordCount程序

这里注意需要指定inputformat类为LzoText对应的类com.hadoop.mapreduce.LzoTextInputFormat

[molly@hadoop102 module]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar wordcount -Dmapreduce.job.inputformat.class=com.hadoop.mapreduce.LzoTextInputFormat /input /output2

发现切片数为2。查看历史服务器去查看具体切片信息。1637662988690

map执行过程中切片信息。1637663231181

3)注意:如果以上任务,在运行过程中报如下异常

Container [pid=8468,containerID=container_1594198338753_0001_01_000002] is running 318740992B beyond the 'VIRTUAL' memory limit. Current usage: 111.5 MB of 1 GB physical memory used; 2.4 GB of 2.1 GB virtual memory used. Killing container.
Dump of the process-tree for container_1594198338753_0001_01_000002 :

解决办法:在hadoop102的/opt/module/hadoop-3.1.3/etc/hadoop/yarn-site.xml文件中增加如下配置,然后分发到hadoop103、hadoop104服务器上,并重新启动集群。

<!--是否启动一个线程检查每个任务正使用的物理内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->
<property>
  <name>yarn.nodemanager.pmem-check-enabled</name>
  <value>false</value>
</property>
<!--是否启动一个线程检查每个任务正使用的虚拟内存量,如果任务超出分配值,则直接将其杀掉,默认是true -->
<property>
  <name>yarn.nodemanager.vmem-check-enabled</name>
  <value>false</value>
</property>

4.2.5 项目经验之基准测试

1) 测试HDFS写性能

​ 测试内容:向HDFS集群写10个128M的文件

[molly@hadoop102 mapreduce]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-3.1.3-tests.jar TestDFSIO -write -nrFiles 6 -fileSize 128MB

2020-04-16 13:41:24,724 INFO fs.TestDFSIO: ----- TestDFSIO ----- : write
2020-04-16 13:41:24,724 INFO fs.TestDFSIO:       Date & time: Thu Apr 16 13:41:24 CST 2020
2020-04-16 13:41:24,724 INFO fs.TestDFSIO:     Number of files: 10
2020-04-16 13:41:24,725 INFO fs.TestDFSIO: Total MBytes processed: 1280
2020-04-16 13:41:24,725 INFO fs.TestDFSIO:    Throughput mb/sec: 8.88
2020-04-16 13:41:24,725 INFO fs.TestDFSIO: Average IO rate mb/sec: 8.96
2020-04-16 13:41:24,725 INFO fs.TestDFSIO:  IO rate std deviation: 0.87
2020-04-16 13:41:24,725 INFO fs.TestDFSIO:   Test exec time sec: 67.61

2)测试HDFS读性能

测试内容:读取HDFS集群10个128M的文件

[molly@hadoop102 mapreduce]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-3.1.3-tests.jar TestDFSIO -read -nrFiles 10 -fileSize 128MB
2020-04-16 13:43:38,857 INFO fs.TestDFSIO: ----- TestDFSIO ----- : read
2020-04-16 13:43:38,858 INFO fs.TestDFSIO:   Date & time: Thu Apr 16 13:43:38 CST 2020
2020-04-16 13:43:38,859 INFO fs.TestDFSIO:         Number of files: 10
2020-04-16 13:43:38,859 INFO fs.TestDFSIO:  Total MBytes processed: 1280
2020-04-16 13:43:38,859 INFO fs.TestDFSIO:       Throughput mb/sec: 85.54
2020-04-16 13:43:38,860 INFO fs.TestDFSIO:  Average IO rate mb/sec: 100.21
2020-04-16 13:43:38,860 INFO fs.TestDFSIO:   IO rate std deviation: 44.37
2020-04-16 13:43:38,860 INFO fs.TestDFSIO:      Test exec time sec: 53.61

3)删除测试生成数据

[molly@hadoop102 mapreduce]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-3.1.3-tests.jar TestDFSIO -clean

4)使用Sort程序评测MapReduce(要求性能特别好,普通性能不要去跑)

(1)使用RandomWriter来产生随机数,每个节点运行10个Map任务,每个Map产生大约1G大小的二进制随机数

[molly@hadoop102 mapreduce]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar randomwriter random-data

(2)执行Sort程序

[molly@hadoop102 mapreduce]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.1.3.jar sort random-data sorted-data

(3)验证数据是否真正排好序了

[molly@hadoop102 mapreduce]$ hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/mapreduce/hadoop-mapreduce-client-jobclient-3.1.3-tests.jar testmapredsort -sortInput random-data -sortOutput sorted-data

4.2.6 项目经验之Hadoop参数调优

1)HDFS参数调优hdfs-site.xml

NameNode有一个工作线程池,用来处理不同DataNode的并发心跳以及客户端并发的元数据操作。

对于大集群或者有大量客户端的集群来说,通常需要增大参数dfs.namenode.handler.count的默认值10。

<property>
  <name>dfs.namenode.handler.count</name>
  <value>10</value>
</property>

dfs.namenode.handler.count=1637663793390 ,比如集群规模为8台时,此参数设置为41。
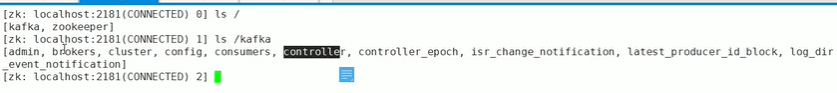
2)YARN参数调优yarn-site.xml

(1)情景描述:总共7台机器,每天几亿条数据,数据源->Flume->Kafka->HDFS->Hive

面临问题:数据统计主要用HiveSQL,没有数据倾斜,小文件已经做了合并处理,开启的JVM重用,而且IO没有阻塞,内存用了不到50%。但是还是跑的非常慢,而且数据量洪峰过来时,整个集群都会宕掉。基于这种情况有没有优化方案。

(2)解决办法:

内存利用率不够。这个一般是Yarn的2个配置造成的,单个任务可以申请的最大内存大小,和Hadoop单个节点可用内存大小。调节这两个参数能提高系统内存的利用率。

(a)yarn.nodemanager.resource.memory-mb

表示该节点上YARN可使用的物理内存总量,默认是8192(MB),注意,如果你的节点内存资源不够8GB,则需要调减小这个值,而YARN不会智能的探测节点的物理内存总量。

(b)yarn.scheduler.maximum-allocation-mb

单个任务可申请的最多物理内存量,默认是8192(MB)。

4.3 Zookeeper安装

4.3.1 安装ZK

详见:

集群规划

服务器hadoop102服务器hadoop103服务器hadoop104
ZookeeperZookeeperZookeeperZookeeper

4.3.2 ZK集群启动停止脚本

1)在hadoop102的/home/molly/bin目录下创建脚本

[molly@hadoop102 bin]$ vim zk.sh

#在脚本中编写如下内容

#!/bin/bash

case $1 in
"start"){
    for i in hadoop102 hadoop103 hadoop104
    do
        echo ---------- zookeeper $i 启动 ------------
        ssh $i "/opt/module/zookeeper-3.5.7/bin/zkServer.sh start"
    done
};;
"stop"){
    for i in hadoop102 hadoop103 hadoop104
    do
        echo ---------- zookeeper $i 停止 ------------    
        ssh $i "/opt/module/zookeeper-3.5.7/bin/zkServer.sh stop"
    done
};;
"status"){
    for i in hadoop102 hadoop103 hadoop104
    do
        echo ---------- zookeeper $i 状态 ------------    
        ssh $i "/opt/module/zookeeper-3.5.7/bin/zkServer.sh status"
    done
};;
esac

2)增加脚本执行权限

[molly@hadoop102 bin]$ chmod u+x zk.sh

3)Zookeeper集群启动脚本

[molly@hadoop102 module]$ zk.sh start

4)Zookeeper集群停止脚本

[molly@hadoop102 module]$ zk.sh stop

4.4 Kafka安装

4.4.1 Kafka集群安装

详见:kafka学习笔记(一) kafka搭建

配置文件:

log.dirs=/opt/moudule/kafka 2.11-2.4.1/datas
zookeeper.connect=hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka

集群规划:

服务器hadoop102服务器hadoop103服务器hadoop104
KafkaKafkaKafkaKafka

4.4.2 Kafka集群启动停止脚本

1)在/home/molly/bin目录下创建脚本kf.sh

[molly@hadoop102 bin]$ vim kf.sh

在脚本中填写如下内容

#! /bin/bash

case $1 in
"start"){
    for i in hadoop102 hadoop103 hadoop104
    do
        echo " --------启动 $i Kafka-------"
        ssh $i "/opt/module/kafka/bin/kafka-server-start.sh -daemon /opt/module/kafka/config/server.properties"
    done
};;
"stop"){
    for i in hadoop102 hadoop103 hadoop104
    do
        echo " --------停止 $i Kafka-------"
        ssh $i "/opt/module/kafka/bin/kafka-server-stop.sh stop"
    done
};;
esac

2)增加脚本执行权限

[molly@hadoop102 bin]$ chmod u+x kf.sh

3)kf集群启动脚本

[molly@hadoop102 module]$ kf.sh start

查看zookeeper信息1637664623705

4)kf集群停止脚本

[molly@hadoop102 module]$ kf.sh stop

4.4.3 Kafka常用命令

1)查看Kafka Topic列表

[molly@hadoop102 kafka]$ bin/kafka-topics.sh --zookeeper hadoop102:2181/kafka --list
[molly@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server hadoop102:9092 --list
[molly@hadoop102 kafka]$ bin/kafka-topics.sh --bootstrap-server hadoop102:9092 --describe

2)创建Kafka Topic

进入到/opt/module/kafka/目录下创建日志主题

[molly@hadoop102 kafka]$ bin/kafka-topics.sh --zookeeper hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka --create --replication-factor 1 --partitions 1 --topic topic_log

3)删除Kafka Topic

[molly@hadoop102 kafka]$ bin/kafka-topics.sh --delete --zookeeper hadoop102:2181,hadoop103:2181,hadoop104:2181/kafka --topic topic_log

4)Kafka生产消息

[molly@hadoop102 kafka]$ bin/kafka-console-producer.sh \
--broker-list hadoop102:9092 --topic topic_log
\>hello world
\>molly molly

5)Kafka消费消息

[molly@hadoop102 kafka]$ bin/kafka-console-consumer.sh \
--bootstrap-server hadoop102:9092 --from-beginning --topic topic_log

–from-beginning:会把主题中以往所有的数据都读取出来。根据业务场景选择是否增加该配置。

6)查看Kafka Topic详情

[molly@hadoop102 kafka]$ bin/kafka-topics.sh --zookeeper hadoop102:2181/kafka \
--describe --topic topic_log

4.4.4 项目经验之Kafka压力测试

1)Kafka压测

用Kafka官方自带的脚本,对Kafka进行压测。Kafka压测时,可以查看到哪个地方出现了瓶颈(CPU,内存,网络IO)。一般都是网络IO达到瓶颈。

kafka-consumer-perf-test.sh
kafka-producer-perf-test.sh

2)Kafka Producer压力测试

(1)在/opt/module/kafka/bin目录下面有这两个文件。我们来测试一下

[molly@hadoop102 kafka]$ bin/kafka-producer-perf-test.sh --topic test --record-size 100 --num-records 100000 --throughput -1 --producer-props bootstrap.servers=hadoop102:9092,hadoop103:9092,hadoop104:9092

说明:

record-size是一条信息有多大,单位是字节。
num-records是总共发送多少条信息。
throughput 是每秒多少条信息,设成-1,表示不限流,可测出生产者最大吞吐量。

(2)Kafka会打印下面的信息

100000 records sent, 95877.277085 records/sec (9.14 MB/sec), 187.68 ms avg latency, 424.00 ms max latency, 155 ms 50th, 411 ms 95th, 423 ms 99th, 424 ms 99.9th.

参数解析:本例中一共写入10w条消息,吞吐量为9.14 MB/sec,每次写入的平均延迟为187.68毫秒,最大的延迟为424.00毫秒。

3)Kafka Consumer压力测试

Consumer的测试,如果这四个指标(IO,CPU,内存,网络)都不能改变,考虑增加分区数来提升性能。

[molly@hadoop102 kafka]$ bin/kafka-consumer-perf-test.sh --broker-list hadoop102:9092,hadoop103:9092,hadoop104:9092 --topic test --fetch-size 10000 --messages 10000000 --threads 1

参数说明:

–zookeeper 指定zookeeper的链接信息
–topic 指定topic的名称
–fetch-size 指定每次fetch的数据的大小
–messages 总共要消费的消息个数

测试结果说明:

start.time, end.time, data.consumed.in.MB, MB.sec, data.consumed.in.nMsg, nMsg.sec
2019-02-19 20:29:07:566, 2019-02-19 20:29:12:170, 9.5368, 2.0714, 100010, 21722.4153

开始测试时间,测试结束数据,共消费数据9.5368MB,吞吐量2.0714MB/s,共消费100010条,平均每秒消费21722.4153条。

4.4.5 项目经验之Kafka机器数量计算

Kafka机器数量(经验公式)=2x(峰值生产速度x副本数/100)+1
先拿到峰值生产速度,再根据设定的副本数,就能预估出需要部署Kafka的数量。
比如我们的峰值生产速度是50M/s。副本数为2。
Kafka机器数量=2(502/100)+ 1=3台

4.4.6 项目经验值Kafka分区数计算

1)创建一个只有1个分区的topic

2)测试这个topic的producer吞吐量和consumer吞吐量。

3)假设他们的值分别是Tp和Tc,单位可以是MB/s。

4)然后假设总的目标吞吐量是Tt,那么分区数=Tt / min(Tp,Tc)

例如:producer吞吐量=20m/s;consumer吞吐量=50m/s,期望吞吐量100m/s;

分区数=100 / 20 =5分区

https://blog.csdn.net/weixin_42641909/article/details/89294698

分区数一般设置为:3-10个

5 项目1 采集用户行为数据

如下图所示,用户行为经过埋点进行收集然后存放到logserver上,这个时候利用Flume(第一层)从日志服务器logserver上采集数据送到kafka中,再通过一个flume(第二层)接收,最后存储到HDFS中。

再看flume架构:

第一层flume,我们source选择为taildirSource,channel选Kafka Channel(这里不需要sink,因为KafkaChanel直接将数据存到Kafka中了)。

第二层flume:我们source选择为KafkaSource,channel选fileChannel,sink选择HDFS Sink。

其中flume安装详见:flume学习笔记(一) flume搭建

1637724868076

日志采集Flume集群规划:

我们将第一层flume安装在hadoop102和hadoop103上,第二层flume安装在hadoop104.

服务器hadoop102服务器hadoop103服务器hadoop104
Flume(采集日志)(第一层)Flume(第一层) Flume(第二层 Flum

5.1 第一层flume采集

5.1.1 项目经验之Flume组件选型

1637722930078

Flume直接读log日志的数据,log日志的格式是app.yyyy-mm-dd.log。注意其中logInterceptor主要对原始日志进行初步数据处理,删除空数据。

1)Source

(1)Taildir Source相比Exec Source、Spooling Directory Source的优势

TailDir Source:断点续传、多目录。Flume1.6以前需要自己自定义Source记录每次读取文件位置,实现断点续传。

Exec Source可以实时搜集数据,但是在Flume不运行或者Shell命令出错的情况下,数据将会丢失。

Spooling Directory Source监控目录,支持断点续传。

(2)batchSize大小如何设置?

+答:Event 1K左右时,500-1000合适(默认为100)

2)Channel

采用Kafka Channel,省去了Sink,提高了效率。KafkaChannel数据存储在Kafka里面,所以数据是存储在磁盘中。

注意在Flume1.7以前,Kafka Channel很少有人使用,因为发现parseAsFlumeEvent这个配置起不了作用。也就是无论parseAsFlumeEvent配置为true还是false,都会转为Flume Event。这样的话,造成的结果是,会始终都把Flume的headers中的信息混合着内容一起写入Kafka的消息中,这显然不是我所需要的,我只是需要把内容写入即可。

5.1.2 日志采集Flume配置

1)Flume的具体配置如下:

​ (1)在/opt/module/flume/conf目录下创建file-flume-kafka.conf文件

[molly@hadoop102 conf]$ vim file-flume-kafka.conf

在文件配置如下内容

#为各组件命名
a1.sources = r1
a1.channels = c1

#描述source
a1.sources.r1.type = TAILDIR
a1.sources.r1.filegroups = f1
a1.sources.r1.filegroups.f1 = /opt/module/applog/log/app.*
a1.sources.r1.positionFile = /opt/module/flume/taildir_position.json
a1.sources.r1.interceptors =  i1
a1.sources.r1.interceptors.i1.type = com.molly.flume.interceptor.ETLInterceptor$Builder
#描述channel
a1.channels.c1.type = org.apache.flume.channel.kafka.KafkaChannel
a1.channels.c1.kafka.bootstrap.servers = hadoop102:9092,hadoop103:9092
a1.channels.c1.kafka.topic = topic_log
a1.channels.c1.parseAsFlumeEvent = false
#绑定source和channel以及sink和channel的关系
a1.sources.r1.channels = c1

注意:com.molly.flume.interceptor.ETLInterceptor是自定义的拦截器的全类名。需要根据用户自定义的拦截器做相应修改。

5.1.3 Flume拦截器

在第一层flume中对原始数据进行清洗

1)创建Maven工程flume-interceptor

2)创建包名:com.molly.flume.interceptor

3)在pom.xml文件中添加如下配置

maven-compiler-plugin是打包插件。com.alibaba注意加compile,把该组件打到包中。

<dependencies>
    <dependency>
        <groupId>org.apache.flume</groupId>
        <artifactId>flume-ng-core</artifactId>
        <version>1.9.0</version>
        <scope>provided</scope>
    </dependency>

    <dependency>
        <groupId>com.alibaba</groupId>
        <artifactId>fastjson</artifactId>
        <version>1.2.62</version>
        <scope>compile</scope>
    </dependency>
</dependencies>

<build>
    <plugins>
        <plugin>
            <artifactId>maven-compiler-plugin</artifactId>
            <version>2.3.2</version>
            <configuration>
                <source>1.8</source>
                <target>1.8</target>
            </configuration>
        </plugin>
        <plugin>
            <artifactId>maven-assembly-plugin</artifactId>
            <configuration>
                <descriptorRefs>
                    <descriptorRef>jar-with-dependencies</descriptorRef>
                </descriptorRefs>
            </configuration>
            <executions>
                <execution>
                    <id>make-assembly</id>
                    <phase>package</phase>
                    <goals>
                        <goal>single</goal>
                    </goals>
                </execution>
            </executions>
        </plugin>
    </plugins>
</build>

4)在com.molly.flume.interceptor包下创建JSONUtils类

package com.molly.flume.interceptor;
import com.alibaba.fastjson.JSON;
import com.alibaba.fastjson.JSONException;
public class JSONUtils &#123;
    public static boolean isJSONValidate(String log)&#123;
        try &#123;
            JSON.parse(log);
            return true;
        &#125;catch (JSONException e)&#123;
            return false;
        &#125;
    &#125;
&#125;

5)在com.molly.flume.interceptor包下创建LogInterceptor类

package com.molly.flume.interceptor;
import com.alibaba.fastjson.JSON;
import org.apache.flume.Context;
import org.apache.flume.Event;
import org.apache.flume.interceptor.Interceptor;
import java.nio.charset.StandardCharsets;
import java.util.Iterator;
import java.util.List;
public class ETLInterceptor implements Interceptor &#123;
    @Override
    public void initialize() &#123;
    &#125;
    @Override
    public Event intercept(Event event) &#123;
        byte[] body = event.getBody();
        String log = new String(body, StandardCharsets.UTF_8);
        if (JSONUtils.isJSONValidate(log)) &#123;
            return event;
        &#125; else &#123;
            return null;
        &#125;
    &#125;
    @Override
    public List<Event> intercept(List<Event> list) &#123;
        Iterator<Event> iterator = list.iterator();
        while (iterator.hasNext())&#123;
            Event next = iterator.next();
            if(intercept(next)==null)&#123;
                iterator.remove();
            &#125;
        &#125;
        return list;
    &#125;
    public static class Builder implements Interceptor.Builder&#123;
        @Override
        public Interceptor build() &#123;
            return new ETLInterceptor();
        &#125;
        @Override
        public void configure(Context context) &#123;
       &#125;
    &#125;
    @Override
    public void close() &#123;
    &#125;
&#125;

6)打包

​ 1637725114820

7)需要先将打好的包放入到hadoop102的/opt/module/flume/lib文件夹下面。

[molly@hadoop102 lib]$ ls | grep interceptor
flume-interceptor-1.0-SNAPSHOT-jar-with-dependencies.jar

8)分发Flume到hadoop103、hadoop104

[molly@hadoop102 module]$ xsync flume/

9)hadoop102消费Flume数据

为了查看第一次flume是否起作用,我们开启一个kafka消费端来消费kafkaChannel中的数据。

[molly@hadoop102~]kafka-console-consumer.sh --topic topic_log --bootstrap-server hadoop102:9092

10)分别在hadoop102、hadoop103上启动Flume

[molly@hadoop102 flume]$ bin/flume-ng agent --name a1 --conf-file conf/file-flume-kafka.conf &
[molly@hadoop103 flume]$ bin/flume-ng agent --name a1 --conf-file conf/file-flume-kafka.conf &
[molly@hadoop102 flume]$ bin/flume-ng agent --name a1 --conf-file conf/file-flume-kafka.conf  -n a1 -Dflume.root.logger=INFO,console

11)观看9)中的kafka消费端有数据在消费。

5.1.4 日志采集Flume启动停止脚本

1)在/home/molly/bin目录下创建脚本f1.sh

[molly@hadoop102 bin]$ vim f1.sh

​ 在脚本中填写如下内容

#! /bin/bash

case $1 in
"start"){
        for i in hadoop102 hadoop103
        do
                echo " --------启动 $i 采集flume-------"
                ssh $i "nohup /opt/module/flume/bin/flume-ng agent --conf-file /opt/module/flume/conf/file-flume-kafka.conf --name a1 -Dflume.root.logger=INFO,LOGFILE >/opt/module/flume/log1.txt 2>&1  &"
        done
};;    
"stop"){
        for i in hadoop102 hadoop103
        do
                echo " --------停止 $i 采集flume-------"
                ssh $i "ps -ef | grep file-flume-kafka | grep -v grep |awk  '{print \$2}' | xargs -n1 kill -9 "
        done

};;
esac

说明1:nohup,该命令可以在你退出帐户/关闭终端之后继续运行相应的进程。nohup就是不挂起的意思,不挂断地运行命令。

说明2:awk 默认分隔符为空格

说明3:xargs 表示取出前面命令运行的结果,作为后面命令的输入参数。

2)增加脚本执行权限

[molly@hadoop102 bin]$ chmod u+x f1.sh

3)f1集群启动脚本

[molly@hadoop102 module]$ f1.sh start

4)f1集群停止脚本

[molly@hadoop102 module]$ f1.sh stop

集群规划

服务器hadoop102服务器hadoop103服务器hadoop104
Flume(消费Kafka)Flume

5.2 第二层flume采集

集群规划,第二层flume是消费Kafka数据的Flume,部署在hadoop104上。

服务器hadoop102服务器hadoop103服务器hadoop104
Flume(消费Kafka)Flume

5.2.1 项目经验之Flume组件选型

第二次Flume主要作用是消费Kafka中的数据,然后存储到HDFS中,因此Source选择KafkaSource,sink选择HDFSsink。同时在source端使用一个拦截器:拦截器作用是获取日志中的实际时间。

1637738855416

1)FileChannel和MemoryChannel区别

MemoryChannel传输数据速度更快,但因为数据保存在JVM的堆内存中,Agent进程挂掉会导致数据丢失,适用于对数据质量要求不高的需求。

FileChannel传输速度相对于Memory慢,但数据安全保障高,Agent进程挂掉也可以从失败中恢复数据。

选型:

金融类公司、对钱要求非常准确的公司通常会选择FileChannel

传输的是普通日志信息(京东内部一天丢100万-200万条,这是非常正常的),通常选择MemoryChannel。

2)FileChannel优化

通过配置dataDirs指向多个路径,每个路径对应不同的硬盘,增大Flume吞吐量。

官方说明如下:

checkpointDir和backupCheckpointDir也尽量配置在不同硬盘对应的目录中,保证checkpoint坏掉后,可以快速使用backupCheckpointDir恢复数据

3)Sink:HDFS Sink

(1)HDFS存入大量小文件,有什么影响?

元数据层面:每个小文件都有一份元数据,其中包括文件路径,文件名,所有者,所属组,权限,创建时间等,这些信息都保存在Namenode内存中。所以小文件过多,会占用Namenode服务器大量内存,影响Namenode性能和使用寿命

计算层面:默认情况下MR会对每个小文件启用一个Map任务计算,非常影响计算性能。同时也影响磁盘寻址时间。

(2)HDFS小文件处理

官方默认的这三个参数配置写入HDFS后会产生小文件,hdfs.rollInterval、hdfs.rollSize、hdfs.rollCount

基于以上hdfs.rollInterval=3600,hdfs.rollSize=134217728,hdfs.rollCount =0几个参数综合作用,效果如下:

(1)文件在达到128M时会滚动生成新文件

(2)文件创建超3600秒时会滚动生成新文件

5.2.2 Flume拦截器

由于flume默认会用linux系统时间,作为输出到HDFS路径的时间。如果数据是23:59分产生的。Flume消费kafka里面的数据时,有可能已经是第二天了,那么这部门数据会被发往第二天的HDFS路径。我们希望的是根据日志里面的实际时间,发往HDFS的路径,所以下面拦截器作用是获取日志中的实际时间。

1)在com.molly.flume.interceptor包下创建TimeStampInterceptor类

package com.molly.interceptor;

import com.alibaba.fastjson.JSONObject;
import org.apache.flume.Context;
import org.apache.flume.Event;
import org.apache.flume.interceptor.Interceptor;

import java.nio.charset.StandardCharsets;
import java.util.ArrayList;
import java.util.List;
import java.util.Map;

public class TimeStampInterceptor implements Interceptor &#123;

    private ArrayList<Event> events = new ArrayList<>();

    @Override
    public void initialize() &#123;

    &#125;

    @Override
    public Event intercept(Event event) &#123;

        Map<String, String> headers = event.getHeaders();
        String log = new String(event.getBody(), StandardCharsets.UTF_8);

        JSONObject jsonObject = JSONObject.parseObject(log);

        String ts = jsonObject.getString("ts");
        headers.put("timestamp", ts);

        return event;
    &#125;

    @Override
    public List<Event> intercept(List<Event> list) &#123;
        events.clear();
        for (Event event : list) &#123;
            events.add(intercept(event));
        &#125;

        return events;
    &#125;

    @Override
    public void close() &#123;

    &#125;

    public static class Builder implements Interceptor.Builder &#123;
        @Override
        public Interceptor build() &#123;
            return new TimeStampInterceptor();
        &#125;

        @Override
        public void configure(Context context) &#123;
        &#125;
    &#125;
&#125;

2)重新打包

​ 1637739135017

3)需要先将打好的包放入到hadoop102的/opt/module/flume/lib文件夹下面。

[molly@hadoop102 lib]$ ls | grep interceptor
flume-interceptor-1.0-SNAPSHOT-jar-with-dependencies.jar

4)分发Flume到hadoop103、hadoop104

[molly@hadoop102 module]$ xsync flume/

5.2.3 日志消费Flume配置

1)Flume的具体配置如下:

​ (1)在hadoop104的/opt/module/flume/conf目录下创建kafka-flume-hdfs.conf文件

[molly@hadoop104 conf]$ vim kafka-flume-hdfs.conf

在文件配置如下内容

## 组件
a1.sources=r1
a1.channels=c1
a1.sinks=k1

## source1
a1.sources.r1.type = org.apache.flume.source.kafka.KafkaSource
a1.sources.r1.batchSize = 5000
a1.sources.r1.batchDurationMillis = 2000
a1.sources.r1.kafka.bootstrap.servers = hadoop102:9092,hadoop103:9092,hadoop104:9092
a1.sources.r1.kafka.topics=topic_log
a1.sources.r1.interceptors = i1
a1.sources.r1.interceptors.i1.type = com.molly.flume.interceptor.TimeStampInterceptor$Builder

## channel1
a1.channels.c1.type = file
a1.channels.c1.checkpointDir = /opt/module/flume/checkpoint/behavior1
a1.channels.c1.dataDirs = /opt/module/flume/data/behavior1/
a1.channels.c1.maxFileSize = 2146435071
a1.channels.c1.capacity = 1000000
a1.channels.c1.keep-alive = 6
## sink1
a1.sinks.k1.type = hdfs
a1.sinks.k1.hdfs.path = /origin_data/gmall/log/topic_log/%Y-%m-%d
a1.sinks.k1.hdfs.filePrefix = log-
a1.sinks.k1.hdfs.round = false

a1.sinks.k1.hdfs.rollInterval = 10
a1.sinks.k1.hdfs.rollSize = 134217728
a1.sinks.k1.hdfs.rollCount = 0
## 控制输出文件是原生文件。
a1.sinks.k1.hdfs.fileType = CompressedStream
a1.sinks.k1.hdfs.codeC = lzop
## 拼装
a1.sources.r1.channels = c1
a1.sinks.k1.channel= c1

5.2.4 日志消费Flume启动停止脚本

1)在/home/molly/bin目录下创建脚本f2.sh

[molly@hadoop102 bin]$ vim f2.sh

​ 在脚本中填写如下内容

#! /bin/bash

case $1 in
"start"){
        for i in hadoop104
        do
                echo " --------启动 $i 消费flume-------"
                ssh $i "nohup /opt/module/flume/bin/flume-ng agent --conf-file /opt/module/flume/conf/kafka-flume-hdfs.conf --name a1 -Dflume.root.logger=INFO,LOGFILE >/opt/module/flume/log2.txt   2>&1 &"
        done
};;
"stop"){
        for i in hadoop104
        do
                echo " --------停止 $i 消费flume-------"
                ssh $i "ps -ef | grep kafka-flume-hdfs | grep -v grep |awk '{print \$2}' | xargs -n1 kill"
        done

};;
esac

2)增加脚本执行权限

[molly@hadoop102 bin]$ chmod u+x f2.sh

3)f2集群启动脚本

[molly@hadoop102 module]$ f2.sh start

4)f2集群停止脚本

[molly@hadoop102 module]$ f2.sh stop

5.3 项目经验之Flume内存优化

1)问题描述:如果启动消费Flume抛出如下异常

ERROR hdfs.HDFSEventSink: process failed

java.lang.OutOfMemoryError: GC overhead limit exceeded

2)解决方案步骤:

(1)在hadoop102服务器的/opt/module/flume/conf/flume-env.sh文件中增加如下配置

export JAVA_OPTS=”-Xms100m -Xmx2000m -Dcom.sun.management.jmxremote”

(2)同步配置到hadoop103、hadoop104服务器

[molly@hadoop102 conf]$ xsync flume-env.sh

3)Flume内存参数设置及优化

JVM heap一般设置为4G或更高

-Xmx与-Xms最好设置一致,减少内存抖动带来的性能影响,如果设置不一致容易导致频繁fullgc。

-Xms表示JVM Heap(堆内存)最小尺寸,初始分配;-Xmx 表示JVM Heap(堆内存)最大允许的尺寸,按需分配。如果不设置一致,容易在初始化时,由于内存不够,频繁触发fullgc。

5.4 采集通道启动/停止脚本

5.4.1 数据通道测试

根据需求分别生成2020-06-14和2020-06-15日期的数据

1)修改/opt/module/applog/application.yml中业务日期为2020-06-14

#业务日期

mock.date=2020-06-14

2)执行脚本,生成2020-06-14日志数据

[molly@hadoop102 ~]$ lg.sh

3)再次修改/opt/module/applog/application.yml中业务日期2020-06-15

#业务日期

mock.date=2020-06-15

4)执行脚本,生成2020-06-15日志数据

[molly@hadoop102 ~]$ lg.sh

5)在这个期间,不断观察Hadoop的HDFS路径上是否有数据

​ 1637740975327

5.4.2 采集通道启动/停止脚本

1)在/home/molly/bin目录下创建脚本cluster.sh

[molly@hadoop102 bin]$ vim cluster.sh

在脚本中填写如下内容

#!/bin/bash
case $1 in
"start"){
        echo ================== 启动 集群 ==================
        #启动 Zookeeper集群
        zk.sh start
        #启动 Hadoop集群
        hdp.sh start
        #启动 Kafka采集集群
        kf.sh start
        #启动 Flume采集集群
        f1.sh start
        #启动 Flume消费集群
        f2.sh start
        };;
"stop"){
        echo ================== 停止 集群 ==================

        #停止 Flume消费集群
        f2.sh stop
        #停止 Flume采集集群
        f1.sh stop
        #停止 Kafka采集集群
        kf.sh stop
        #停止 Hadoop集群
        hdp.sh stop
        #停止 Zookeeper集群
        zk.sh stop
};;
esac

2)增加脚本执行权限

[molly@hadoop102 bin]$ chmod u+x cluster.sh

3)cluster集群启动脚本

[molly@hadoop102 module]$ cluster.sh start

4)cluster集群停止脚本

[molly@hadoop102 module]$ cluster.sh stop

6 项目2 采集业务数据

6.1 电商业务流程

电商的业务流程可以以一个普通用户的浏览足迹为例进行说明,用户点开电商首页开始浏览,可能会通过分类查询也可能通过全文搜索寻找自己中意的商品,这些商品无疑都是存储在后台的管理系统中的。

当用户寻找到自己中意的商品,可能会想要购买,将商品添加到购物车后发现需要登录,登录后对商品进行结算,这时候购物车的管理和商品订单信息的生成都会对业务数据库产生影响,会生成相应的订单数据和支付数据。

订单正式生成之后,还会对订单进行跟踪处理,直到订单全部完成。

电商的主要业务流程包括用户前台浏览商品时的商品详情的管理,用户商品加入购物车进行支付时用户个人中心&支付服务的管理,用户支付完成后订单后台服务的管理,这些流程涉及到了十几个甚至几十个业务数据表,甚至更多。

6.2 电商常识

6.2.1 SKU和SPU

SKU=Stock Keeping Unit(库存量基本单位)。现在已经被引申为产品统一编号的简称,每种产品均对应有唯一的SKU号。

SPU(Standard Product Unit):是商品信息聚合的最小单位,是一组可复用、易检索的标准化信息集合。

例如:iPhoneX手机就是SPU。一台银色、128G内存的、支持联通网络的iPhoneX,就是SKU。

SPU表示一类商品。同一SPU的商品可以共用商品图片、海报、销售属性等。

6.2.2 平台属性和销售属性

1.平台属性

1637745317255

2.销售属性

1637745332754

6.3 业务数据采集架构

从2.2.2可以看到整体架构;对于需求2 采集业务数据的结构图如下所示:

1637746045465

业务数据库是直接存储到mysql数据库的,我们可以通过sqoop组件使用JDBC将数据传输到HDFS上存储。

sqoop安装教程见:

Hive安装教程见:

6.4 同步策略

数据同步策略的类型包括:全量同步、增量同步、新增及变化同步、特殊情况

Ø 全量表:存储完整的数据。

Ø 增量表:存储新增加的数据。

Ø 新增及变化表:存储新增加的数据和变化的数据。

Ø 特殊表:只需要存储一次。

6.4.1 全量同步策略

​ 1637746273106

6.4.2 增量同步策略

1637746298966

6.4.3 新增及变化策略

1637746311874

6.4.4 特殊策略

某些特殊的表,可不必遵循上述同步策略。

例如没变化的客观世界的数据(比如性别,地区,民族,政治成分,鞋子尺码)可以只存一份。

6.5 业务数据导入HDFS

6.5.1 分析表同步策略

在生产环境,个别小公司,为了简单处理,所有表全量导入。

中大型公司,由于数据量比较大,还是严格按照同步策略导入数据。

​ 1637746489890

6.5.2 业务数据首日同步脚本

1)脚本编写

(1)在/home/atguigu/bin目录下创建

[molly@hadoop102 bin]$ vim mysql_to_hdfs_init.sh

添加如下内容:

#! /bin/bash
APP=gmall
sqoop=/opt/module/sqoop/bin/sqoop
# 如果是输入的日期按照取输入日期;如果没输入日期取当前时间的前一天
if [ -n "$2" ] ;then
   do_date=$2
else 
   echo "请传入日期参数"
   exit
fi 
import_data(){
$sqoop import \
--connect jdbc:mysql://hadoop102:3306/$APP \
--username root \
--password 123456 \
--target-dir /origin_data/$APP/db/$1/$do_date \
--delete-target-dir \
--query "$2 where \$CONDITIONS" \
--num-mappers 1 \
--fields-terminated-by '\t' \
--compress \
--compression-codec lzop \
--null-string '\\N' \
--null-non-string '\\N'

hadoop jar /opt/module/hadoop-3.1.3/share/hadoop/common/hadoop-lzo-0.4.20.jar com.hadoop.compression.lzo.DistributedLzoIndexer /origin_data/$APP/db/$1/$do_date
}
import_order_info(){
  import_data order_info "select
                            id, 
                            total_amount, 
                            order_status, 
                            user_id, 
                            payment_way,
                            delivery_address,
                            out_trade_no, 
                            create_time, 
                            operate_time,
                            expire_time,
                            tracking_no,
                            province_id,
                            activity_reduce_amount,
                            coupon_reduce_amount,                            
                            original_total_amount,
                            feight_fee,
                            feight_fee_reduce      
                        from order_info"
}

6.5.3 项目经验

Hive中的Null在底层是以“\N”来存储,而MySQL中的Null在底层就是Null,为了保证数据两端的一致性。在导出数据时采用–input-null-string和–input-null-non-string两个参数。导入数据时采用–null-string和–null-non-string。

6.6 Hive进行业务数据访问

Hive安装教程详见:https://m01ly.github.io/2020/11/14/bigdata-hive1/

后面就是通过Hive去对数据进行初步的分析。

sqoop安装教程

1 下载并解压

1)下载地址:http://mirrors.hust.edu.cn/apache/sqoop/1.4.6/

2)上传安装包sqoop-1.4.6.bin__hadoop-2.0.4-alpha.tar.gz到hadoop102的/opt/software路径中

3)解压sqoop安装包到指定目录,如:

[molly@hadoop102 software]$ tar -zxf sqoop-1.4.6.bin__hadoop-2.0.4-alpha.tar.gz -C /opt/module/

4)解压sqoop安装包到指定目录,如:

[molly@hadoop102 module]$ mv sqoop-1.4.6.bin__hadoop-2.0.4-alpha/ sqoop

2 修改配置文件

  1. 进入到/opt/module/sqoop/conf目录,重命名配置文件
[molly@hadoop102 conf]$ mv sqoop-env-template.sh sqoop-env.sh
  1. 修改配置文件
[molly@hadoop102 conf]$ vim sqoop-env.sh 

增加如下内容

export HADOOP_COMMON_HOME=/opt/module/hadoop-3.1.3
export HADOOP_MAPRED_HOME=/opt/module/hadoop-3.1.3
export HIVE_HOME=/opt/module/hive
export ZOOKEEPER_HOME=/opt/module/zookeeper-3.5.7
export ZOOCFGDIR=/opt/module/zookeeper-3.5.7/conf

3 拷贝JDBC驱动

1)将mysql-connector-java-5.1.48.jar 上传到/opt/software路径

2)进入到/opt/software/路径,拷贝jdbc驱动到sqoop的lib目录下。

[molly@hadoop102 software]$ cp mysql-connector-java-5.1.48.jar /opt/module/sqoop/lib/

4 验证Sqoop

我们可以通过某一个command来验证sqoop配置是否正确:

[molly@hadoop102 sqoop]$ bin/sqoop help
Available commands:
  codegen            Generate code to interact with database records
  create-hive-table     Import a table definition into Hive
  eval               Evaluate a SQL statement and display the results
  export             Export an HDFS directory to a database table
  help               List available commands
  import             Import a table from a database to HDFS
  import-all-tables     Import tables from a database to HDFS
  import-mainframe    Import datasets from a mainframe server to HDFS
  job                Work with saved jobs
  list-databases        List available databases on a server
  list-tables           List available tables in a database
  merge              Merge results of incremental imports
  metastore           Run a standalone Sqoop metastore
  version            Display version information

5 测试Sqoop是否能够成功连接数据库

[molly@hadoop102 sqoop]$ bin/sqoop list-databases --connect jdbc:mysql://hadoop102:3306/ --username root --password 000000
information_schema
metastore
mysql
oozie
performance_schema